Начало года самое время для прогнозов и предсказаний. В этом посте я собрал обзор трендов в области аналитики и систем обработки данных на 2015 год.
Читать полностью »
Начало года самое время для прогнозов и предсказаний. В этом посте я собрал обзор трендов в области аналитики и систем обработки данных на 2015 год.
Читать полностью »

Представляю вашему вниманию очередной выпуск обзора наиболее интересных материалов, посвященных теме анализа данных и машинного обучения.
Читать полностью »
Представляю вашему вниманию очередной выпуск обзора наиболее интересных материалов, посвященных теме анализа данных и машинного обучения.
Читать полностью »
Друзья, под закат уходящего 2014 года и начала 2015 есть отличная новость для всех кто любит работать с открытыми данными, участвовать в конкурсах для разработчиков.
А также, я уверен, что есть и те кто любит историю и исторические данные.
С 23 декабря Минфин России с нашей помощью Информационной культуры открывает конкурс приложений BudgetApps http://budgetapps.ru/contest на открытых данных которые Минфин России публиковал последние несколько лет.
Данные самые разные. Это данные о бюджетах, данные об аудиторских организациях, государственном долге, государственных резервах и многое другое.
Ну и, так оказалось, что меня зовут Иван Бегтин и я член жюри этого конкурса.
Все они есть по ссылке на сайте Минфина — http://minfin.ru/ru/opendata/
И много бюджетных данных есть на Едином портале бюджетной системы — http://budget.gov.ru/data/opendata там есть структура бюджета в CSV формате, сами данные, справочники и многое и многое другое. А также данные по всем официальным учреждениям вот тут http://bus.gov.ru/public/opendata.html. На этот ресурс обратите особое внимание. Там опубликованы индикаторы, бюджеты, уставы и многое другое по каждой государственной организации и муниципальном учреждении в России. Если Вы задумаете любой региональный проект, то эти данные будут просто бесценны.
Это не значит, что нельзя использовать какие-либо другие данные, безусловно можно и нужно, однако поскольку это конкурс Минфина России, то конечно ожидается что другие данные будут использоваться вместе с этими.
Я лично считаю, что не стоит ограничиваться только теми данными которые уже переведены в машиночитаемый вид. Есть также данные которые можно превратить в открытые данные самостоятельно.
Многие умеют писать парсеры, но для тех кто этого не делал раньше, хорошее подпорье может быть ScraperWiki (https://scraperwiki.com/) чтобы собрать информацию со страниц, а также разные библиотеки для разбора Excel файлов, извлечение таблиц из PDF документов — с помощью pdftables.com/ или сервисов Abbyy или их Abbyy Finereader.
На сайте и других ресурсах Минфина кроме данных есть множество другого интересного что можно превратить в данные. Начиная просто от новостей которые стали особенно актуальны в последние дни, продолжая всем остальным.
Оригинал статьи 13.12.2014. Джон Эванс, Колумнист TechCrunch.
Базы данных — это хребет ИТ индустрии: невоспеты, невидимы, но критичны. И крайне пагубны когда они ломаются или деформируются. Это делает специалистов по БД осторожными. Годами только лишь Большая Троица — Oracle, IBM DB2, и может быть SQL Server — были единственными серьёзными опциями. Потом open source альтернативы — MySQL, ProstgreSQL — стали жизнеспособным. А потом, в течение последних пяти лет, всё стало очень интересно…
Читать полностью »
В статистике и анализе данных подразумевается, что все значения являются действительными числами (векторами действительных чисел) или с легкостью могут быть к ним сведены. А вот, например, в непараметрической и нечисловой статистике, а также в эконометрике весьма важно на какой шкале взяты данные, чтоб понимать, какие операции и методы с ними применимы.
Проблема с определением шкал еще состоит в том, что их строят математики, строго формализуя, что делает ее непонятной большинству. Например, в классической книге Пфанцагля шкалы определяются так:
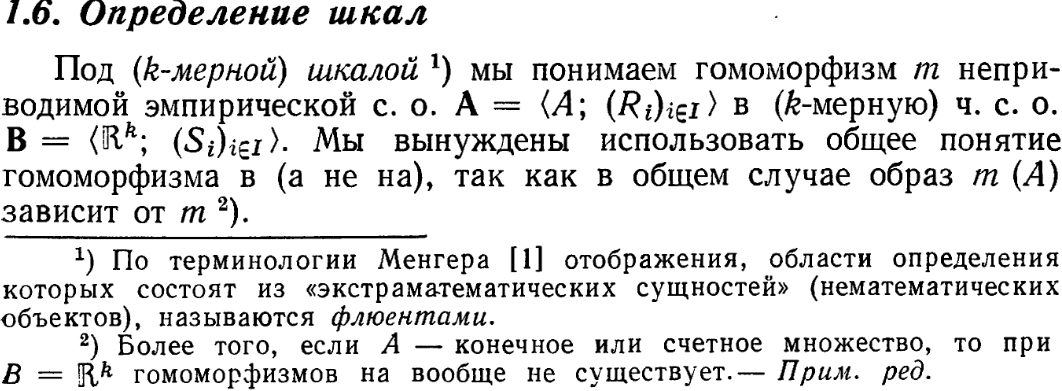
Где с. о. – система с отношениями, а ч. с. о. – числовая с. о., те же самые которые используются в алгебре и теории нормальных форм реляционных баз данных. Если вам это просто и понятно, можете дальше не читать, для остальных далее я расскажу про шкалы просто и понятно и обосную важность понимания данного материала.
Читать полностью »
Представляю вашему вниманию очередной выпуск обзора наиболее интересных материалов, посвященных теме анализа данных и машинного обучения.
Читать полностью »

Рис. 3. – Книги каких авторов из рейтинга топ100 читают пользователи Вконтакте
Для всех диаграмм в статье есть интерактивные визуализации: graphgrail.com/gg-client/vk_books.html
К 2014 году потенциал традиционных подходов к развитию аналитики социальных процессов оказался исчерпан в силу нескольких причин, главная из которых – неспособность созданных в рамках данных подходов решений адаптироваться к изменившимся условиям формирования общественных законов. Речь идет об их недостаточной динамичности и неприспособленности для обработки данных, поступающих в больших объемах в режиме времени, близком к реальному. Но самый серьезный удар по классической аналитике нанес взрывной рост объемов неструктурированных данных. [1]
Читать полностью »
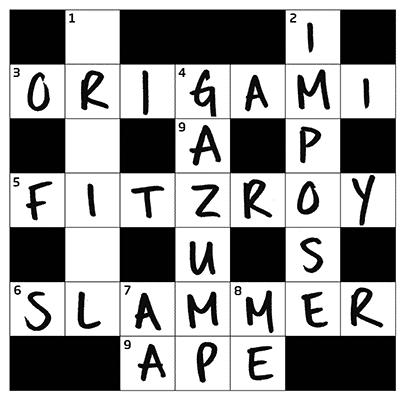
Разгадывать кроссворды — не такая простая задача для компьютера, потому что задачи формулируются расплывчато. С другой стороны, тезаурус упрощает задачу. Пример Deep Blue показывает, что программы ИИ могут участвовать в викторинах и обыгрывать людей. Почему не сделать то же самое с кроссвордами?
Американский разработчик Мэтью Гинсберг (Matthew Ginsberg) создал программу под названием Dr Fill, которая справляется с кроссвордами гораздо лучше, чем абсолютное большинство людей, пишет New Scientist.
Читать полностью »
Прошлые 15 лет Google работал над распознаванием паттернов в хаосе информации в сети, а теперь свои умения приложит к поиску генетических причин аутизма. Для этого будут обработаны геномы 10 000 человек с аутизмом и членов их семей.