
 Каждый день поступает все больше заказов, и их нужно как-то распределять по исполнителям. Вроде ничего сложного: пришёл заказ – отдай его клинеру. Но не всё так просто, как кажется. У наших клинеров нет фиксированного графика работы, они могут работать, когда захотят, отказываться практически от любых заказов (и это клинеры, увы, делают довольно часто). Поэтому распределение заказов – одна из самых сложных задач, над которой мы работаем.
Читать полностью »
Рубрика «machine learning» - 39
Как Qlean использует Machine Learning?
2018-04-28 в 12:31, admin, рубрики: assignments, machine learning, ml, qlean, Алгоритмы, бизнес-модели, Блог компании Qlean, градиентный бустинг, задача о назначениях, машинное обучениеMail.Ru Group на пятом московском Data Fest
2018-04-27 в 12:08, admin, рубрики: big data, data fest, data mining, data science, machine learning, mail.ru, mail.ru group, Блог компании Mail.Ru Group, визуализация данных, машинное обучение
Друзья, до самого долгожданного события года в сфере data science остался 1 день! 28 апреля состоится пятый московский Data Fest. Под катом наш рассказ о докладах и активностях Mail.Ru Group на конференции.
Читать полностью »
Splunk 7.1. Что нового? Новый веб интерфейс, интеграция с Apache Kafka и многое другое…
2018-04-27 в 5:13, admin, рубрики: machine learning, splunk, анализ данных, анализ логов, Блог компании TS Solution, кластеризация, логи, машинные данные, метрики, Серверная оптимизация, Серверное администрирование, системное администрирование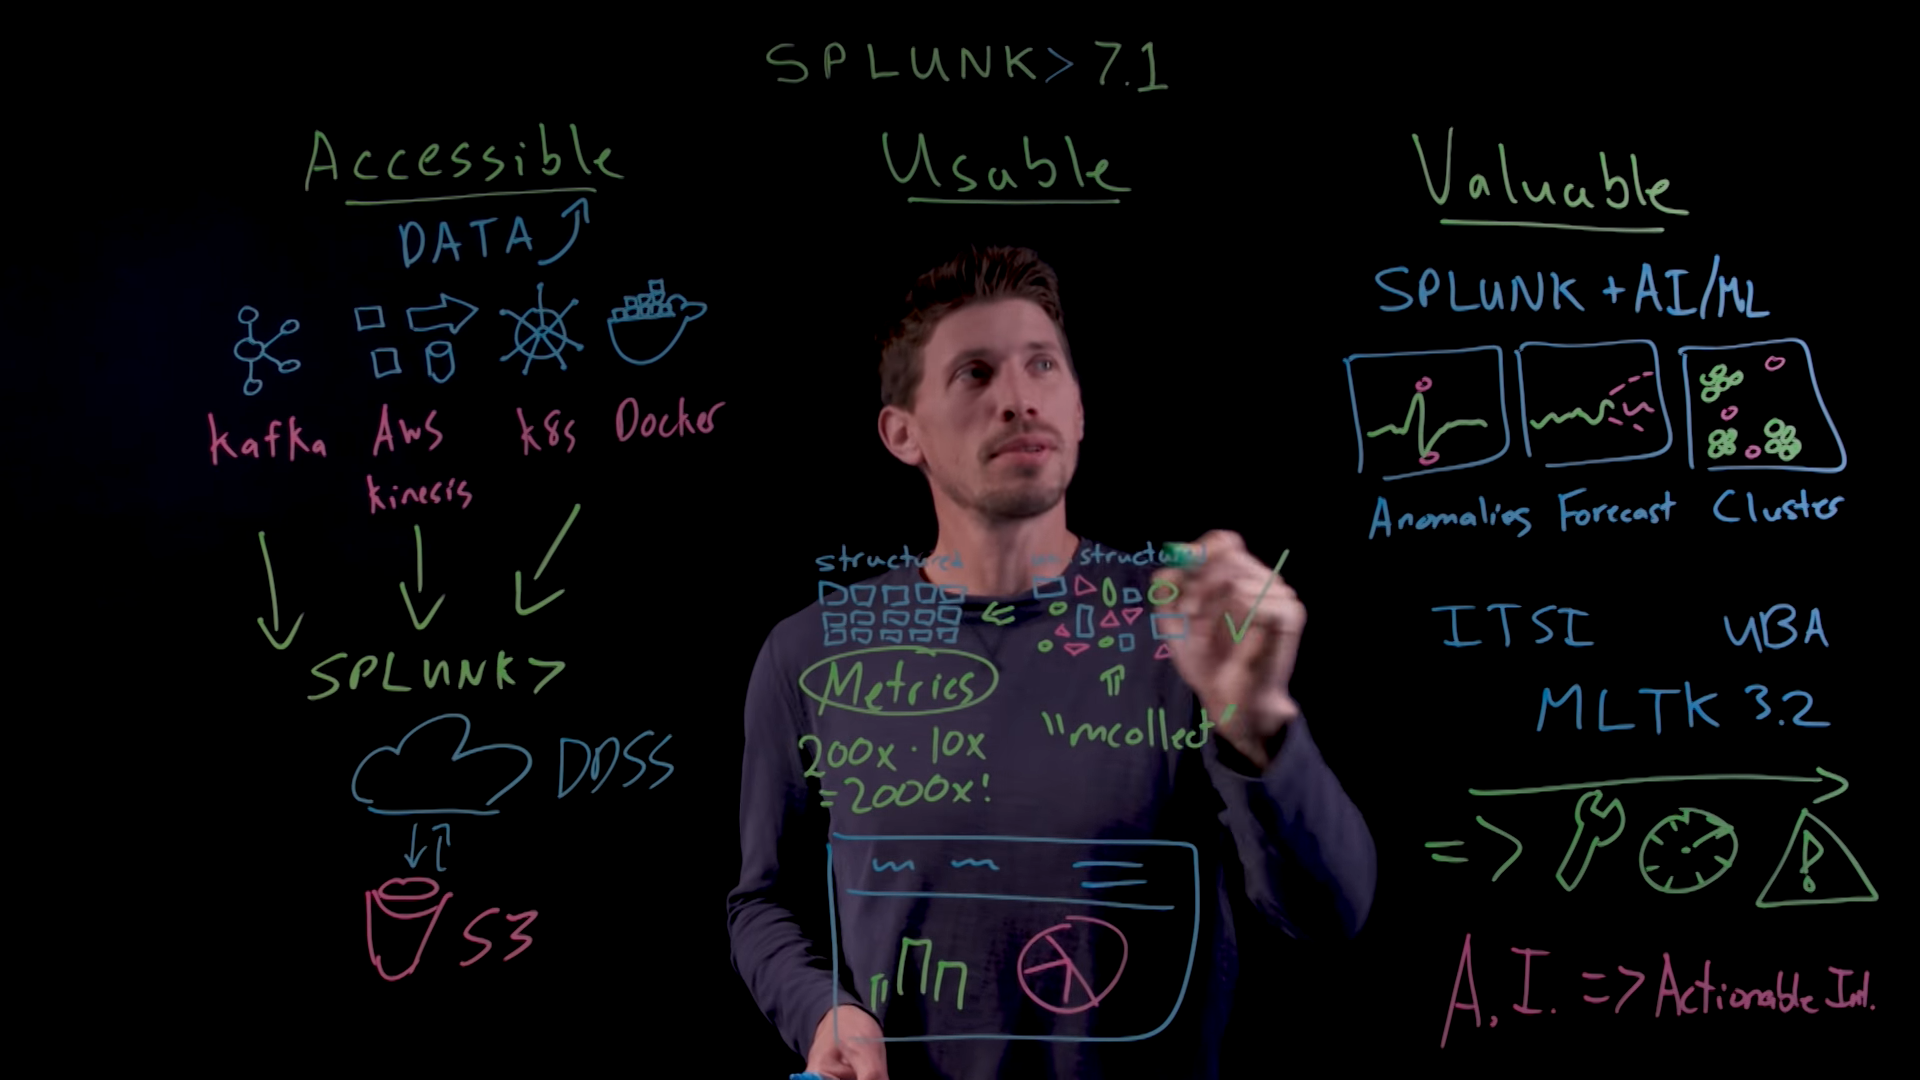
Несколько дней назад компания Splunk выпустила новый релиз своей платформы Splunk 7.1 в котором, наверно, произошло самое ожидаемое изменение за последние несколько лет — да, полностью изменился графический интерфейс. В этой статье мы расскажем об основных нововведениях и улучшениях платформы. Что еще нового помимо GUI? Смотрите под кат.
Читать полностью »
Самые страшные ошибки, которые допускают DS. Встреча в офисе Авито 24 апреля
2018-04-20 в 11:22, admin, рубрики: AI Community, data science, machine learning, Блог компании Avito, веб-аналитика, математика, машинное обучение, Учебный процесс в ITПривет! На следующей неделе, в среду, 24 апреля, приглашаем специалистов по Data Science на митап, который мы организуем вместе с AI Community и AI Today. Будем говорить о самых страшных ошибках, которые допускают DS. Подробно обсудим CRISP-DM и Tips&Tricks, которые можно использовать в работе. Вы услышите доклады Ивана Гуза, Игоря Слинько и Станислава Гафарова. Регистрируйтесь на встречу и приглашайте коллег. Под катом — тезисы выступлений, ссылки на регистрацию и видеотрансляцию митапа.
Data Fest 2018: анонс и регистрация
2018-04-19 в 14:19, admin, рубрики: big data, data fest, data mining, data science, machine learning, mail.ru, mail.ru group, Блог компании Mail.Ru Group, визуализация данных, машинное обучение
Друзья, приглашаем вас на пятый московский Data Fest, который состоится 28 апреля на территории дизайн-завода FLACON. Data Fest — крупнейшая бесплатная конференция для исследователей, инженеров и разработчиков, связанных с анализом и обработкой данных, машинным обучением, а также тем, что пресса любит называть AI.
Вы узнаете про AI в продуктах Mail.Ru Group и «умные» ответы в Почте Mail.Ru, как работают рекомендации и компьютерное зрение во ВКонтакте и Одноклассниках, а также машинный перевод в Alibaba и что такое Quantum Machine Learning, а также многое-многое другое!
Читать полностью »
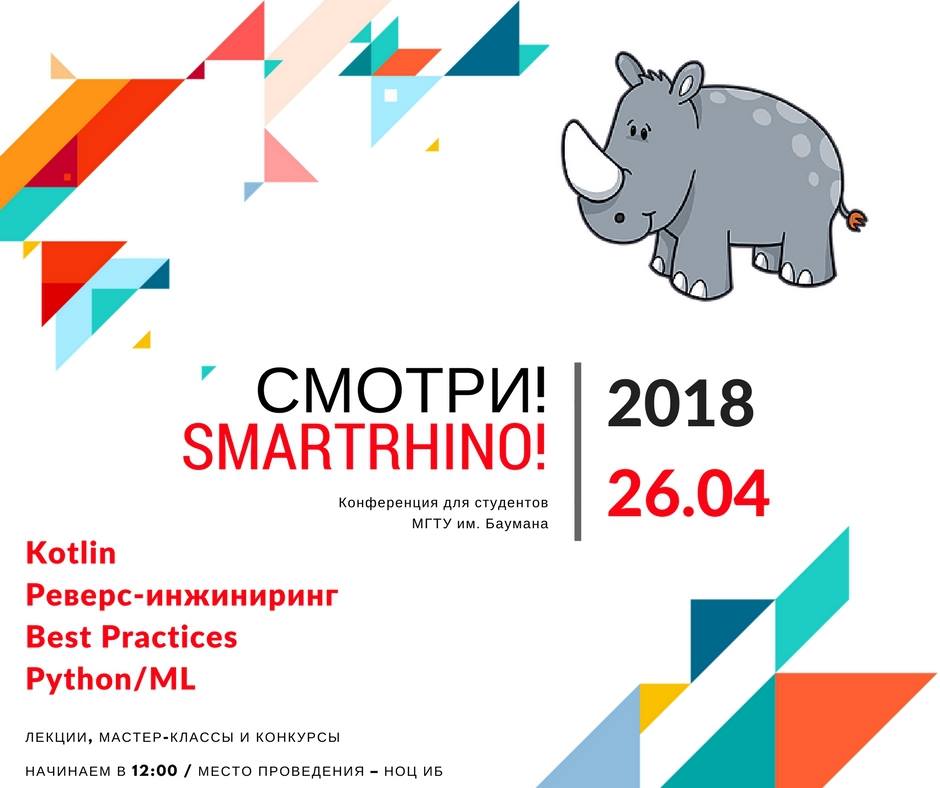
Конференция SMARTRHINO-2018
2018-04-19 в 13:47, admin, рубрики: best practices, kotlin, machine learning, python, Блог компании ИНФОРИОН, машинное обучение, мгту им.баумана, МГТУ имени Баумана, реверс-инжиниринг26 апреля в НОЦ ИБ МГТУ им.Баумана пройдет конференция для студентов SMARTRHINO-2018. Конференция будет посвящена 4 направлениям:
— Kotlin
— Реверс-инжиниринг
— Best Practices
— Machine Learning
Спикеры конференции — ведущие сотрудники Компании ИНФОРИОН. Активные участники получат ценные призы.
Подрорбная информация о спикарах и программе конференции представлена на сайте. Актуальная информация — в группе Telegram.
Пять мифов о Data Science
2018-04-11 в 10:14, admin, рубрики: big data, career, data mining, data science, machine learning, python, Блог компании ID Finance, Карьера в IT-индустрии, машинное обучениеМеня зовут Иван Серов, я работаю в департаменте Data Science финтех-компании ID Finance. Data scientist –довольно молодая, но очень востребованная профессия, которая обросла множеством мифов. В этом посте я расскажу о нескольких заблуждениях, с которыми сталкиваются начинающие дата-саентисты (DS).
Анализ данных — основы и терминология
2018-04-08 в 13:05, admin, рубрики: algorithms, big data, data mining, data science, machine learning, Алгоритмы, математика, машинное обучениеВ этой статье я бы хотел обсудить базовые принципы построения практического проекта по (т. н. «интеллектуальному») анализу данных, а также зафиксировать необходимую терминологию, в том числе русскоязычную.
Согласно википедии,
Анализ данных — это область математики и информатики, занимающаяся построением и исследованием наиболее общих математических методов и вычислительных алгоритмов извлечения знаний из экспериментальных (в широком смысле) данных; процесс исследования, фильтрации, преобразования и моделирования данных с целью извлечения полезной информации и принятия решений.
Говоря чуть более простым языком, я бы предложил понимать под анализом данных совокупность методов и приложений, связанных с алгоритмами обработки данных и не имеющих четко зафиксированного ответа на каждый входящий объект. Это будет отличать их от классических алгоритмов, например реализующих сортировку или словарь. Читать полностью »
Рубрика «Читаем статьи за вас». Февраль — Март 2018
2018-04-05 в 11:10, admin, рубрики: arxiv.org, data science, machine learning, ods, open data science, science, Алгоритмы, Блог компании Open Data Science, математика, машинное обучение, обработка изображений
Привет! Продолжаем публиковать рецензии на научные статьи от членов сообщества Open Data Science из канала #article_essense. Хотите получать их раньше всех — вступайте в сообщество!
Как решить 90% задач NLP: пошаговое руководство по обработке естественного языка
2018-04-05 в 9:10, admin, рубрики: big data, machine learning, nlp, word2vec, анализ данных, Блог компании Конференции Олега Бунина (Онтико), классификатор текстов, машинное обучениеНеважно, кто вы — зарекомендовавшая себя компания, или же только собираетесь запустить свой первый сервис — вы всегда можете использовать текстовые данные для того, чтобы проверить ваш продукт, усовершенствовать его и расширить его функциональность.
Обработкой естественного языка (NLP) называется активно развивающаяся научная дисциплина, занимающаяся поиском смысла и обучением на основании текстовых данных.
Как вам может помочь эта статья
За прошедший год команда Insight приняла участие в работе над несколькими сотнями проектов, объединив знания и опыт ведущих компаний в США. Результаты этой работы они обобщили в статье, перевод которой сейчас перед вами, и вывели подходы к решению наиболее распространенных прикладных задач машинного обучения.
Мы начнем с самого простого метода, который может сработать — и постепенно перейдем к более тонким подходам, таким как feature engineering, векторам слов и глубокому обучению.
После прочтения статьи, вы будете знать, как:
- осуществлять сбор, подготовку, и инспектирование данных;
- строить простые модели, и осуществлять при необходимости переход к глубокому обучению;
- интерпретировать и понимать ваши модели, чтобы убедиться, что вы интерпретируете информацию, а не шум.
Пост написан в формате пошагового руководства; также его можно рассматривать в качестве обзора высокоэффективных стандартных подходов.
Читать полностью »