
Мотивированный статьей пользователя BubaVV про предсказание веса модели Playboy по ее формам и росту, автор решил углубиться if you now what I mean в эту будоражащую кровь тему исследования и в тех же данных найти выбросы, то есть особо сисястые модели, выделяющиеся на фоне других своими формами, ростом или весом. А на фоне этой разминки чувства юмора заодно немного рассказать начинающим исследователям данных про обнаружение выбросов (outlier detection) и аномалий (anomaly detection) в данных с помощью реализации одноклассовой машины опорных векторов (One-class Support Vector Machine) в библиотеке Scikit-learn, написанной на языке Python.
Рубрика «machine learning» - 62
Необычные модели Playboy, или про обнаружение выбросов в данных c помощью Scikit-learn
2015-02-23 в 0:15, admin, рубрики: anomaly detection, data mining, machine learning, outlier detection, pandas, PCA, python, scikit-learn, unsupervised learning, АлгоритмыОбзор наиболее интересных материалов по анализу данных и машинному обучению №36 (16 — 22 февраля 2015)
2015-02-22 в 13:51, admin, рубрики: big data, data mining, data science, data science digest, high scalability, machine learning, машинное обучение 
Представляю вашему вниманию очередной выпуск обзора наиболее интересных материалов, посвященных теме анализа данных и машинного обучения.
Читать полностью »
Седьмая ежегодная Летняя школа Microsoft Research. На этот раз про машинное обучение и интеллект
2015-02-16 в 9:09, admin, рубрики: big data, machine learning, microsoft, Microsoft Azure, microsoft research, Алгоритмы, Блог компании Microsoft, летняя школа, машинное обучение, наука, школаПривет!
29 июля, в очередной, уже седьмой раз, в Санкт-Петербурге откроется ежегодная Летняя школа Microsoft Research. На этот раз тема школы – машинное обучение и интеллект. В программу школы включены лекции и семинары ученых мирового уровня из ведущих университетов со всего мира, в том числе из России, а также исследователей Microsoft Research. Руководитель школы – Эвелин Виегас, директор направления «семантические вычисления» Microsoft Research Redmond. Подробности под катом.

Машинное обучение — 1. Корреляция и регрессия. Пример: конверсия посетителей сайта
2015-02-15 в 19:06, admin, рубрики: machine learning, statistical learning, Блог компании Нерепетитор.ру, визуализация данных, конверсия сайтов, корреляция, линейная регрессия, математика, математика и реальная жизнь, машинное обучение, метод наименьших квадратов, монте-карло, статистикаКак и обещал, начинаю цикл статей по «машинному обучению». Эта будет посвящена таким понятиям из статистики, как корреляция случайных величин и линейная регрессия. Рассмотрим, как реальные данные, так и модельные (симуляцию Монте-Карло).
Часть 1. Реальные данные
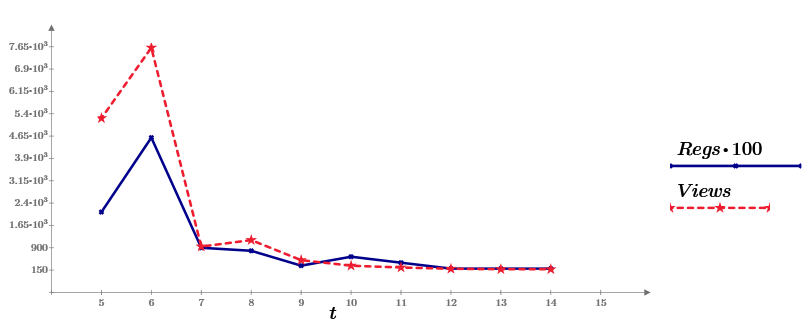
Чтобы было интереснее, рассказ построен на примерах, причем в качестве данных (и в этой, и в следующих, статьях) я буду стараться брать статистику прямо отсюда, с Хабра. А именно, неделю назад я написал свою первую статью на Хабре (про Mathcad Express, в котором и будем все считать). И вот теперь статистику по ее просмотрам за 10 дней и предлагаю в качестве исходных данных. На графике это ряд Views, синяя линия. Второй ряд данных (Regs, с коэффициентом 100) показывает число читателей, выполнивших после прочтения определенное действие (регистрацию и скачивание дистрибутива Mathcad Prime).
Обзор наиболее интересных материалов по анализу данных и машинному обучению №35 (9 — 15 февраля 2015)
2015-02-15 в 12:03, admin, рубрики: big data, data mining, data science, data science digest, high scalability, machine learning 
Представляю вашему вниманию очередной выпуск обзора наиболее интересных материалов, посвященных теме анализа данных и машинного обучения.
Читать полностью »
Обзор наиболее интересных материалов по анализу данных и машинному обучению №34 (2 — 8 февраля 2015)
2015-02-09 в 13:53, admin, рубрики: big data, data mining, data science, data science digest, high scalability, machine learning 
Представляю вашему вниманию очередной выпуск обзора наиболее интересных материалов, посвященных теме анализа данных и машинного обучения.
Читать полностью »
Пример Feature Engineering в машинном обучении
2015-02-04 в 20:46, admin, рубрики: big data, data mining, kaggle, machine learning, python, Алгоритмы, разработка, метки: Big Data, Data Mining, Kaggle, Machine Learning, PythonПривет!
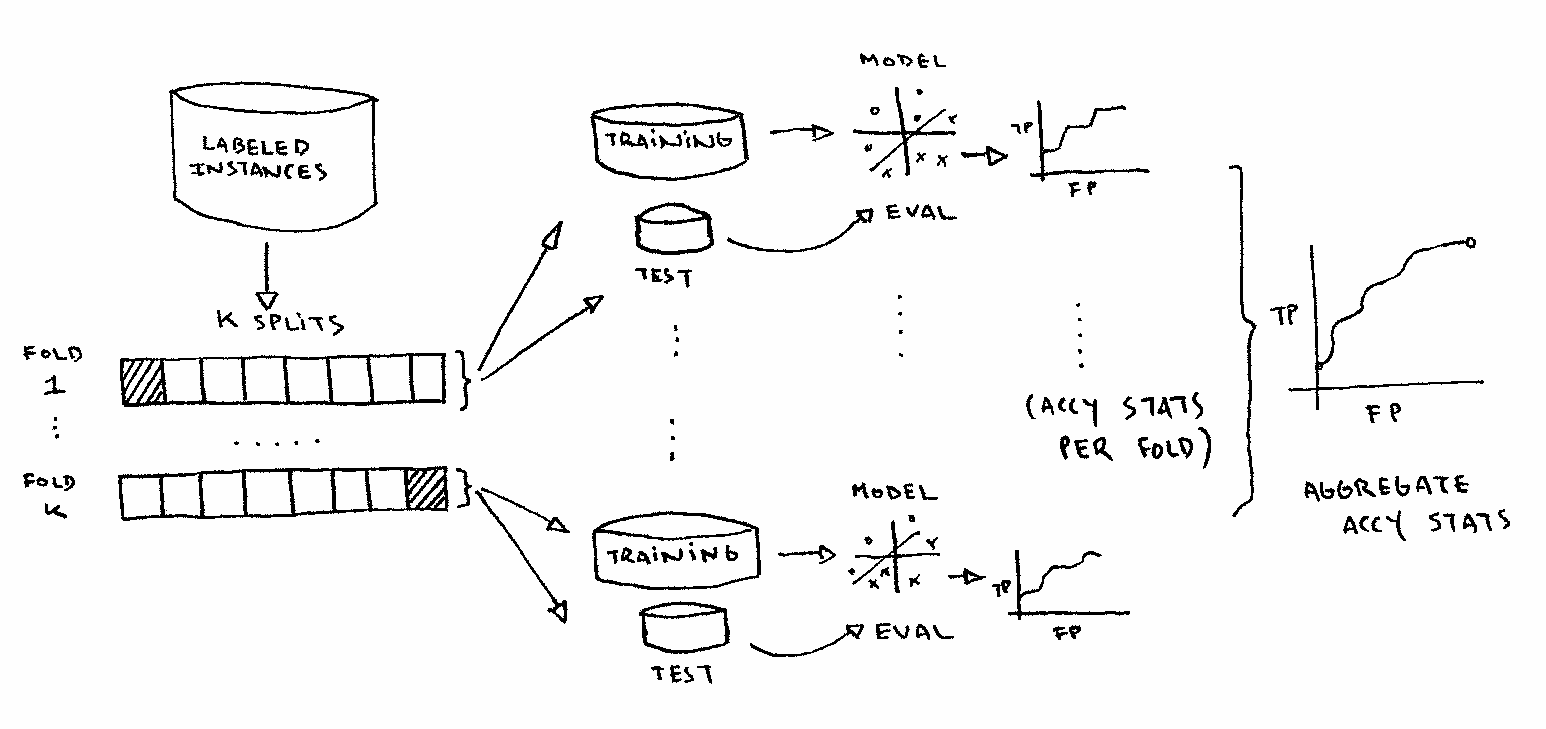
В одной из прошлых статей мы познакомились с таким понятием как Feature Engineering и применением его на практике. В комментариях было озвучено пожелание показать на примере, как искусство генерации признаков помогает заметно улучшить качество алгоритмов машинного обучения. Я поискал задачи, в которых бы это можно было наглядно продемонстрировать и нашел один хороший пример. Это задача Forest Cover Type Prediction. Покажем, как можно применяя простые идеи, не содержащие в себе машинное обучение, сразу попасть в топ 10% Leader Board!
Читать полностью »
Обзор наиболее интересных материалов по анализу данных и машинному обучению №33 (26 января — 1 февраля 2015)
2015-02-01 в 12:55, admin, рубрики: big data, data mining, data science, data science digest, machine learning 
Представляю вашему вниманию очередной выпуск обзора наиболее интересных материалов, посвященных теме анализа данных и машинного обучения.
Читать полностью »
Обзор обновлений платформы Microsoft Azure за январь
2015-01-27 в 7:27, admin, рубрики: azure, azuredigest, iaas, machine learning, Microsoft Azure, Visual Studio, vpn, web sites, Блог компании Microsoft В дайджесте новостей облачной платформы Microsoft Azure собраны основные анонсы и контент для разработчиков, ИТ-профессионалов и всех специалистов, интересующихся облачными технологиями и платформой Azure. Предыдущие выпуски дайджеста можно всегда найти по следующей ссылке. Этот дайджест совсем короткий :-)
Читать полностью »
Когда данных действительно много: Vowpal Wabbit
2015-01-25 в 16:59, admin, рубрики: big data, data mining, machine learning, python, разработкаПривет!
В предыдущих двух постах (раз, два) мы расмотрели основные алгоритмы и техники, применяющиеся участниками соревнований Kaggle. Сегодня хотелось бы пойти дальше и поговорить про то, с какими трудностями встречаются исследователи при разработке алгоритмов в случае, когда данных очень много и обучаться приходится на выборках, которые не помещаются в память. Сразу стоит отметить, что это происходит довольно часто, даже на самом Kaggle (в данной задаче обучающая выборка имеет обьем в несколько гигабайт и новичку может быть просто не понятно, что с этим делать). Ниже мы рассмотрим алгоритмы машинного обучения и инструменты, справляющиеся с данной проблемой.
Читать полностью »