Рубрика «prometheus» - 6

Масштабирование приложения в Kubernetes на основе метрик из Prometheus - 1

Распространённая ситуация: у вас есть несколько приложений, у одного из них пиковая нагрузка приходится на дневное время, а в другие часы к нему никто не обращается (либо обращаются, но редко); при этом другим приложениям мощности кластера могут пригодиться и в ночное время. В качестве примера таких приложений можно привести веб-сервисы, какие-нибудь обработчики данных.

Как обычно, ресурсов кластера на всех не хватает. Приходится что-то придумывать для оптимизации использования ресурсов, и Kubernetes отлично для этого подходит. В нём есть Horizontal Pod Autoscaler, который позволяет масштабировать приложения на основе метрик.

Масштабирование приложения в Kubernetes на основе метрик из Prometheus - 2

Метрики обычно поставляются метрик-сервером. Дальше я расскажу о замене метрик-сервера Prometheus’ом (потому что Prometheus реализует в себе данные, которые отдаются метрик-сервером и мы избавляемся от одного лишнего звена) и о том, как на основе метрик из Prometheus масштабировать свои приложения в Kubernetes.
Читать полностью »
Micrometer используется для сбора метрик приложения JVM и позволяет экспортировать данные в различные системы мониторинга. В этой статье я расскажу, как подключить Micrometer для spring web приложения и экспортировать данные в Prometheus (хороший пост о нем). Так как мое приложение написано на Spring 3, то возможности использовать Spring boot без апгрейда в нем нет. Поэтому придется поработать руками.
Читать полностью »

Для начала подготовим виртуальную машину, для этого напишем небольшой скрипт, который разворачивает и автоматизирует некоторые рутинные операции, скрипт использует Azure Cli:

project.sh

#!/bin/bash
echo "AZURE VM Create"
echo "Azure Account:"
echo "Azure name:"
read AZ_NAME
read -sp "Azure password: " AZ_PASS && echo && az login -u $AZ_NAME -p $AZ_PASS
echo "Name Group  VM"
read GROUP_NAME
az group create --name $GROUP_NAME --location eastus
echo "VM name"
read VM
echo "Admin user name"
read ADMIN
az vm create --resource-group $GROUP_NAME --name $VM --image UbuntuLTS --admin-username $ADMIN --generate-ssh-keys --custom-data cloud-init.txt
az vm open-port --resource-group $GROUP_NAME --name $VM --port 8080 --priority 1001
az vm open-port --resource-group $GROUP_NAME --name $VM --port 8081 --priority 1002
az vm open-port --resource-group $GROUP_NAME --name $VM --port 9090 --priority 1003
az vm open-port --resource-group $GROUP_NAME --name $VM --port 9093 --priority 1004
az vm open-port --resource-group $GROUP_NAME --name $VM --port 9100 --priority 1005
az vm open-port --resource-group $GROUP_NAME --name $VM --port 3000 --priority 1006
RESULT=$(az vm show --resource-group $GROUP_NAME --name $VM -d --query [publicIps] --o tsv)
echo $RESULT
echo "Whait 5 min"
sleep 300
ssh $ADMIN@$RESULT -y << EOF
sudo usermod -aG docker $ADMIN
EOF
sleep 10
echo "Connect to Azure..."

В скрипте мы используем файл cloud-init.txt который автоматически установит Docker и Docker-Compose на виртуальную машину.

cloud-init.txt

#cloud-config
package_upgrade: true
write_files:
  - path: /etc/systemd/system/docker.service.d/docker.conf
    content: |
      [Service]
        ExecStart=
        ExecStart=/usr/bin/dockerd
  - path: /etc/docker/daemon.json
    content: |
      {
        "hosts": ["fd://","tcp://127.0.0.1:2375"]
      }
runcmd:
- apt-get update && apt-get install mc -y
- curl -sSL https://get.docker.com/ | sh
- curl -L "https://github.com/docker/compose/releases/download/1.23.2/docker-compose-$(uname -s)-$(uname -m)" -o /usr/local/bin/docker-compose
chmod +x /usr/local/bin/docker-compose

Читать полностью »

В предыдущей статье я рассказал про механизм DiagnosticSource и на простом примере показал, как с его помощью можно перехватывать запросы в базу данных через классы SqlConnection и SqlCommand и измерять время их выполнения.

В настоящее время DiagnosticSource уже используется в AspNetCore, EntityFrameworkCore, HttpClient и SqlClient — каждый из них отправляет собственные события, которые могут быть перехвачены и обработаны.

В этой статье я хочу рассмотреть несколько примеров того, как можно на практике использовать DiagnosticSource в приложениях ASP.NET Core.

  • CorrelationID и пробрасывание заголовков между сервисами
  • Сбор метрик и трассировок
  • Логирование

Кроме того, в этой статье я решил собрать список событий, которые доступны для обработки и могут быть использованы в ваших приложениях, а также рассказать о некоторых подводных камнях, с которыми вы можете столкнуться, если решите использовать механизм DiagnosticSource в своём проекте.

Читать полностью »

Краткое знакомство с kubernetes для разработчиков на примере разворачивания простого шаблонного сайта, с постановкой его на мониторинг, выполнением джобов по расписанию и health checks (все исходники прилагаются)

— Установка Kubernetes
— Установка UI
— Запуск своего приложения в кластере
— Добавление кастомных метрик в приложение
— Сбор метрик через Prometheus
— Отображение метрик в Grafana
— Выполнение задач по расписанию
— Отказоустойчивость
— Выводы
— Заметки
— Список литературы
Читать полностью »

В Prometheus 2.6.0 оптимизирована загрузка WAL, что ускоряет процесс запуска.

Неофициальная цель разработки Prometheus 2.x TSDB — ускорить запуск, чтобы он занимал не более минуты. В последние месяцы появились сообщения о том, что процесс немного затягивается, и если Prometheus по какой-либо причине перезапускается, то это — уже проблема. Почти все это время загружается WAL (регистрация записи с упреждением), включающий образцы за последние несколько часов, которые еще предстоит сжать в блок. В конце октября мне, наконец, удалось разобраться в этом; результат — PR#440, снижающий время работы ЦПУ в 6,5 раз и время расчета в 4 раза. Рассмотрим, каким образом я добился этих улучшений.

image

Читать полностью »

Проверки работоспособности и постепенная деградация распределенных систем - 1

Как всегда, спасибо Фреду Хеберту и Саргуну Дхиллону за то, что прочли черновик этой статьи и предложили нескольких бесценных советов.

В своем докладе о скорости Тамар Берковичи из Box подчеркнула важность проверок работоспособности при автоматическом аварийном переключении баз данных. В частности, она отметила, что мониторинг времени выполнения сквозных запросов, как метод определения работоспособности базы данных, — лучше, чем простое эхо-тестирование (пингирование).

... перебрасывая трафик на другую ноду (реплику), чтобы устранить бездействие, надо построить средства защиты от дребезга и других пограничных ситуаций. Это не сложно. Фокус при организации эффективной работы в том, чтобы знать, когда перевести базу данных в первую позицию, т.е. надо быть в состоянии правильно оценить работоспособность базы данных. Сейчас многие параметры, на которые мы привыкли обращать внимание, — например, загрузка процессора, время ожидания блокировки, частота ошибок, — являются вторичными сигналами. Ни один из этих параметров на самом деле не говорит о способности базы данных к обработке клиентского трафика. Поэтому, если используете их для принятия решения о переключении, можете получить как ложноположительные, так и ложноотрицательные результаты. Наше устройство проверки работоспособности фактически выполняет простые запросы к узлам базы данных и использует данные о выполненных и невыполненных запросах для более точной оценки работоспособности базы данных.

Я обсудила это с другом, и он предположил, что проверки работоспособности должны быть предельно простыми, и что реальный трафик — это лучший критерий для оценки работоспособности процесса.

Читать полностью »

Вот и наступила осенне-зимняя пора. За окном дожди и желания проводить время на открытом воздухе все меньше и меньше. И вот приходит мне сообщение от товарища "А давай поиграем в Lineage 2?". И опять я, поддавшись ностальгии, согласился. Выбрали мы свеженький сервер на ру-офе и создали персонажей.

Жадный гном: Как я писал аналитику рынка в Lineage 2 - 1

 
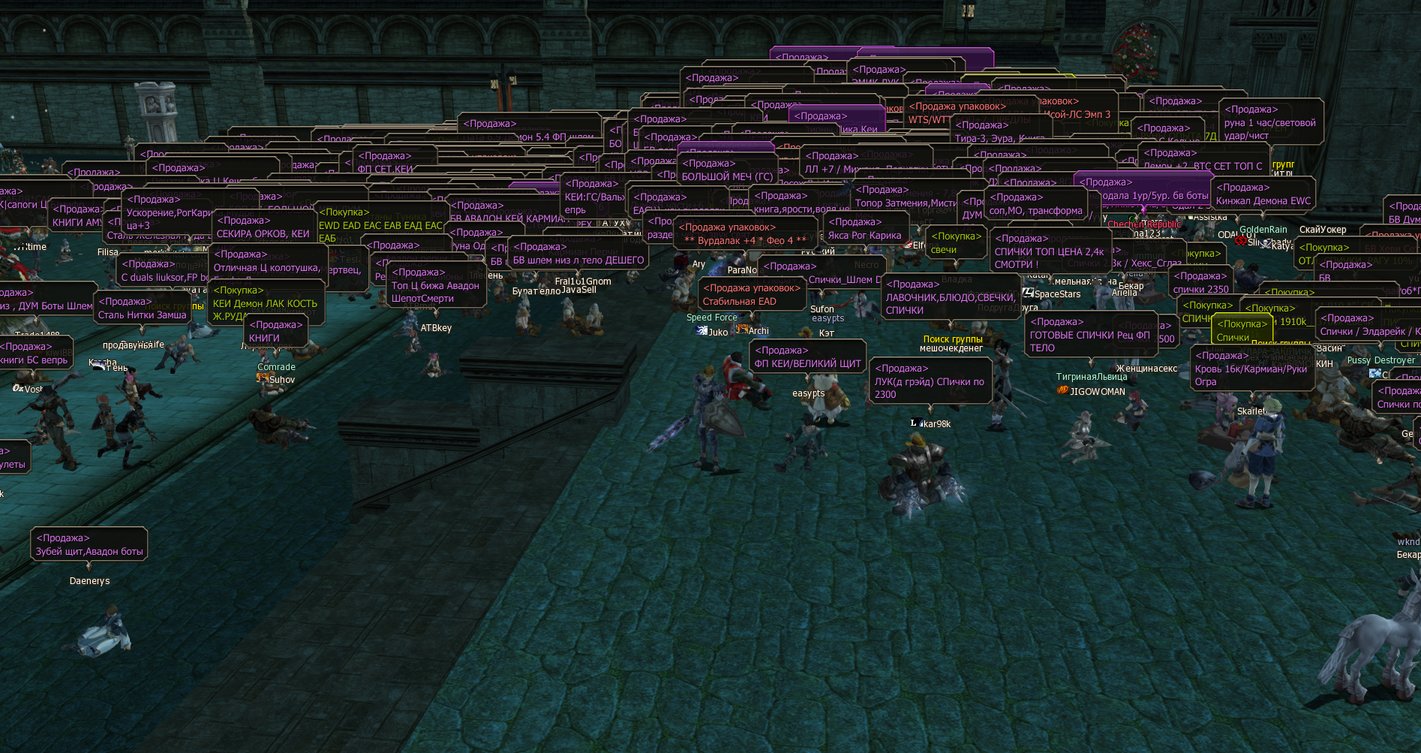
В отличии от World of Warcraft в Lineage 2 совершенно другая система добычи игровой валюты. Нужно круглыми сутками охотиться на монстров с целью получения наживы. Для меня было даже открытием, что для некоторых людей RMT (Real money trading) является чем то вроде работы. Также, в игре присутствует экономика, которую формируют игроки. Иными словами, можно заработать на купи-продай или же покупать дешевые ресурсы, из них делать вещи и продавать с наценкой. Так как для нас игра остается чем то вроде отдыха именно такой способ получения игровой валюты был выбран нами.

Чтобы покупать и продавать предметы игрок должен находиться online (Скриншот сверху). Соответсвенно, кто-то хочет побыстрее продать (дешевле) а кто-то побыстрее купить (дороже). А что если разница продать — купить положительная? Как раз этот пример и будет рассмотрен в статье как итог.

Однако, цены на рынке достаточно нестабильны и часто меняются. По этому существует вероятность купить что то "дешево" и потом еще дешевле продать и отрицательной прибылью. Этого мы и стараемся избежать. В общем было решено написать систему аналитики рынка и разобраться с парочкой интересных мне технологий.

Spoiler:
В статье будут использованы следующие технологии
Docker, DigitalOcean, NodeJs, Ktor, Prometheus, Grafana, Telegram bot notification

Читать полностью »

У Grafana есть возможность показывать статус, у Grafana есть возможность показывать данные во времени. Однако, как это ни парадоксально, у Grafana до настоящего момента не было удобного способа показывать статус во времени!

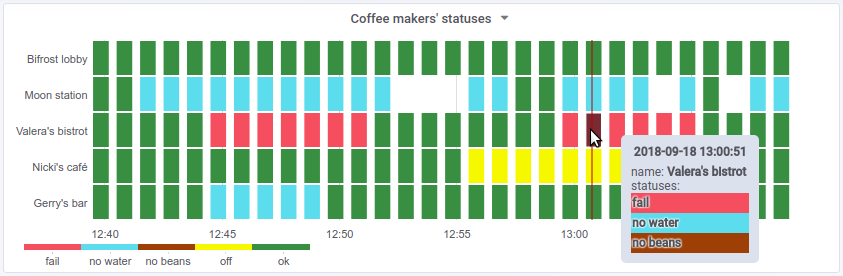
Мы представляем свой плагин — Statusmap panel. Он позволяет наглядно отобразить состояния набора объектов за выбранный промежуток времени. В качестве примера, демонстрирующего работу плагина, представим себе множество локаций, в которых для кого-то готовят кофе:

Представляем новый плагин для Grafana — Statusmap panel - 1
Можно увидеть, как Никки экономит электроэнергию, Герри быстро пополняет запасы воды, кофемашина Валеры частенько барахлит, а на Бифросте Wi-Fi явно лучше, чем на лунной станции, где, похоже, с водой совсем туго.

Выглядит интересно? Но начнём с того, как мы вообще к этому пришли.Читать полностью »

Здравствуйте, коллеги.

Мы только что отдали в перевод интересную книгу Брендана Бёрнса, рассказывающую о паттернах проектирования для распределенных систем

Мониторинг кластера Kubernetes при помощи Prometheus - 1 Кроме того, у нас уже полным ходом идет перевод книги "Mastering Kubernetes" (2-е издание) и готовится к выходу в сентябре авторская книга о Docker, о которой обязательно будет отдельный пост.

Полагаем, что следующая остановка на этом пути — книга о Prometheus, поэтому сегодня предлагаем вашему вниманию перевод небольшой статьи Бьёрна Венцеля о тесном взаимодействии Prometheus и Kubernetes. Не забудьте пожалуйста поучаствовать в опросе.
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js