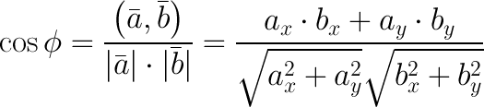
Рубрика «sql» - 25

Очереди сообщений в PostgreSQL с использованием PgQ - 1

Очереди сообщений используются для выполнения: отложенных операций, взаимодействия сервисов между собой, «batch processing» и т.д. Для организации подобных очередей существуют специализированные решения, такие как: RabbitMQ, ActiveMQ, ZeroMQ и тд, но часто бывает, что в них нет большой необходимости, а их установка и поддержка причинит больше боли и страданий, чем принесет пользы. Допустим, у вас есть сервис, при регистрации в котором пользователю отправляется email для подтверждения, и, если вы используете Postgres, то вам повезло — в Postgres, почти из коробки, есть расширение PgQ, которое сделает всю грязную работу за вас.

В этой статье я расскажу об организации очередей сообщений (задач) в PostgreSQL с использованием расширения PgQ. Эта статья будет полезна, если вы еще не использовали PgQ или используете самописные очереди поверх Postgres.

Зачем вообще нужен PgQ, если можно просто создать табличку и записывать туда задачи? Казалось бы, можно, но вам придется учесть паралельный доступ к задачам, возможные ошибки (что будет, если процесс обрабатывающий задачу, упадет?), а также производительность (PgQ очень быстрый, а самописные решения, как правило, нет, особенно если транзакция в базе не закрывается во время всего выполнения задачи), но самое главное, почему на мой взгляд надо использовать PgQ, это то, что PgQ уже написан и работает, а самописное решение еще надо написать.

Но у PgQ есть один огромный минус — отсутствие документации, этот недостаток я и пытаюсь компенсировать этой статьей.
Читать полностью »
Привет!

В условиях многообразия распределенных систем, наличие выверенной информации в целевом хранилище является важным критерием непротиворечивости данных.

На этот счет существует немало подходов и методик, а мы остановимся на реконсиляции, теоретические аспекты которой были затронуты вот в этой статье. Предлагаю рассмотреть практическую реализацию данной системы, масштабируемой и адаптированной под большой объем данных.

Как реализовать этот кейс на старом-добром Python — читаем под катом! Поехали!

Multiprocessing и реконсиляция данных из различных источников - 1

(Источник картинки)
Читать полностью »

Рисуем морозные узоры на SQL - 1

Немного SQL-магии под катом: математика, рекурсия, псевдографика.

Вспоминаем под Новый год формулу угла между векторами:
Рисуем морозные узоры на SQL - 2
Читать полностью »

VACUUM может «зачистить» из таблицы в PostgreSQL только то, что никто не может увидеть — то есть нет ни одного активного запроса, стартовавшего раньше, чем эти записи были изменены.

А если такой неприятный тип (продолжительная OLAP-нагрузка на OLTP-базе) все же есть? Как почистить активно меняющуюся таблицу в окружении длинных запросов и не наступить на грабли?

Когда пасует VACUUM — чистим таблицу вручную - 1
Читать полностью »

Очередь слонов - pixabay.com

Для организации обработки потока задач используются очереди. Они нужны для накопления и распределения задач по исполнителям. Также очереди могут обеспечивать дополнительные требования к обработке задач: гарантия доставки, гарантия однократного исполнения, приоритезация и т. д.

Как правило, используются готовые системы очередей сообщений (MQ — message queue), но иногда нужно организовать ad hoc очередь или какую-нибудь специализированную (например, очередь с приоритетом и отложенным перезапуском не обработанных из-за исключений задач). О создании таких очередей и пойдёт речь ниже.

Ограничения применимости

Предлагаемые решения предназначены для обработки потока однотипных задач. Они не подходят для организации pub/sub или обмена сообщениями между слабо связанными системами и компонентами.

Очередь поверх реляционной БД хорошо работает при малых и средних нагрузках (сотни тысяч задач в сутки, десятки-сотни исполнителей), но для больших потоков лучше использовать специализированное решение.

Суть метода в пяти словах

select ... for update skip locked

Читать полностью »

Тестирование как универсальный принцип

Уже почти четверь века празднуем миллениум, а тестирование ещё только входит в нашу жизнь… Сложно убедить начинающих разработчиков использовать эту потрясающую технику в своей работе… Да чего уж там говорить о разработчиках, простым смертным и то не всегда доступно понимание того, что тестирование — основа устойчивых систем! Как сложно бывает убедить продавщицу в том, что протестировать новый продукт — не значит съесть его! Даже бывалые охранники явно работают по старинке — пытаются догнать и отобрать тестируемое. И не докажешь им, что если уж сам Господь Бог не гнушается использовать TDD в своей работе (вспомним Великий Потоп), то нам как говорится сам бог велел…

Количество разводов растёт — почему? Да всё потому же! TDD! Сначала тестируй — потом женись! Нет, доверчивые мужички в расхристанных тулупах, падкие на эксплуатирующую секс рекламу, выкатывают молодую жену прямо в продакшн…

Ну мы то с вами из другого теста, сначала тестирование — потом всё остальное!

Я тестировщика узнаю по походке…

И вот когда я начал писать очередную базу данных code first то задумался, а почему бы не сделать автоматическое тестирование своего DAL слоя прямо на встроенных в VisualStudio тестах?

И у меня получилось! Прозрачно для EntityFramework, без всякой ловкости рук под одеялом и мошенничества с fake-объектами. Кому интересно — расчехляем VS, одеваемся как тестировщики и вперёд! (я всегда одеваюсь как тестировщик)

Одежда тестировщика

image

Читать полностью »

Случаются ситуации, когда в таблицу без первичного ключа или какого-то другого уникального индекса по недосмотру попадают полные клоны уже существующих записей.

Вычищаем клон-записи из таблицы без PK - 1

Например, пишутся в PostgreSQL COPY-потоком значения хронологической метрики, а потом внезапный сбой, и часть полностью идентичных данных приходит повторно.

Как избавить базу от ненужных клонов?
Читать полностью »

Периодически у разработчика возникает необходимость передать в запрос набор параметров или даже целую выборку «на вход». Иногда попадаются очень странные решения этой задачи.

Пойдем «от обратного» и посмотрим, как делать не стоит, почему, и как можно сделать лучше.
Читать полностью »

Бойтесь операций, buffers приносящих…
На примере небольшого запроса рассмотрим некоторые универсальные подходы к оптимизации запросов на PostgreSQL. Пользоваться ими или нет — выбирать вам, но знать о них стоит.
Читать полностью »

Привет! Как водится, три раза в году мы рассказываем о том, над чем работали. Это статья о том, что нового в DataGrip 2019.3, а значит и во всех IDE от JetBrains с поддержкой баз данных.

DataGrip 2019.3: MongoDB, дебаггер, модный прогресс-бар, много новых инспекций - 1
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js