Рубрика «big data» - 67

Введение в архитектуры нейронных сетей - 1

Григорий Сапунов (Intento)

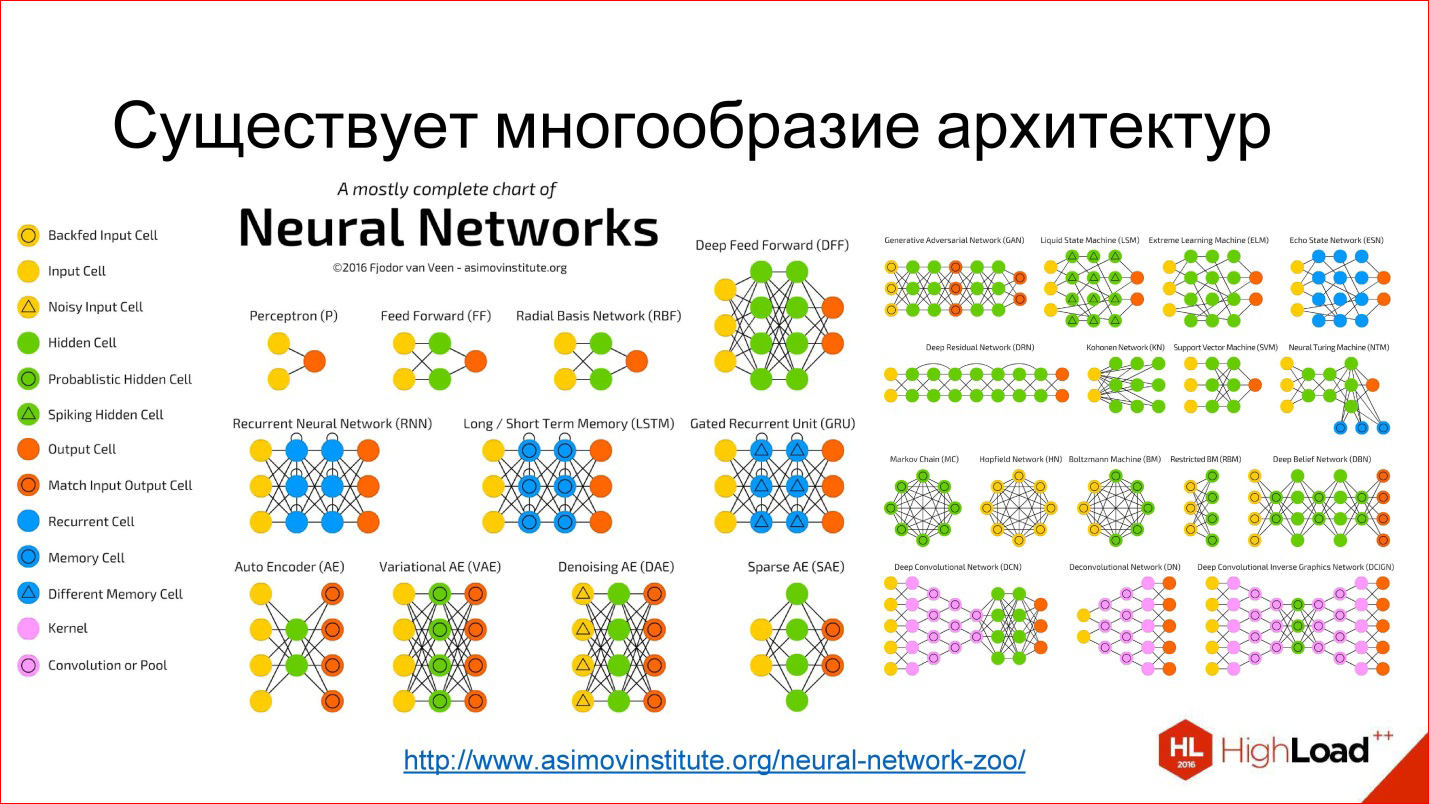
Меня зовут Григорий Сапунов, я СТО компании Intento. Занимаюсь я нейросетями довольно давно и machine learning’ом, в частности, занимался построением нейросетевых распознавателей дорожных знаков и номеров. Участвую в проекте по нейросетевой стилизации изображений, помогаю многим компаниям.

Давайте перейдем сразу к делу. Моя цель — дать вам базовую терминологию и понимание, что к чему в этой области, из каких кирпичиков собираются нейросети, и как это использовать.

План доклада такой. Сначала небольшое введение про то, что такое нейрон, нейросеть, глубокая нейросеть, чтобы мы с вами общались на одном языке.

Дальше я расскажу про важные тренды, что происходит в этой области. Затем мы углубимся в архитектуру нейросетей, рассмотрим 3 основных их класса. Это будет самая содержательная часть.

После этого рассмотрим 2 сравнительно продвинутых темы и закончим небольшим обзором фреймворков и библиотек для работы с нейросетями.
Читать полностью »
Машинное обучение сейчас в тренде, вот только если коснуться коммерческого применения — возникает много вопросов. Потому мы нашли человека, у которого есть ответы. Мы поговорили с Александром Сербулом из «1С-Битрикс», который рассказал о применении машинного обучения для решения бизнес-задач, причинах хайпа вокруг deep learning и пользе чат-ботов для пользователей и бизнеса. За подробностями добро пожаловать под кат.

Machine Learning: где деньги лежат? - 1

Читать полностью »

Привет! Продолжаем рассказывать о прошедшем 12-14 сентября форуме Data Science Week 2017, и на очереди обзор второго и третьего дня, где были затронуты вопросы построения рекомендательных систем, анализа данных в Bitcoin и построения успешной карьеры в области работы с данными.

Data Science Week 2017. Обзор второго и третьего дня - 1
Читать полностью »

Хотите внедрить или доработать функцию поиска? Вам сюда.

Что должен знать о поиске каждый разработчик - 1
Спросите разработчика: «Как бы вы реализовали функцию поиска в своем продукте?» или «Как создать поисковую систему?». Вероятно, в ответ вы услышите что-нибудь такое: «Ну, мы просто запустим кластер Elasticsearch: с поиском сегодня всё просто».

Но так ли это? Во многих современных продуктах по-прежнему не лучшим образом реализован поиск. Настоящий специалист по поисковым системам скажет вам, что лишь немногие разработчики глубоко понимают, как работает поиск, а ведь это знание часто необходимо для улучшения качества поиска.

Есть множество программных пакетов с открытым исходным кодом, проведено немало исследований, однако лишь немногие избранные понимают, как нужно делать функциональный поиск. Как ни забавно, но если поискать в Интернете связанную с реализацией поиска информацию, вы не найдете актуальных и содержательных обзоров.

Цель статьи

Этот текст можно считать собранием ценных идей и ресурсов, которые могут помочь в создании функции поиска. Статья, безусловно, не претендует на исчерпывающую полноту, однако я надеюсь, что ваши отзывы помогут ее доработать (оставляйте замечания в комментариях или свяжитесь со мной).

Основываясь на опыте работы с универсальными решениями и узкоспециализированными проектами самого разного масштаба (в компаниях Google, Airbnb и нескольких стартапах), я расскажу о некоторых популярных подходах, алгоритмах, методах и инструментах.

Недооценка и непонимание масштабов и сложности задачи поиска могут привести к тому, что у пользователей останутся плохие впечатления, разработчики потратят время впустую, а продукт провалится.

Переведено в Alconost
Читать полностью »

Доброго времени суток! У нас открылось совершенно новое направление обучения — BigData, а это значит, что немного расширяется горизонт материалов, которыми мы будем делиться с вами. Сегодня рассмотрим Luigi, как часть того, что раскрывается на нашем курсе.

Luigi — фреймворк на языке Python для построения сложных последовательностей по выполнению зависимых задач. Довольно большая часть фреймворка направлена на преобразования данных из различных источников (MySql, Mongo, redis, hdfs) и с помощью различных инструментов (от запуска процесса до выполнения задач разных типов на кластере Hadoop). Разработан в компании Spotify и открыт в виде open source инструмента в 2012 году.

Самое главное преимущество фреймворка — возможность выстраивать последовательности зависимых задач. Фреймворк разрешает зависимости, отслеживает граф выполнения, управляет запуском задач, обрабатывает ошибки с возможностью перезапуска нужных задач, распределяет ресурсы рабочих процессов с возможностью параллельной работы независимых частей графа задач.

Для выполнения всех этих задач существуют и другие инструменты. Это Oozie, Pinball, Airflow (находится в статусе инкубации в Apache — проходит различные проверки, недавно вышел обзор на хабре). В данной статье рассмотрим только Luigi.

Обзор фреймворка Luigi для построения последовательностей выполнения задач - 1
Читать полностью »

image

Когда я сдавал экзамены в универе, я всегда садился готовиться на ближайшую к преподу парту и никогда не шел первым, а пропускал вперед 8-10 человек. Тем самым я успевал «подслушать» дополнительные вопросы и, частично, ответы на них.

И тут у меня возникла идея, как сделать подсказки по олимпиаде для тех старшеклассников, которые читают Хабр (что говорит о том, что у них действительно продвинутые мозги). Я нашел тех ребят, которые показали отличные результаты на предыдущих олимпиадах НТИ и поспрашивал их, какие дополнительные материалы могут помочь разобраться в теме лучше и дадут дополнительные преимущества на завершающем практическом этапе.

Прием заявок на олимпиаду идет до 22 октября, а там есть еще время подготовиться.
Читать полностью »

Диалоговые системы, они же чат-боты, сегодня размножились до неприличия. Но уровень их «интеллекта» часто удручающий. Популярные чат-боты работают либо с помощью шаблонов, либо используя модель «намерение+сущности». С простыми задачами они справляются отлично (поставить будильник, напоминание, найти ответ на часто задаваемый вопрос), но узость и ограниченность их «мышления» легко выявляется даже при поверхностном опросе. Могут ли нейросети помочь создать нечто более совершенное, возможно приближающееся к действительно разумному?
Читать полностью »

Я понимаю, что странно начинать блог с негатива, но за последние несколько дней поднялась волна дискуссий, которая хорошо соотносится с некоторыми темами, над которыми я думал в последнее время. Всё началось с поста Джеффа Лика в блоге Simply Stats с предостережением об использовании глубинного обучения на малом размере выборки. Он утверждает, что при малом размере выборки (что часто наблюдается в биологии), линейные модели с небольшим количеством параметров работают эффективнее, чем нейросети даже с минимумом слоёв и скрытых блоков.

Далее он показывает, что очень простой линейный предиктор с десятью самыми информативными признаками работает эффективнее простой нейросети в задаче классификации нулей и единиц в наборе данных MNIST, при использовании всего около 80 образцов. Эта статья сподвигла Эндрю Бима написать опровержение, в котором правильно обученная нейросеть сумела превзойти простую линейную модель, даже на очень малом количестве образцов.

Такие споры идут на фоне того, что всё больше и больше исследователей в области биомедицинской информатики применяют глубинное обучение на различных задачах. Оправдан ли ажиотаж, или нам достаточно линейных моделей? Как всегда, здесь нет однозначного ответа. В этой статье я хочу рассмотреть случаи применения машинного обучения, где использование глубоких нейросетей вообще не имеет смысла. А также поговорить о распространённых предрассудках, которые, на мой взгляд, мешают действительно эффективно применять глубинное обучение, особенно у новичков.
Читать полностью »

В рамках программы «Цифровая экономика» «Ростех» создаст аппаратно-программный комплекс по обработке big data. Пилотный проект планируется на базе крупного банка и предусматривает выявление на ранних стадиях инцидентов в сфере кибербезопасности.

Рабочая группа по программе «Цифровая экономика», которую возглавил Сбербанк, Читать полностью »

image

Привет! В этой статье я хочу рассказать об одном замечательном инструменте для разработки batch-процессов обработки данных, например, в инфраструктуре корпоративного DWH или вашего DataLake. Речь пойдет об Apache Airflow (далее Airflow). Он несправедливо обделен вниманием на Хабре, и в основной части я попытаюсь убедить вас в том, что как минимум на Airflow стоит смотреть при выборе планировщика для ваших ETL/ELT-процессов.

Ранее я писал серию статей на тему DWH, когда работал в Тинькофф Банке. Теперь я стал частью команды Mail.Ru Group и занимаюсь развитием платформы для анализа данных на игровом направлении. Собственно, по мере появления новостей и интересных решений мы с командой будем рассказывать тут о нашей платформе для аналитики данных.

Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js