Рубрика «big data» - 68

В 2016/2017 годах мы обнаружили, что на каждой из наших конференций есть 1-3 доклада о Big Data, нейросетях, искусственном интеллекте или машинном обучении. Стало понятно, что под эту тему можно собрать хорошую конференцию, о чём я сегодня вам и расскажу.

Вкусно: мы решили собрать под одной крышей учёных, инженеров-практиков, архитекторов и сделать упор на технологии — казалось бы, обычное дело, но нет.

Сложно: копнув глубже, можно увидеть, что отдельными вопросами все занимаются не сообща, а врозь.

Учёные строят нейросети в теории, архитекторы делают распределённые системы для корпораций с целью обработки огромных потоков данных в реальном времени, без конечной цели унифицировать к ним доступ, инженеры-практики пишут под это всё софт для сугубо узких задач, которые потом нереально перенести на что-то другое. В общем, каждый копает свою грядку и не лезет к соседу… Так? Да нет же!

На деле: Все занимаются частью общего. Как сама Smart Data (а «умные данные» — это очень узкий перевод) по природе своей, так и те, кто с ней работает, по сути, делают распределённую сеть различных наработок, которые могут создавать порой неожиданные сочетания. Это и формирует фундамент Умных данных в своей красоте и практической значимости.

Итак, что это за кусочки паззла и кто их создает, можно будет посмотреть и даже обсудить с создателями на конференции SmartData 2017 Piter 21 октября 2017. Подробности под катом.
image

Дальше будет много букв, мы же за большие и умные данные, хотя исторически анонс подразумевает быстрый и ёмкий текст, краткий и точный, как выстрел снайпера в ясную летнюю ночь.
Читать полностью »
Привет! Продолжаем серию материалов от выпускника нашей программы Deep Learning, Кирилла Данилюка, об использовании сверточных нейронных сетей для распознавания образов — CNN (Convolutional Neural Networks).

В прошлом посте мы начали разговор о подготовке данных для обучения сверточной сети. Сейчас же настало время использовать полученные данные и попробовать построить на них нейросетевой классификатор дорожных знаков. Именно этим мы и займемся в этой статье, добавив дополнительно к сети-классификатору любопытный модуль — STN. Датасет мы используем тот же, что и раньше.

Spatial Transformer Network (STN) — один из примеров дифференцируемых LEGO-модулей, на основе которых можно строить и улучшать свою нейросеть. STN, применяя обучаемое аффинное преобразование с последующей интерполяцией, лишает изображения пространственной инвариантности. Грубо говоря, задача STN состоит в том, чтобы так повернуть или уменьшить-увеличить исходное изображение, чтобы основная сеть-классификатор смогла проще определить нужный объект. Блок STN может быть помещен в сверточную нейронную сеть (CNN), работая в ней по большей части самостоятельно, обучаясь на градиентах, приходящих от основной сети.

Весь исходный код проекта доступен на GitHub по ссылке. Оригинал этой статьи можно посмотреть на Medium.

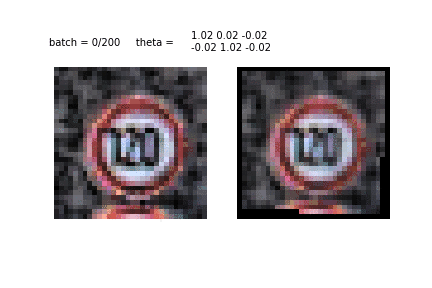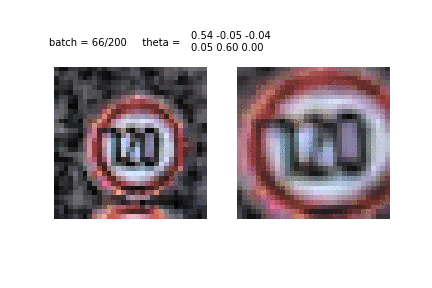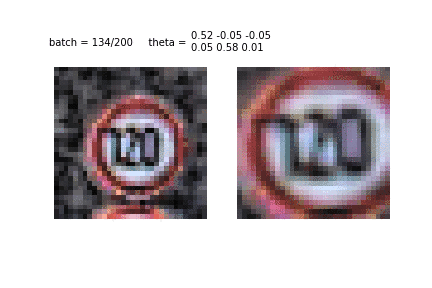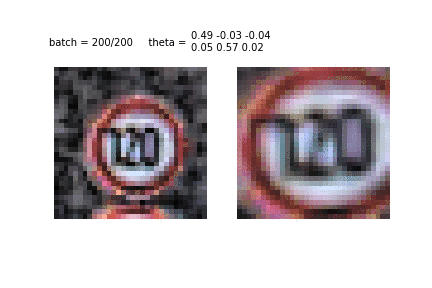
Чтобы иметь базовое представление о работе STN, взгляните на 2 примера ниже:

Распознавание дорожных знаков с помощью CNN: Spatial Transformer Networks - 1

Слева: исходное изображение. Справа: то же изображение, преобразованное STN. Spatial transformers распознают наиболее важную часть изображения и затем масштабируют или вращают его, чтобы сфокусироваться на этой части.
Читать полностью »

Московский арбитражный суд отклонил иск «ВКонтакте» к Double Data. Об этом сообщает «Коммерсантъ» со ссылкой на представителя Double Data, резидента «Сколково». По словам издания, дело слушалось в первой инстанции, после ряда заседаний суд принял решение полностью отклонить все требования «ВКонтакте».

Читать полностью »

Сообщество Open Data Science (ODS) уже известно на Хабре по открытому курсу машинного обучения (OpenML). Сегодня мы поговорим с его создателем об истории ODS, людях и наиболее популярных методах машинного обучения (по версии Кaggle и проектам индустрии). За интересными фактами и технической экспертизой — прошу под кат.

Создатель Open Data Science о Slack, xgboost и GPU - 1

Читать полностью »

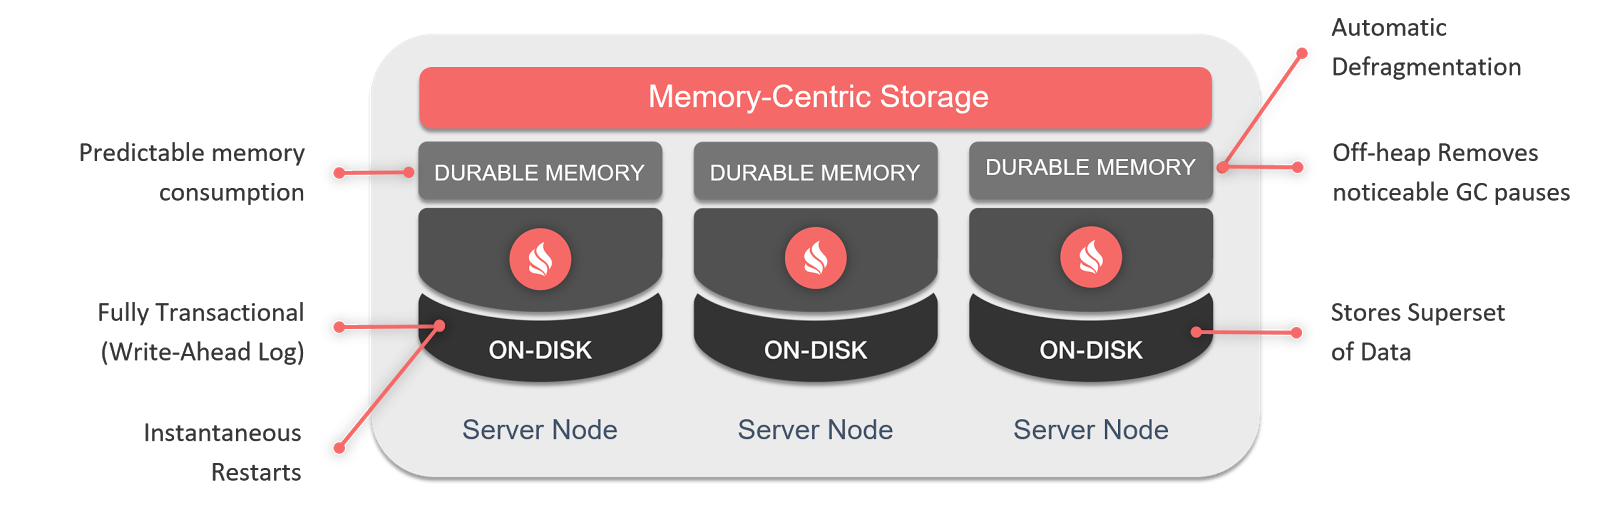
Apache® Ignite™ + Persistent Data Store — In-Memory проникает на диски. Часть I — Durable Memory - 1

В Apache Ignite, начиная с версии 2.1 появилась собственная реализация Persistence.

На то, чтобы построить этот механизм в современном его исполнении, ушли десятки человеколет, которые были в основном потрачены на построение распределенного отказоустойчивого транзакционного хранилища с поддержкой SQL.

Всё началось с фундаментальных проблем предыдущего механизма, который позволял интегрировать In-Memory Data Grid с внешними постоянными хранилищами, например, Cassandra или Postgres.

Такой подход накладывал определенные ограничения — например, было невозможно выполнять SQL или распределенные вычисления поверх данных, которые находятся не в памяти, а в таком внешнем хранилище, был невозможен холодный запуск и низкий RTO (Recovery Time Objective) без существенных дополнительных усложнений.

Если вы используете Apache Ignite Persistence, то оставляете себе все обычные возможности Apache Ignite — ACID, распределенные транзакции, распределенный SQL99, доступ через Java/.NET API или интерфейсы JDBC/ODBC, распределенные вычисления и так далее. Но теперь то, что вы используете, может работать как поверх памяти, так и поверх диска, который расширяет память, на инсталляциях от одного узла до нескольких тысяч узлов.

Давайте посмотрим, как устроен Apache Ignite Persistence внутри. Сегодня я рассмотрю его основу — Durable Memory, а в следующей публикации — сам дисковый компонент.Читать полностью »

Запуск регулярных задач на кластере или как подружить Apache Spark и Oozie - 1

Давно уже витала в воздухе необходимость реализовать запуск регулярных Spark задач через Oozie, но всё руки не доходили и вот наконец свершилось. В этой статье хочу описать весь процесс, возможно она упростит Вам жизнь.

Читать полностью »

Конференция VLDB (Very Large Data Bases, www.vldb.org), как несложно понять из названия, посвящена базам данных. Очень большим базам данных. О чем её название не говорит, так это о том, что там регулярно выступают очень серьезные люди. Много ли вы знаете конференций, где почти каждый год докладывается Майкл Стоунбрекер (Michael Stonebraker, создатель Vertica, VoltDB, PostgreSQL, SciDB)? Не думали ли вы, что было бы здорово узнать, над чем такие люди работают сейчас, чтобы через несколько лет, когда новая база разорвет рынок, не грызть локти?

VLDB — именно та конференция, которую вам нужно посетить, если вы думаете о будущем.
Она вам не очень поможет, если вы выбираете из существующих баз. Там есть небольшая доля industrial докладов (Microsoft, Oracle, Teradata, SAP Hana, Exadata, Tableau (!)), но самое интересное — это исследовательские доклады от университетов. Xотя очень быстро обнаруживается, что в командах университетов есть один-два человека, работающих на Google, Facebook, Alibaba… или перешедших туда сразу после подачи статьи.

Надеюсь, мне удалось вас базово заинтересовать, а теперь давайте пройдемся, собственно, по докладам.

Материалы с VLDB, конференции о будущем баз данных - 1

Читать полностью »

PowerShell для ИТ-безопасности. Часть IV: платформа безопасности с использованием скриптов - 1

В предыдущей заметке этой серии я предложил возможность объединения моих отдельных скриптов — один для обработки событий, другой для классификации — в одну систему. Не замахнуться ли на платформу безопасности на основе одного кода PowerShell?

Проработав некоторые детали, в основном относящиеся к зубодробительным событиям PowerShell, я смог заявить о своей победе и зарегистрировал патент на платформу безопасности на базе скриптов — SSP (Security Scripting Platform ).
Читать полностью »

Какие банковские предложения по открытию текущих счетов и депозитов можно считать удачными, а какие стоит доработать? Что можно улучшить в процедуре проведения валютно-обменных операций и в дистанционном банковском обслуживании? Мы в Департаменте транзакционного бизнеса ВТБ постоянно работаем над поиском ответов на эти вопросы. Как нам в этом помогает использование IT-стратегии развития и как от этого выигрывают клиенты – читайте под катом.

«Короли математики»: аналитика Big Data в банке. Проект ГАУСС в ВТБ - 1Читать полностью »

С развитием нейросетей им придумывают всё более разнообразные способы применения. С их помощью обучаются автопилоты Tesla, а распознавание лиц используется не только для обработки фотографий приложениями типа Prisma, но и в системах безопасности. Искусственный интеллект учат диагностировать болезни. В конце концов, с его помощью даже выигрывают выборы.

Но есть одна сфера, которая традиционно считалась принадлежащей исключительно человеку — творчество. Однако и это утверждение начинают ставить под сомнение. Ли Седоль, проигравший AlphaGo, признался: «Поражение заставило меня засомневаться в человеческой креативности. Когда я увидел, как играет AlphaGo, то усомнился в том, насколько хорошо играю сам». Поэтому в сегодняшнем посте давайте поговорим о том, способны ли роботы ступить на территорию искусства, в пространство креативности, а значит эмоций и восприятия.

«Человек» искусства: способен ли искусственный интеллект творить? - 1Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js