Рубрика «big data» - 93

Игорь Илюнин: «Заказчик попросил собрать команду, которой не нашел в Кремниевой долине» - 1

«Интернет вещей» — направление, на котором развитие идет с невероятной скоростью, где даже стратегические планы приходится пересматривать чуть ли не ежегодно. О том, чем живет передний край ИТ, как изменились подходы к найму и обучению инженеров, какие перспективы это открывает для молодых специалистов, рассказал Игорь Илюнин, лидер IoT-практики DataArt.

И. И.: Около полутора лет назад мы поняли, что в области IoT ветер начинает дуть немного в другую сторону. Раньше клиентов интересовали подключение устройств, знание конкретных протоколов обмена данными между ними, различные типы подключения к сети, построение инфраструктуры на уровне устройств. Но в этот момент к нам пришли сразу несколько заказчиков – достаточно крупных компаний, причем одним из них был производитель компьютерной техники. Эта компания собиралась строить собственный IoT-cloud, который бы обслуживал всех их клиентов, хотела обеспечить перемещение данных, самостоятельно их обрабатывать, позволив самим клиентам делать кастомизацию. То есть создать платформу на все случаи жизни. При этом они озвучили список современных технологий, которыми должны владеть инженеры их поставщика, и на тот момент во всей компании мы нашли всего пару человек, которые хотя бы частично удовлетворяли этим требованиям. Надо сказать, что и сам заказчик говорил: «нам нужна команда в 3-4 человека, которые будут работать над нашим проектом — в Кремниевой долине мы таких не нашли». Мы увидели в этом отличную возможность — тогда появился концепт внутренней Big Data академии.Читать полностью »

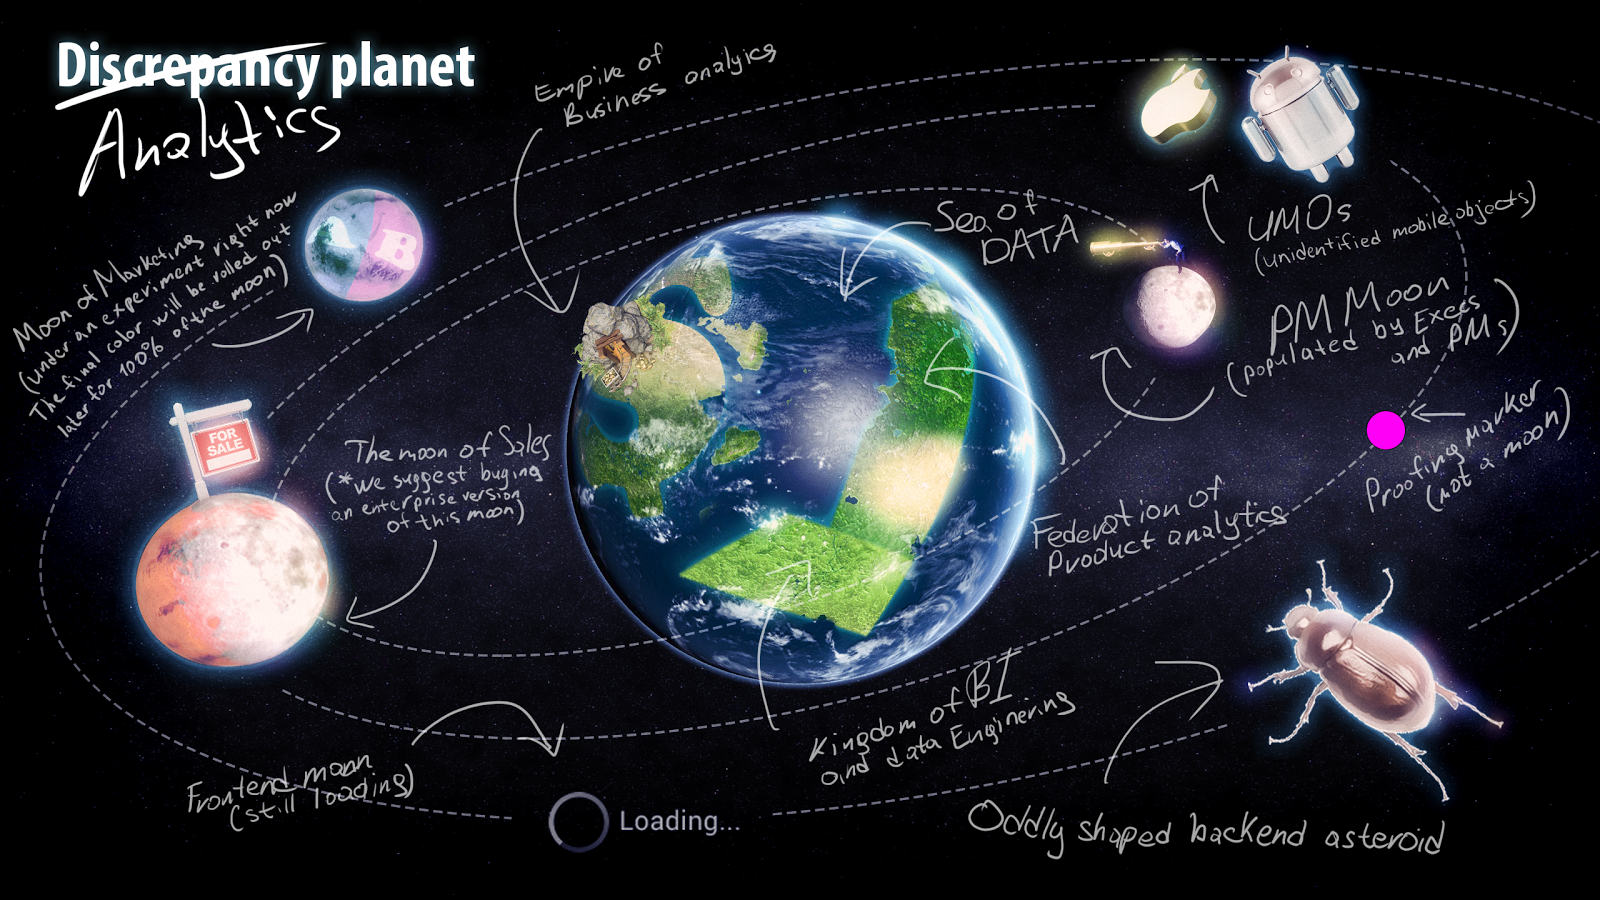
Настоящая статья является продолжением предыдущей публикации «Инструменты DataScience как альтернатива классической интеграции». Основная цель — заострить внимание как разработчиков, так и руководителей среднего звена, на широком спектре возможностей, которые предоставляют современные инструменты из сферы Data Science за рамками классических задач статистических вычислений и модной нынче темы машинного обучения. В частности, возможности экосистемы R по состоянию на август 2016 года и применение этих возможностей на примере двух задач: одной из прикладной науки, другой – из среднего бизнеса.
Читать полностью »

В современном мире нейронные сети находят себе всё больше применений в различных областях науки и бизнеса. Причем чем сложнее задача, тем более сложной получается нейросеть.

Обучение сложных нейронных сетей иногда может занимать дни и недели только для одной конфигурации. А чтобы подобрать оптимальную конфигурацию для конкретной задачи, требуется запустить обучение несколько раз — это может занять месяцы вычислений даже на действительно мощной машине.

В какой-то момент, знакомясь с представленным в 2015 году методом Batch Normalization от компании Google мне, для решения задачи связанной с распознаванием лиц, удалось существенно улучшить скорость работы нейросети.

Batch Normalization для ускорения обучения нейронных сетей - 1

За подробностями прошу под кат.

Читать полностью »

В настоящий момент уже можно считать, что страсти по Big Data и Data Science немного утихли, а ожидание чуда, как обычно, было сильно скорректировано реальностью физического мира. Самое время заняться конструктивной деятельностью. Поиск тем на Хабре по различным ключевым словам выдал крайне скудный набор статей, поэтому я решил поделиться тем опытом, который был накоплен в части практического применения инструментов и подходов Data Science для решения повседневных задач в компании.
Читать полностью »

Обсуждение инструментов аналитики для работы с большими данными в Питере 14 сентября - 1

14 сентября в 19:00 мы встретимся в офисе компании Wrike, чтобы обсудить инструменты аналитики и работу с большими данными. Главное внимание мы уделим успешным практикам и инструментам, разберем конкретные кейсы, поговорим о построении системы аналитики в компании, попробуем дать конкретные советы и рекомендации. Эксперты с удовольствием ответят на ваши вопросы.
Читать полностью »

Здравствуйте, дорогие читатели. Мы редко пишем о книжных «долгостроях», то есть, о работах, которые никак не выйдут на Западе. Но сегодня хотим познакомить вас с постом из блога Мартина Клеппмана, который уже не первый год трудится над фундаментальной книгой "Designing Data-Intensive Applications"

Книга об интенсивной обработке данных - 1


В сравнительно небольшой публикации автору удалось изложить базовые идеи столь объемной книги, обрисовать целевую аудиторию и почти убедить нас, что за перевод надо браться. Но вы все равно почитайте и не стесняйтесь голосовать.
Читать полностью »

X5 Retail Group тестирует систему предсказания спроса на товары со скидками в «Пятёрочках», её разработала Yandex Data Factory. X5 тестировала сервис в Липецкой области в начале 2016 года. Прогноз делался для промоакций типа «регулярные скидки, действующие в течение одной недели», после модель была применена и для всех других типов промоакций. По словам представителя YDF, в 87% случаев прогноз оказался верен с точностью до одной упаковки, Читать полностью »

«Яндекс» намерен открыть API сервиса Яндекс.Погода сторонним компаниям на коммерческой основе. С помощью данного API сторонние компании смогут создавать свои погодные приложения, сервисы прогнозов, сообщать статистические данные и т. д. Прогноз погоды «Яндекса» создан на базе собственной технологии «Метеум». Она может предсказывать погоду с точностью до дома. Компания использует математическую модель,Читать полностью »

Что такое большие данные, часть 2 - 1

В первой части этой серии статей вы узнали о данных и о том, как можно использовать компьютеры чтобы добывать смысловое значение из крупных блоков таких данных. Вы даже видели что-то похожее на большие данные у Amazon.com середины девяностых, когда компания запустила технологию для наблюдения и записи в реальном времени всего, что многотысячная аудитория клиентов одновременно делала на их сайте. Довольно впечатляюще, но назвать это большими данными можно с натяжкой, пухлые данные — больше подойдёт. Организации вроде Агентства национальной безопасности США (NSA) и Центра правительственной связи Великобритании (GCHQ) уже собирали большие данные в то время в рамках шпионских операций, записывая цифровые сообщения, хотя у них и не было простого способа расшифровать их и найти в них смысл. Библиотеки правительственных записей были переполнены наборами бессвязных данных.

То, что сделал Amazon.com, было проще. Уровень удовлетворённости их клиентов мог быть легко определен, даже если он охватывал все десятки тысяч продуктов и миллионы потребителей. Действий, которые клиент может совершить в магазине, реальный он или виртуальный, не так уж много. Клиент может посмотреть что в доступе, запросить дополнительную информацию, сравнить продукты, положить что-то в корзину, купить или уйти. Всё это было в пределах возможностей реляционных баз данных, где отношения между всеми видами действий возможно задать заранее. И они должны быть заданы заранее, с чем у реляционных баз данных проблема — они не так легко расширяемы.

Заранее знать структуру такой базы данных — как составить список всех потенциальных друзей вашего неродившегося ребенка… на всю жизнь. В нём должны быть перечислены все неродившиеся друзья, потому что как только список будет составлен, любое добавление новой позиции потребует серьезного хирургического вмешательства.Читать полностью »

image

Приглашаем принять участие в 48-часовом командном соревновании, направленном на построение «умной системы» анализа логов и метрик кластера, обрабатывающего данные. Хакатон Hydrosphere.io пройдёт 9-11 сентября в Иннополисе, участие бесплатное. Все подробности под катом.Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js