 Spark – проект Apache, предназначенный для кластерных вычислений, представляет собой быструю и универсальную среду для обработки данных, в том числе и для машинного обучения. Spark также имеет API и для R(пакет SparkR), который входит в сам дистрибутив Spark. Но, помимо работы с данным API, имеется еще два альтернативных способа работы со Spark в R. Итого, мы имеем три различных способа взаимодействия с кластером Spark. В данном посте приводиться обзор основных возможностей каждого из способов, а также, используя один из вариантов, построим простейшую модель машинного обучения на небольшом объеме текстовых файлов (3,5 ГБ, 14 млн. строк) на кластере Spark развернутого в Azure HDInsight.
Читать полностью »
Рубрика «big data» - 94
R и Spark
2016-08-25 в 13:54, admin, рубрики: big data, Microsoft Azure, R, spark, машинное обучение«Мои друзья потеряли меня из виду на 3 месяца» или как люди учатся у нас big data
2016-08-24 в 13:11, admin, рубрики: big data, data mining, data science, Блог компании New Professions Lab, машинное обучениеВсем привет! 5 октября в New Professions Lab стартует пятый набор программы «Специалист по большим данным», которую на данный момент закончило более 200 человек. Мы уже рассказывали на Хабре (здесь и здесь), чему конкретно мы учим, с какими знаниями и навыками выходят наши выпускники, и совсем скоро напишем, что нового будет в пятой программе. А сегодня хотим поделиться рассказами и отзывами тех, кто уже прошел обучение и на себе испытал все тяготы и невзгоды.
Встреча любителей больших данных
2016-08-19 в 14:05, admin, рубрики: big data, Блог компании DCA (Data-Centric Alliance), Большие данные, машинное обучениеПривет! Если вам были интересны публикации из нашего блога, то наверняка вам будет интересно принять участие во встрече экспертов в области Data Science и машинного обучения, которая пройдёт 31 августа (среда) в DI Telegraph (Москва, Тверская 7). На встрече будет обсуждаться широкий круг вопросов, связанных с применением алгоритмов машинного обучения для решения задач анализа больших данных, тематического моделирования и генеративных алгоритмов.
Партнером и соорганизатором мероприятия выступаем мы — российская технологическая компания DCA (Data-Centric Alliance), специализирующаяся на работе с большими данными и высоконагруженными системами. Информация про формат и спикеров под катом.
Читать полностью »
Дино Эспозито на uDev Tech Events: «Life as a Service: Scalability and other Aspects»
2016-08-16 в 16:15, admin, рубрики: .net, big data, Блог компании Plarium, высокая производительность, геймдев, дино эспозито, конференция, масштабируемость, Программирование, разработка, разработка игр, стрим13 сентября 2016 года Дино Эспозито выступит на uDev Tech Events с лекцией на тему «Life as a Service: Scalability and other Aspects». Для тех, кто не сможет посетить мероприятие, будет вестись прямая трансляция.
Кто виноват, и что делать, если айтишник скучает на работе. Результаты опроса
2016-08-16 в 12:01, admin, рубрики: big data, data science, Блог компании New Professions Lab, Исследования и прогнозы в IT, опрос, профессиональный рост, Учебный процесс в ITНедавно мы провели опрос среди айтишников, чтобы узнать, скучают ли они на работе, и почему это происходит. Как мы и думали, большинство специалистов время от времени не знают, чем себя занять, и при этом задумываются, как можно этого избежать. Многие готовы оставаться на нынешнем месте работы, причем более 80% не хотят становиться начальниками, а хотят развиваться профессионально. Из них почти 10% видят себя в области Big Data и Data Science.
Всего на наши вопросы ответили 1898 человек. Данные можно посмотреть здесь и здесь.
Работа с фреймворком итеративной обработки графов Giraph на примере RBM
2016-08-15 в 10:58, admin, рубрики: big data, framework, giraph, java, mail.ru, rbm, Алгоритмы, Блог компании Mail.Ru Group
The Indifferent by xetobyte
Всем привет. В предыдущей статье мы рассказали, как создавать свои приложения под фреймворк Giraph (надстройка над системой обработки данных Hadoop), и обещали подробно рассмотреть, как работать с Giraph, на примере алгоритма обучения Restricted Boltzmann Machine. Итак, в какой-то момент группа сегментации аудитории департамента рекламных технологий Mail.Ru Group столкнулась с необходимостью подобрать инструмент для быстрого анализа графов, и по целому ряду причин (читайте ниже) наше внимание привлекла система Apache Giraph.
Читать полностью »
Flume — управляем потоками данных. Часть 3
2016-08-12 в 12:03, admin, рубрики: big data, flume, Hadoop, Анализ и проектирование систем, Блог компании DCA (Data-Centric Alliance)Привет! После долгой паузы мы наконец-то возвращаемся к разбору Apache Flume. В предыдущих статьях мы познакомились с Flume (Часть 1) и разобрались, как настраивать основные его компоненты (Часть 2). В этой, заключительной, части цикла мы рассмотрим следующие вопросы:
- Как настроить мониторинг компонентов узла.
- Как написать собственную реализацию компонента Flume.
- Проектирование полноценной транспортной сети.
Кого агрегирует Meduza?
2016-08-11 в 6:32, admin, рубрики: big data, data mining, анализ данных, аналитика, визуализация данных, математика, Медиа, МедузаГегель считал, что общество становится современным, когда новости заменяют религию.
The News: A User's Manual, Alain de Botton
Читать все новости стало разительно невозможно. И дело не только в том, что пишет их Стивен Бушеми в перерывах между боулингом с Лебовски, а скорее в том, что их стало слишком много. Тут нам на помощь приходят агрегаторы новостей и естественным образом встаёт вопрос: а кого и как они агрегируют?
Заметив пару интересных статей на Хабре про API и сбор данных популярного новостного сайта Meduza, решил расчехлить щит Персея и продолжить славное дело. Meduza мониторит множество различных новостных сайтов, и сегодня разберемся какие источники в ней преобладают, можно ли их осмысленно сгруппировать и есть ли здесь ядро, составляющее костяк новостной ленты.
Краткое определение того, что такое Meduza:
«Помните, как неумные люди все время называли «Ленту»? Говорили, что «Лента» — агрегатор. А давайте мы и в самом деле сделаем агрегатор» (интервью Forbes)
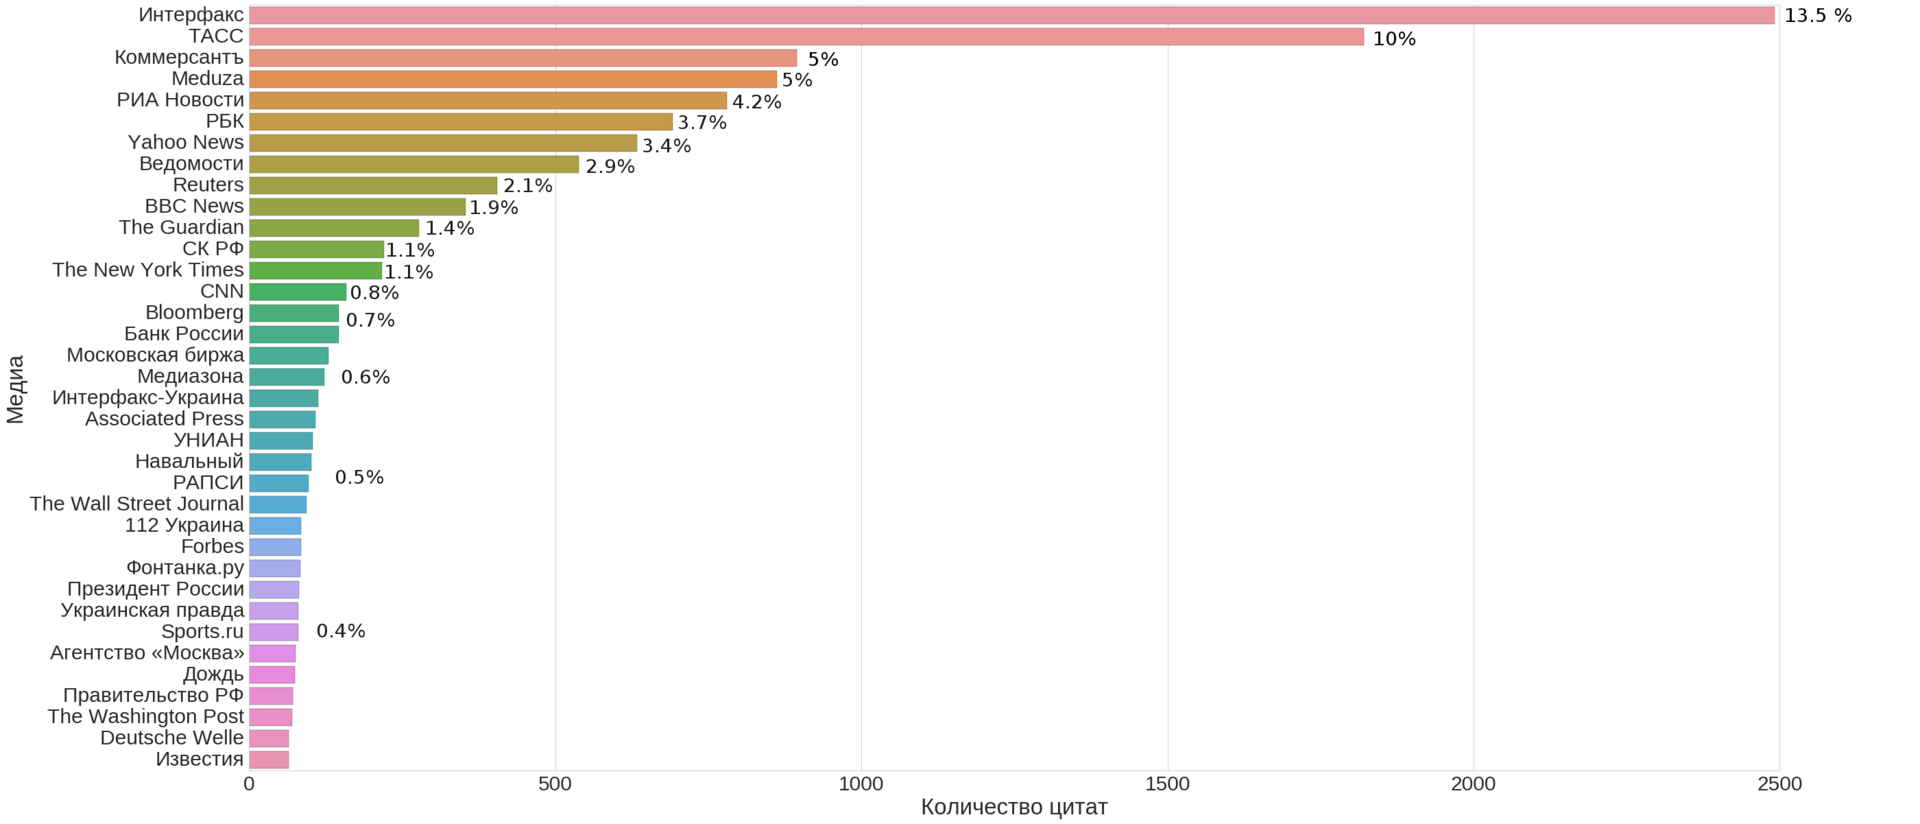
(это не просто КДПВ, а топ-35 медиа по числу новостей указанных в качестве источника на сайте Meduza, включая её саму)
Конкретизируем и формализуем вопросы:
- Q1: Из каких ключевых источников состоит лента новостей?
Иначе говоря, можем ли мы выбрать небольшое число источников достаточно покрывающих всю ленту новостей?
- Q2: Есть ли на них какая-то простая и интерпретируемая структура?
Проще говоря, можем ли мы кластеризовать источники в осмысленные группы?
- Q3: Можно ли по этой структуре определить общие параметры агрегатора?
Зачем нужны независимые операторы больших данных, которые будут хранить цифровую личность человека
2016-08-08 в 15:38, admin, рубрики: big data, безопасность, инвестиции, кейсы, колонка, советы, метки: big data, безопасность, инвестиции, кейсы, колонка, советыПрофессор компьютерных наук и инженерии Вашингтонского университета Педро Домингос написал книгу «Верховный алгоритм. Как машинное обучение изменит наш мир», которая вышла в издательстве «МИФ». Редакция «Роем!» приводит выдержку из 10-ой главы «Мир машинного обучения» с разрешения издательства.
Пересечение морд доменов топ 1,000,000 по N-граммам
2016-08-06 в 20:12, admin, рубрики: alexa top 1m, big data, data mining, ngram, н-граммы, открытые данные, метки: alexa top 1m, ngram, н-граммыЗадачей исследования является визуализация дуплицированности главных страниц доменов по пятисловным шинглам в рамках общей базы.