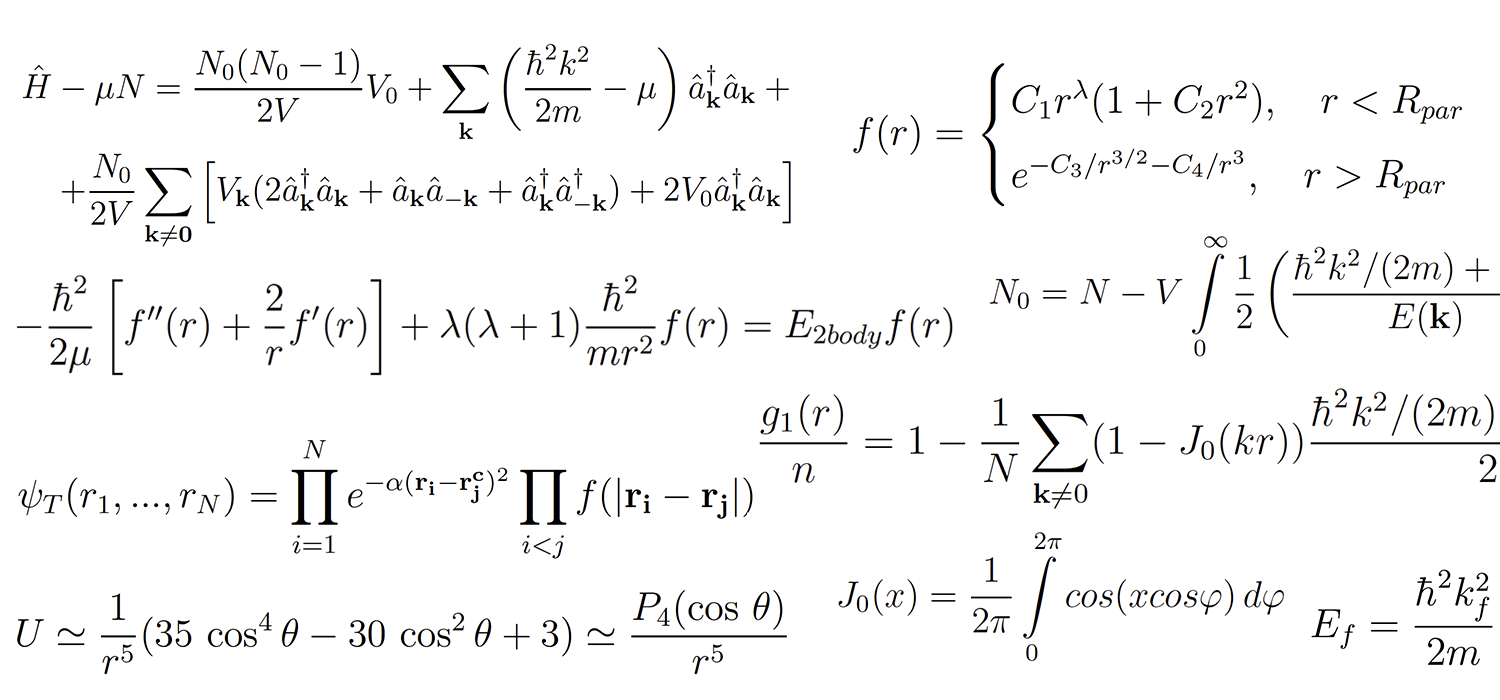Рубрика «data mining» - 32

Комментарии в последней публикации «Насколько open-source экосистема R хороша для решения бизнес-задач?» насчет выгрузок в Excel привели к мысли, что имеет смысл потратить время и описать один из апробированных возможных подходов, который можно реализовать не выходя из R.

Ситуация достаточно типична. В компании всегда есть N методик по которым менеджеры вручную стараются строить в Excel отчеты. Даже если их и втоматизировать всегда остается ситуация, когда нужно срочно сделать какой-то новый произвольный срез или сделать представление для какого-либо руководителя в специфическом виде.

А еще есть ряд вручную поддерживаемых словарей в формате excel, чтобы преобразовывать представление данных в отчетах и выборках в правильной терминологии.

В силу того, что никакого подходящего инструмента (масса доп. нюансов будет ниже) так и не удалось найти, пришлось сваять «универсальный конструктор» на Shiny+R. В силу универсальности и параметризуемости настроек, такой конструктор можно легко сажать почти на любую систему в любой предметной области.

Является продолжением предыдущих публикаций.Читать полностью »
Офлайн А-Б тестирование в ритейле - 1 Это реальная история. События, о которых рассказывается в посте, произошли в одной теплой стране в 21ом веке. На всякий случай имена персонажей были изменены. Из уважения к профессии всё рассказано так, как было на самом деле.

Привет, хабор. В этом посте речь пойдет про пресловутое А/Б тестирование, к сожалению даже в 21ом веке его не избежать. В онлайне уже давно существуют и процветают альтернативные варианты тестирования, в то время, как в офлайне приходится адаптироваться по ситуации. Об одной такой адаптации в массовом офлайн ритейле мы и поговорим, приправив историю опытом взаимодействия с одной топовой консалтинговой конторой, в общем го под кат.

Читать полностью »

К написанию статьи меня подтолкнула вот эта новость (+исследование) про изобретение генератора мемов учеными из Стэнфордского университета. В своей статье я попытаюсь показать, что вам не нужно быть ученым из Стэнфорда, чтобы делать с нейросетями интересные вещи. В статье я описываю, как в 2017 году мы обучили нейронную сеть на корпусе из примерно 30 000 текстов и заставили ее генерировать новые интернет-мемы и мемы (коммуникационные знаки) в социологическом смысле слова. Описан использованный нами алгоритм машинного обучения, технические и административные трудности, с которыми мы столкнулись.
Читать полностью »

Поводом для публикации послужила запись в блоге Rstudio: «Shiny 1.1.0: Scaling Shiny with async», которая может очень легко пройти мимо, но которая добавляет очень весомый кирпичик в задаче применения R для задач бизнеса. На самом деле, в dev версии shiny асинхронность появилась примерно год назад, но это было как бы несерьезно и «понарошку» — это же dev версия. Перенос в основную ветку и публикация на CRAN является важным подтверждением, что многие принципиальные вопросы продуманы, решены и протестированы, можно спокойно переносить в продуктив и пользоваться.

А что еще есть в R, кроме «бриллианта», что позволяет превратить его в универсальный аналитический инструмент для практических задач?

Является продолжением предыдущих публикаций.Читать полностью »

В прошлой статье я описал использование когортного анализа для выяснения причин динамики клиентской базы. Сегодня пришло время поговорить про трюки подготовки данных для когортного анализа.

Легко рисовать картинки, но для того, чтобы они считались и отображались правильно “под капотом” нужно проделать немало работы. В этой статье мы поговорим о том, как реализовать когортный анализ. Я расскажу про реализацию при помощи Excel, а в другой статье при помощи R.

Хотим мы этого или нет, но по факту Excel это инструмент анализа данных. Более “высокомерные” аналитики будут считать, что это слабый и не удобный инструмент. С другой стороны по факту сотни тысяч людей делают анализ данных в Excel и в этом отношении он легко побьет R / python. Конечно, когда мы говорим о advances analytics и машинном обучении, мы будем работать на R / python. И я был бы за то, чтобы большая часть аналитики делалась именно этими инструментами. Но стоит признать факты, в Excel обрабатывают и представляют данные подавляющее большинство компаний и именно этим инструментом пользуются обычные аналитики, менеджеры и product owners. Вдобавок Excel трудно победить в части простоты и наглядности процесса, т.к. вы мастерите свои расчеты и модельки буквально руками.

И так, как же нам сделать когортный анализ в Excel? Для того, чтобы решать подобные задачи нужно определить 2 вещи:

  1. Какие данные у нас в начале процесса

  2. Как должны выглядеть наши данные в конце процесса.

    Читать полностью »

27–31 августа в Казани пройдет 12-я летняя школа по информационному поиску RuSSIR 2018.

Её организуют Казанский Федеральный Университет (КФУ) и Российский семинар по Оценке Методов Информационного Поиска (РОМИП).

Главная тема школы в этом году — медицинские и гуманитарные приложения.

RuSSIR 2018: 12-я летняя школа по информационному поиску - 1

Программа включает два пленарных доклада и семь курсов, а также постер-сессию конференции молодых ученых «RuSSIR Young Scientist Conference».

Пленарные доклады:

  1. Carlos Castillo (Universitat Pompeu Fabra), «Crisis Informatics» — о том, как использовать данные из социальных сетей для борьбы с чрезвычайными ситуациями;
  2. Carlos Castillo, «The Biases of Social Data» — о подводных камнях при анализе пользовательского контента;

Курсы:

  1. Cathal Gurrin (Dublin City University), «The Information Retrieval Challenge of Lifelogs and Personal Life Archives» — об анализе персональных данных;
  2. Henning Müller (University of Geneva), «Evaluation of IR systems and multi-modal retrieval in the medical domain» — о поиске медицинских изображений;
  3. Valentin Malykh, Mikhail Burtsev (Moscow Institute of Physics and Technology), «Conversational AI through Deep Learning» — о том, как создать интеллектуального чат-бота с помощью глубокого обучения;
  4. Rishabh Mehrotra (Spotify Research), «Learning from User Interactions» — о том, как угадать потребность пользователя из его взаимодействия с онлайн-системой;
  5. Guido Zuccon (Queensland University of Technology), «Health Search» — о поиске по медицинским данным;
  6. Harrie Oosterhuis (University of Amsterdam), «Learning to Rank and Evaluation in the Online Setting» — о том, как обучить систему на основе данных о взаимодействии с пользователем;
  7. Prasenjit Mitra (Pennsylvania State University), «Retrieving Information Interactively Using Natural Language» — о том, как научить систему общаться на естественном языке.

Участие в школе бесплатное. Регистрация открыта до 10 июля. Читать полностью »

image

Моя специальность — физика конденсированного состояния. Разумеется, в процессе погружения в нее требуется изучать много научных статей, однако на разбор хотя бы одной может уйти немало времени. На arxiv в разделе cond-mat публикуется более тысячи статей в месяц. Складывается ситуация, когда многие исследователи, особенно начинающие, не обладают целостным видением своей области науки. Описанный в этой статье инструмент резюмирует содержимое базы научных статей и призван ускорить работу с литературой.
Читать полностью »

Второй блин: анонс SmartData 2018 - 1

Чем первое проведение конференции отличается от второго? При подготовке первой нет ни возможности «сделать как раньше», ни зрительского фидбэка, и организаторам приходится делать смелые предположения. Это не значит, что получится плохо. Но это значит, что после первого раза непременно появятся новые соображения, которые помогут во второй.

В прошлом году мы впервые провели конференцию SmartData, а теперь пришло время «второго раза»: анонсируем SmartData 2018, которая состоится 15 октября в Санкт-Петербурге.

Чего ждать от конференции? Кому стоит на неё идти? Что изменилось по сравнению с прошлым годом? Рассказываем обо всём под катом.
Читать полностью »

image

Что мешает успешно совместить математику и бизнес?

Этот текст — первая из серии статей о том, как корректно встроить инструменты big data с выгодой для бизнеса.

Маленький спойлер: все получится, если помнить о самом бизнесе.

Еще 5 лет назад крупные компании хотели внедрить у себя новомодную “бигдату”. Но настоящих экспериментаторов было мало. Исключениями стали те, кто точно обладал массой данных: телеком, банковский сектор, интернет-компании. А в 2018 году за экспертизой в больших данных бизнесы приходят сами, причем из самых неожиданных отраслей: металлургия, страхование, авиаиндустрия.Читать полностью »

Новый чемпионат ML Boot Camp VI. Прогноз отклика аудитории на интернет-опрос - 1

Сегодня, 25 июня, стартует ML Boot Camp VI с задачей «Прогноз отклика аудитории на интернет-опрос» (если вы вдруг впервые слышите, что такое ML Boot Camp, заходите под спойлер).
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js