Рубрика «data mining» - 66

Волею судеб, ко мне в руки попали данные о заработных платах, премиях и сверхурочных множества госслужащих одного крупного портового города, от мэра до сторожа бассейна. Не теряя ни минуты, я бросился вгрызаться в цифры. Нет ничего любопытнее, чем смотреть на чужие зарплаты, особенно, когда можно оправдать себя тем, что занимаешься Data Science!

Как только прошли первые приступы зависти, я осознал, что в датасете присутствует информация не только по крупным руководителям, но и по рядовым сотрудникам от самого низкого уровня. Получается, что по этим данным можно воочию наблюдать основные закономерности в распределении доходов в реальном мире. Пользуясь случаем, я приглашаю всех диванных экономистов в увлекательное турне в мир роскошных окладов и скупой статистики!

Сегодня мы поговорим про средние и медианные зарплаты, индекс социального неравенства Джини, отношения между богатыми и бедными (индекс Rich/Poor), непреодолимый разрыв доходов (эффект Матфея) и карьерный рост.

San-FranciscoЧитать полностью »

Прием докладов на конференцию по искусственному интеллекту и большим данным AI&BigData Lab - 1

4 июня в Одессе, наша команда FlyElephant совместно с GeeksLab будет проводить третью ежегодную техническую конференцию по искусственному интеллекту и большим данным — AI&BigData Lab.

Читать полностью »

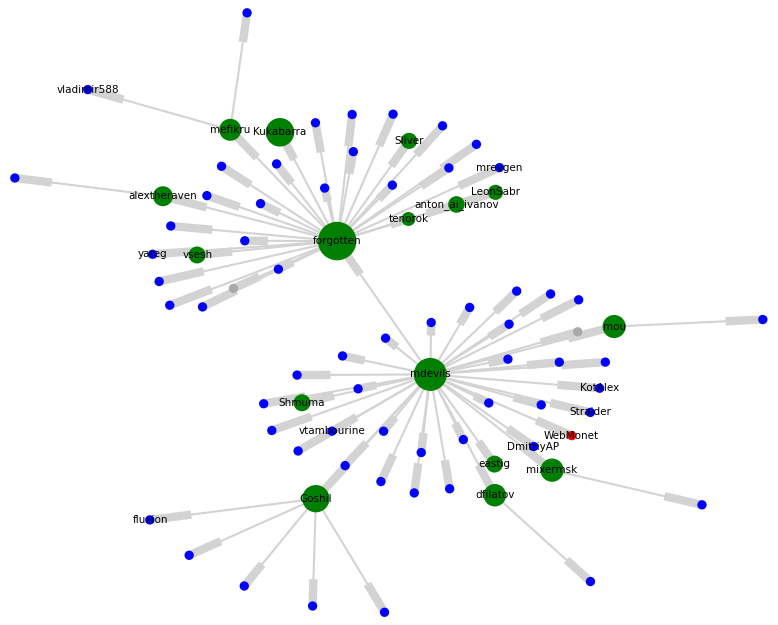
Около месяца назад я опубликовал статью о хабракотах на хабре. Побочным продуктом этой статьи оказался дамп страниц хабрапользователей, и мне захотелось извлечь ещё какую-нибудь информацию из него. На хабре регулярно появляются статьи об анализе пользователей, статей, комментариев, кармы, но я не нашёл ни одной статьи, в которой анализировались бы хабраинвайты. Поэтому я построил граф хабраинвайтов и посмотрел на некоторые его характеристики.

Хабракланы - 1
Читать полностью »

Речь пойдёт об использовании Apache Spark для анализа поведенческих факторов на сайте, который имеет очень большую посещаемость. Учёт поведенческих факторов весьма часто используется для повышения конверсии ресурса. Кроме этого, возможности Интернет позволяют очень просто и быстро собирать и анализировать гигантское количество самой разной статистической информации. Будут показаны примеры кода и даны некоторые советы, основанные на личном опыте автора статьи.
Читать полностью »

Если Вам не очень повезло, и на работе нет n-ядерного монстра, которого можно загрузить своими скриптами, то эта статья для Вас. Также если Вы привыкли запускать скрипты на всю ночь (и утром читать, что где-то забыли скобочку, и 6 часов вычислений пропали) — у Вас есть шанс наконец познакомиться с Amazon Web Services.

16 ядер и 30 Гб под капотом Вашего Jupyter за $0.25 в час - 1

В этой статье я расскажу, как начать работать с сервисом EC2. По сути это пошаговая инструкция по полуавтоматической аренде спотового инстанса AWS для работы с Jupyter-блокнотами и сборкой библиотек Anaconda. Будет полезно, например, тем, кто в соревнованиях Kaggle все еще пользуется своим игрушечным маком.

Читать полностью »

Пару недель назад, наша команда выпустила свежий релиз FlyElephant — платформа для ученых, которая предоставляет готовую вычислительную инфраструктуру для проведения расчетов, помогает находить партнеров и совместно работать над проектами, а также управлять всеми данными из одного места.

В качестве вычислительного ресурса сейчас используется облако Azure, а пользователи могут запускать вычислительные задачи, написанные с помощью С++ (с поддержкой OpenMP), R, Python, Octave, Scilab, Java, Julia, OpenFOAM, GROMACS, Blender на серверах с количеством ядер от 1 до 32 и оперативной памятью до 448 ГБ.

Сегодня мы хотим поделиться видео-туториалсами запуска задач во FlyElephant. Под катом вы найдете видео, как запускать вычислительные задачи, написанные с помощью С++, R, Python, Octave и рендерить изображения с помощью Blender, а также промо-код для получения бесплатных дополнительных часов работы ваших задач.
Читать полностью »

Частотный словарь запрещенных сайтов - 1

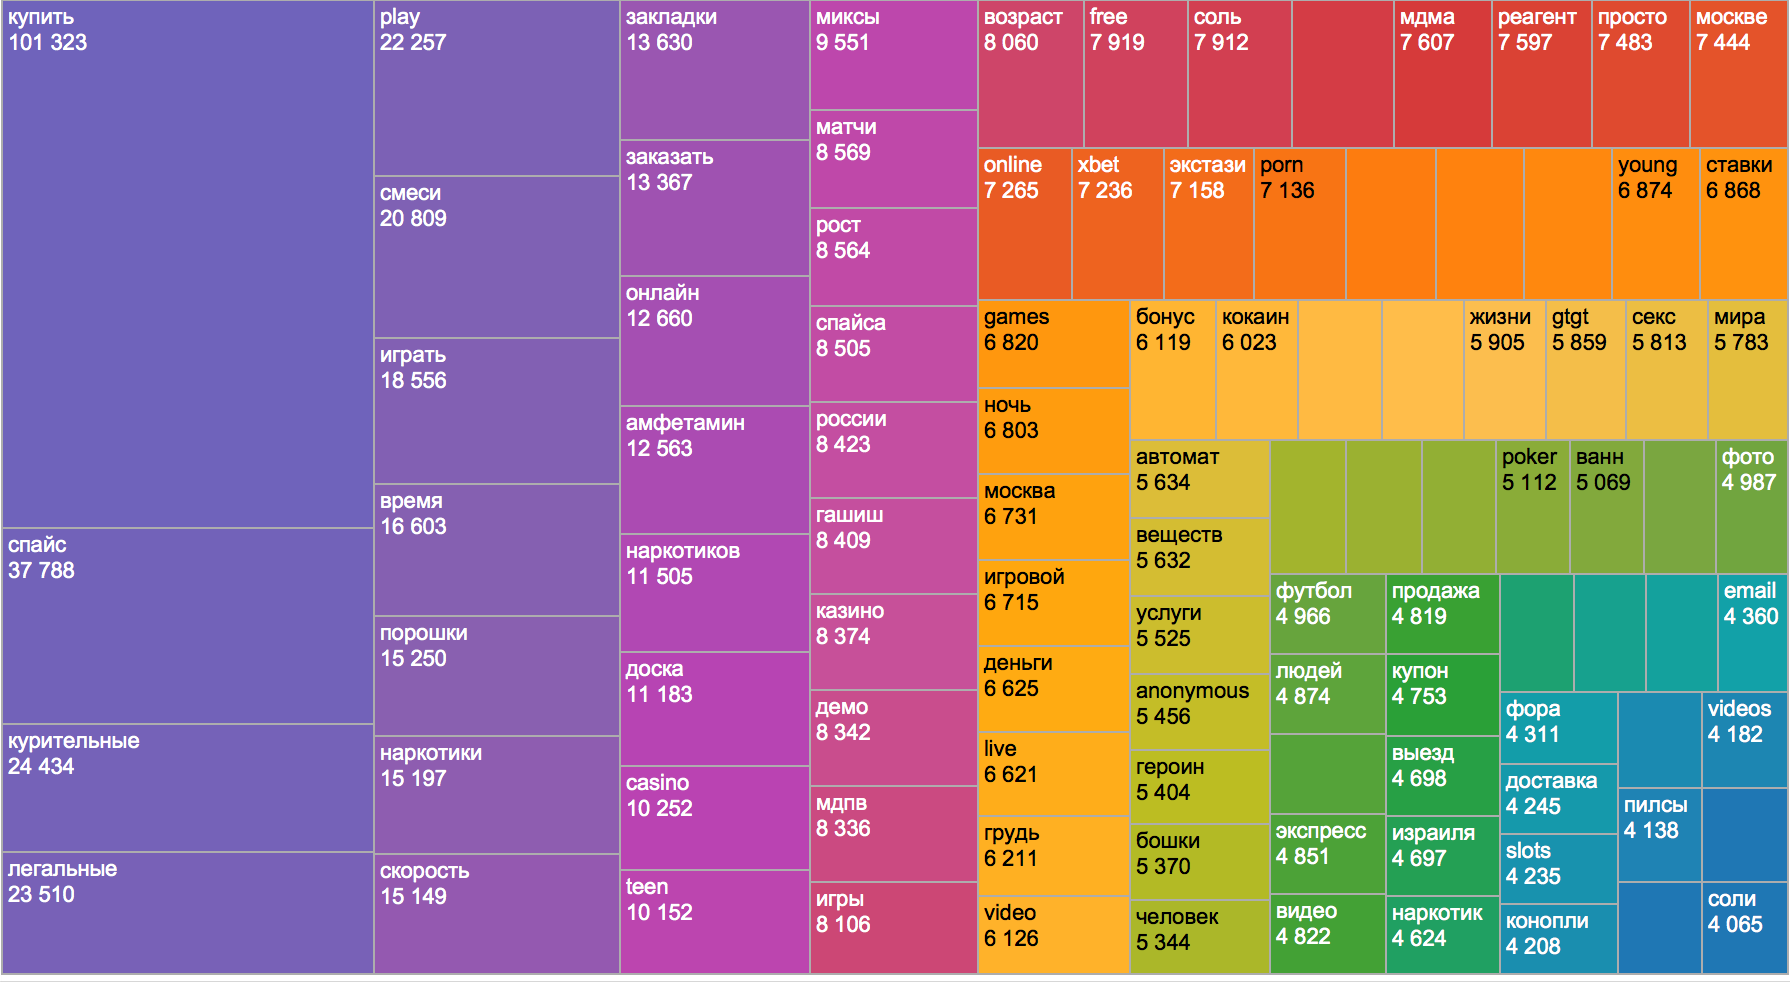
Исследование проводилось в целях создания корпуса слов сайтов, заблокированных государственными органами Российской Федерации.
Читать полностью »

Один мой приятель, учитель латинского языка, в начале урока спрашивал своих студентов, выполнили ли они домашнее задание. Как правило, если не первый, то второй или третий ученик сознавался: простите, господин Учитель, я ничего не сделал. «Фак!» — говорил учитель. «Фак!» — повторял он, вводя в еще большее недоумение своих чад. «Сегодня мы будем проходить глагол третьего спряжения facio – делать», который в повелительном наклонении единственного числа так и произносится: fac! – делай!

Нет, мы не собираемся витийствовать о том, что не бывает хороших и плохих слов, а есть наша оценка оных. Также мы не будем говорить об истоках и функциях русской брани, не будем обсуждать моральную сторону вопроса, как и искать причинно-следственные связи ее употребления. Мы проведем небольшое исследование обсценной лексики на материалах русскоязычных соц. медиа, сделаем ряд замеров и расчетов на большой выборке из интернет-источников.
Читать полностью »

Школа Данных «Билайн»: весна, знания, новый курс - 1

Привет.

Итак, третий курс Школы Данных «Билайн» подходит к завершению и мы набираем четвёртый.

У нас 18 занятий, 36 часов, все основные темы машинного обучения и анализа данных, куча практики, куча домашек, два Kaggle соревнования, презентации и воркшопы от партнеров, возможность устройства в Билайн в команду BigData для лучших студентов, сокурсники из различных областей бизнеса, где применяется машинное обучение и много чего ещё.
Читать полностью »

Введение

Недавно заглянув на КиноПоиск, я обнаружила, что за долгие годы успела оставить более 1000 оценок и подумала, что было бы интересно поисследовать эти данные подробнее: менялись ли мои вкусы в кино с течением времени? есть ли годовая/недельная сезонность в активности? коррелируют ли мои оценки с рейтингом КиноПоиска, IMDb или кинокритиков?
Но прежде чем анализировать и строить красивые графики, нужно получить данные. К сожалению, многие сервисы (и КиноПоиск не исключение) не имеют публичного API, так что, приходится засучить рукава и парсить html-страницы. Именно о том, как скачать и распарсить web-cайт, я и хочу рассказать в этой статье.
В первую очередь статья предназначена для тех, кто всегда хотел разобраться с Web Scrapping, но не доходили руки или не знал с чего начать.

Off-topic: к слову, Новый Кинопоиск под капотом использует запросы, которые возвращают данные об оценках в виде JSON, так что, задача могла быть решена и другим путем.Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js