Рубрика «data science» - 34

Приветствую коллеги! Пришло время продолжить наш спонтанный мини цикл статей, посвящённый основам машинного обучения и анализа данных.

В прошлый раз мы разбирали с Вами задачку применения линейной регрессии к открытым данным правительства Москвы, а в этот раз данные тоже открыты, но их уже пришлось собирать вручную.

Итак, сегодня мы с Вами поднимем животрепещущую тему – обращения граждан в органы исполнительной власти Москвы, нас с вами сегодня ждет: краткое описание набора данных, примитивный анализ данных, применение к ним модели линейной регрессии, а также краткая отсылка к учебным курсам для тех, кто совсем ничего не поймет из материала статьи. Ну и конечно же останется пространство для самостоятельного творчества.

Напомню, что наша статья рассчитана в первую очередь на начинающих любителей Python и его распространённых библиотек из области DataScience. Готовы? Тогда, милости прошу под кат.
«Пишите письма…» или тренируемся работать с данными по обращениям граждан в правительство Москвы (DataScience) - 1

Читать полностью »

Подходит к концу наш первый конкурс по машинному обучению и анализу данных — Multimodal Emotion Challenge Recognition (MERC-2017) на площадке Datacombats. В этом посте мы хотели бы представить небольшой анализ аудитории, своеобразный коллективный «портрет».

Коллективный портрет участников конкурса MERC-2017 - 1
Читать полностью »

Привет! Хочу поделиться своим опытом классификации пользователей социальной сети по их комментариям на два класса по складу ума: гуманитарный или технический. В данной статье не будут использоваться последние достижения глубокого обучения, но будет разобран завершенный проект по классификации текстов: от поиска подходящих данных до предсказаний. В конце будет представлено веб-приложение, в котором вы сможете проверить себя.

Классификация на гуманитариев и технарей по комментариям в VK - 1

Читать полностью »

Как построить систему аналитики для проектов с миллионами пользователей?

29 ноября, Харьков: доклад «Analytics in a Gaming Company: Big Data Architecture and Tools» - 1
Читать полностью »

Является продолжением предыдущих публикаций. Не секрет, что при упоминании R в числе используемых инструментов вторым по популярности является вопрос о возможности его применения в «промышленной разработке». Пальму первенства в России неизменно держит вопрос «А что такое R?»

Попробуем разобраться в аспектах и возможности применения R в «промышленной» разработке.

Читать полностью »

В эту субботу, 11 ноября, мы приглашаем читателей Хабра на однодневную конференцию по Data Science, Machine Learning и AI. Это мероприятие завершит Sberbank Data Science Journey, ежегодные соревнования по интеллектуальному анализу данных с применением передовых математических методов и алгоритмов. В этом году состязание проводилось на первом в своем роде русскоязычном наборе данных.

Мы наградим победителей и послушаем выступления от ведущих исследователей Nate Kushman (MIT, Microsoft Research UK), Дмитрий Ветров (ФКН ВШЭ, Bayes Group), Михаил Бурцев (МФТИ, iPavlov), Евгений Бурнаев (Сколтех, ADASE group) и Александр Тужилин (New York University, Сбербанк AI Lab). Кроме того, на специальной секции про бизнес в AI о пути своих компаний и перспективах монетизации AI расскажут основатели компаний Prisma, NTechLab, Rubbles и Vision Labs.

Подробная программа и ссылка на регистрацию — под катом.

Приглашаем на Sberbank Data Science Day 11 ноября - 1

Читать полностью »

Является продолжением предыдущих публикаций. Основное назначение публикаций — демонстрация возможностей R по решению различных "рутинных" задач по обработке данных, возникающих в бизнесе. Основной акцент ставится на создание законченного решения для конечного пользователя, а не на принципиальное решение частной задачи набором команд в консоли. Схематический прототип и продукт с конвейера имеют больше различий чем сходства.

По тонкой механике R есть огромное количество специализированных блогов, книг, а также github. Но обращаются к ним обычно только после того, как видят, что решение задачи средствами R возможно и весьма элегантно.

Читать полностью »

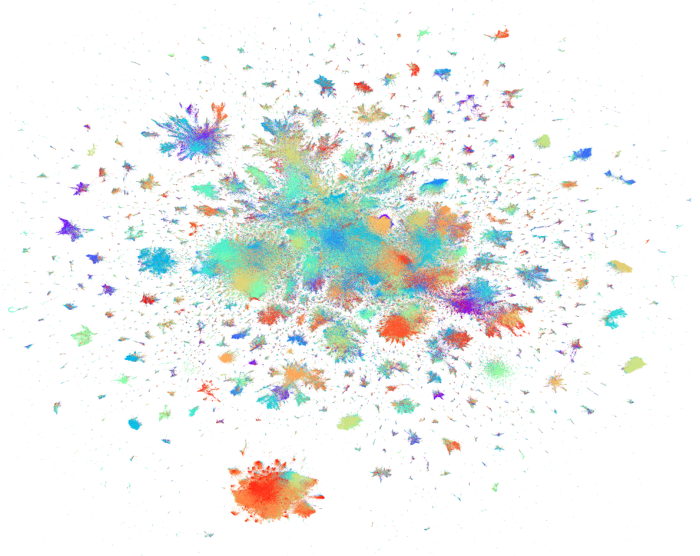
Наборами данных в миллионы экземпляров в задачах машинного обучения уже давным давно никого не удивишь. Однако мало кто задаётся вопросом, как качественно визуализировать эти титанические пласты информации. Когда размер датасета превышает миллион, становится довольно грустно использовать стандартный t-SNE; остаётся играться с даунсэмплированием или вовсе ограничиваться грубыми статистическими инструментами. Но на каждую задачу найдётся свой инструмент. В своей статье я бы хотел рассмотреть два алгоритма, которые преодолевают барьер квадратичной сложности: уже хорошо известный Barnes-Hut t-SNE и новый претендент на звание «золотого молотка infovis'a» LargeVis.

Barnes-Hut t-SNE и LargeVis: визуализация больших объёмов данных - 1

(Это не картина художника-абстракциониста, а визуализация LiveJournal-датасета с высоты птичьего полёта)
Читать полностью »

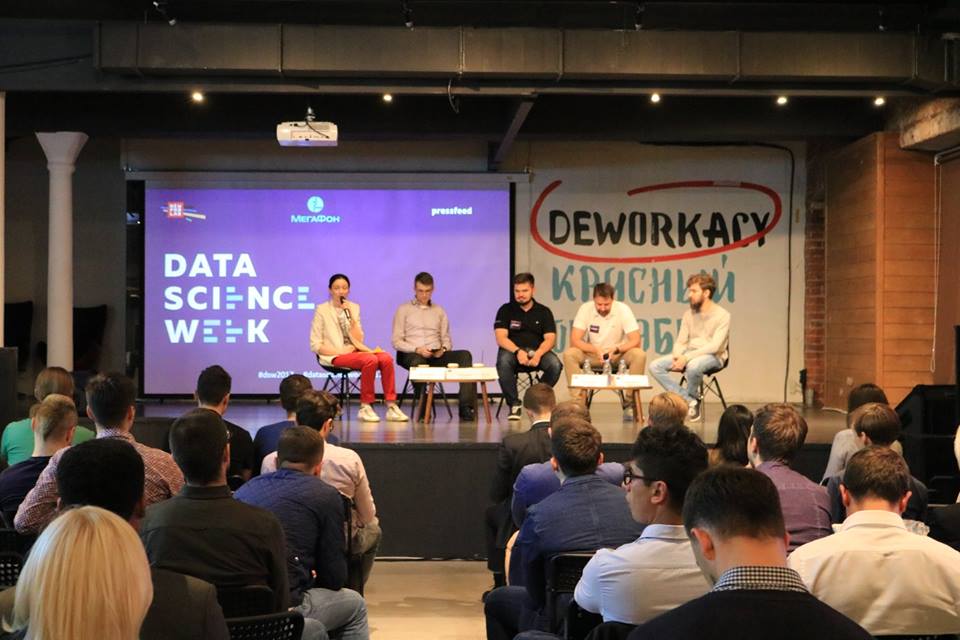
Привет! Публикуем заключительную часть обзора Data Science Week 2017, прошедшем в Москве 12-14 сентября. Сегодня расскажем о панельной дискуссии по теме “Подбор команд по работе с данными и оценка их эффективности”. Модератором выступила Ольга Филатова, вице-президент по персоналу и образовательным проектам Mail.ru Group, а участниками были Виктор Кантор (Яндекс), Андрей Уваров (МегаФон), Павел Клеменков (Rambler&Co) и Александр Ерофеев (Сбербанк).

“Главный вызов — это кадровый голод” — панельная дискуссия о подборе команд по работе с данными. Data Science Week 2017 - 1
Читать полностью »

image

Мы часто слышим такие словесные конструкции, как «машинное обучение», «нейронные сети». Эти выражения уже плотно вошли в общественное сознание и чаще всего ассоциируются с распознаванием образов и речи, с генерацией человекоподобного текста. На самом деле алгоритмы машинного обучения могут решать множество различных типов задач, в том числе помогать малому бизнесу, интернет-изданию, да чему угодно. В этой статье я расскажу как создать нейросеть, которая способна решить реальную бизнес-задачу по созданию скоринговой модели. Мы рассмотрим все этапы: от подготовки данных до создания модели и оценки ее качества.

Вопросы, которые разобраны в статье:
• Как собрать и подготовить данные для построения модели?
• Что такое нейронная сеть и как она устроена?
• Как написать свою нейронную сеть с нуля?
• Как правильно обучить нейронную сеть на имеющихся данных?
• Как интерпретировать модель и ее результаты?
• Как корректно оценить качество модели?
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js