

Логирование является важной составной частью профессиональной отладки программ. Написав небольшой логгер и изучая, как он работает, можно лучше разобраться, как работает многозадачность в операционной системе.
Логирование является важной составной частью профессиональной отладки программ. Написав небольшой логгер и изучая, как он работает, можно лучше разобраться, как работает многозадачность в операционной системе.
Добрый день, коллеги!
Я инженер по энергетике и автоматизации. Имею приличный опыт работы с инженерными системами жизнеобеспечения. Не так давно появилась идея сделать свою SCADA-систему для диспетчеризации автономных инженерных систем.
Потихоньку начал изучать материал и в итоге дошёл до идеи написания вычислительного ядра. Оно довольно простое, но при этом, легко масштабируемое и предсказуемое. Системы, которыми предполагается управлять, относятся к объектам критической инфраструктуры, поэтому вопрос архитектуры, отказоустойчивости и предсказуемости поведения для меня был принципиален с самого начала.
Синхронизация в Java часто воспринимается как простая языковая конструкция — достаточно использовать ключевое слово synchronized, и код начинает «просто работать».
На практике же на уровне JVM происходит цепочка событий, которую можно проследить до Mark Word — восьмибайтового служебного поля заголовка каждого Java-объекта.
Современные JVM (HotSpot, OpenJ9, GraalVM) не используют фиксированную модель блокировок. Вместо этого они динамически выбирают стратегию синхронизации, исходя из реального поведения потоков и истории использования объекта.

Go (Golang) создан для эффективной параллельной и конкурентной работы. Его killer feature — легковесные потоки выполнения, называемые горутины (goroutines), и мощные средства синхронизации. Приглашаю разобраться подробно.

Как правило, в Go для безопасного доступа к общим данным используются мьютексы. Да, каналы тоже можно приспособить для изменения общих данных, так как они потокобезопасны, но это усложняет и замедляет логику.
Но в этой статье мы поговорим о другом. Современные процессоры имеют поддержку атомарных операций, что позволяет на основе них организовывать работу с общими данными до нескольких раз быстрее, чем с помощью общепринятых вариантов. Так как мьютексы реализованы на основе ОС, каналы сделаны на основе внутреннего кода Go с использованием тех же мьютексов из ОС под капотом, а атомарные операции делает сам процессор аппаратно за существенно меньшее количество тактов.Читать полностью »
Атомики в Go - это один из методов синхронизации горутин. Они находятся в пакете стандартной библиотеки sync/atomic. Некоторые статьи сравнивают atomics с mutex, так как это примитивы синхронизации низкого уровня. Они предоставляют бенчмарки и сравнения по скорости, например Go: How to Reduce Lock Contention with the Atomic Package.
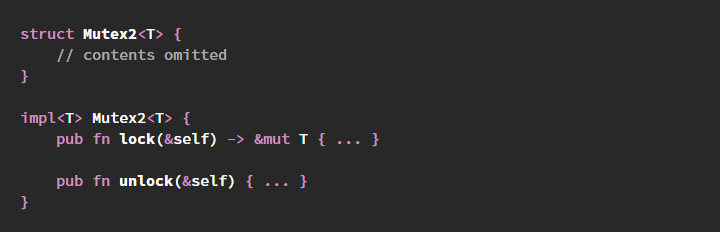
Я часто слышу от пробующих работать с Rust системных программистов жалобы на мьютексы и особенно на Rust Mutex API. Жалобы обычно выглядят так:
unlock, потому что им кажется, что это более явное действие.
Такие изменения превратили бы Rust mutex API в эквивалент C/Posix mutex API. Однажды я даже видел, как один разработчик пытался использовать Mutex<()> и разные хитрости, чтобы его имитировать.
Однако у такого стремления есть проблема: эти два аспекта Mutex неразрывно связаны друг с другом, а также с гарантиями безопасности Rust в целом — изменение одного из них или обоих откроет возможности для возникновения незаметных багов и повреждений из-за гонок данных.
Использование API мьютексов в стиле C, состоящего из набора косвенно защищаемых данных и из функций lock и unlock было бы опрометчивым в Rust, потому что это позволяет безопасному коду легко вносить ошибки, нарушающие безопасность памяти и вызывающие гонки данных.
Прозвучит спорно, но я утверждаю, что это справедливо и для C. Просто в Rust это более очевидно, поскольку Rust тщательно разделяет понятия «безопасного» кода, в который невозможно внести подобные ошибки, и «небезопасного» кода, в который можно вносить такие ошибки. В C такого разделения нет, и в результате этого использующий мьютексы код на C может тривиальным образом создавать серьёзные баги, которые потенциально можно подвергать эксплойтам.
В этом посте я разберу типичный C mutex API, сравню его с типичным Rust mutex API, и расскажу о том, что произойдёт, если мы изменим Rust API так, чтобы он напоминал C.
Читать полностью »
Предположим, у вас в коде есть критическая секция, которая не должна выполняться более, чем одним потоком одновременно.
В мире Java одним из стандартных решений является добавление ключевого слова synchronized к сигнатуре метода. В Kotlin для получения того же эффекта используется аннотация @Synchronized
Читать полностью »
Хабр, как известно, не место для игр, но мы нашли одно исключение, которое, как нам кажется, достойно упоминания здесь!
Встречайте: Deadlock Empire!
Суть игры — управление планировкой потоков, код которых приведен в заданиях. Управлять нужно так, чтобы добиться ошибочной ситуации: взаимблокировки, повторных значений счетчиков, достижения определенных участков кода и прочих непредвиденных ситуаций, которые нужно осознавать при разработке многопоточных приложений.
Читать полностью »
Одним из нововведений в Go 1.9 было добавление в стандартную библиотеку нового типа sync.Map, и если вы ещё не разобрались что это и для чего он нужен, то эта статья для вас.
Для тех, кому интересен только вывод, TL;DR:
если у вас высоконагруженная (и 100нс решают) система с большим количеством ядер процессора (32+), вы можете захотеть использовать sync.Map вместо стандартного map+sync.RWMutex. В остальных случаях, sync.Map особо не нужен.

Если же интересны подробности, то давайте начнем с основ.