
Данный пост является продолжением авторского перевода статьи «Flow Graphs, Speculative Locks, and Task Arenas in Intel® Threading Building Blocks» из Parallel Universe Magazine, выпуск 18, 2014. В этой половине статьи мы рассмотрим спекулятивные замки (speculative locks), которые используют преимущества технологии Intel® Transactional Synchronization Extensions и управляемые пользователем арены для задач (user-managed task arenas), которые обеспечивают расширенный контроль и управление уровнем параллелизма и изоляции задач. Если Вас заинтересовало — добро пожаловать под кат.
Читать полностью »
Рубрика «параллельное программирование» - 29
Вычислительные Графы, Спекулятивные Замки и Арены для Задач в Intel® Threading Building Blocks (продолжение)
2014-07-28 в 6:14, admin, рубрики: c++, c++ библиотеки, c++11, intel parallel studio, intel tbb, intel threading building blocks, tbb, Блог компании Intel, параллельное программирование, ПрограммированиеКак работает GIL в Ruby. Часть 3. Делает ли GIL ваш код потоко-безопасным?
2014-07-23 в 8:26, admin, рубрики: GIL, ruby, многопоточное программирование, многопоточность, параллельное программирование, потоки 
Переводы предыдущих двух частей:
Первая часть
Вторая часть
Это статья Jesse Storimer. Он выступает на семинаре Unix fu, онлайн классе для Ruby-разработчиков, которые хотят научиться удивительным хакам в Ruby и повысить свой уровень в разработке серверного стека. Количество участников ограничено, так что поторопитесь, пока есть свободные места. Так же, он является автором книг «Работа с Unix процессами», «Работа с TCP сокетами» и «Работа с потоками в Ruby».
В Ruby-сообществе существуют некоторые заблуждения относительно GIL в MRI-реализации интерпретатора. Если вы хотите узнать ответ на главный вопрос этой статьи, без ее прочтения, то вот он: GIL не делает ваш код на Ruby потоко-безопасным.
Но вы не должны принимать мои слова на веру.
Читать полностью »
Параллелим непараллельное или поиск простых чисел на GPU
2014-07-18 в 17:46, admin, рубрики: gpgpu, gpgpu (nvidia cuda), Алгоритмы, параллельное программированиеОдним замечательным летним вечером, я в пылу спора имел глупость заметить, что можно написать быстро работающее решето Эратосфена на CUDA. N = 1000000000 (девять нулей) как цель. And the legend has begun…
Не буду опускаться в подробности алгоритма, о нем можно почитать, например, тут и сразу покажу код, которым я располагал на тот момент:
#include <iostream>
#include <math.h>

using namespace std;

int main()
{
	double number = 1000000000;
	bool* a = new bool[int(number/2)];
	int i,j,result;

	for (i=0; i<number/2; i++)
		a[i] = true;

	for (i=3; i<=floor(sqrt(number)); i+=2)
		if (a[i/2])
			for (j=i*i; j<=number; j+=i*2)
				a[j/2]=false;

	result = 0;
	for (i=0; i<number/2; i++)
		if (a[i]) result++;

	cout << result << endl;

	delete[] a;

	return 0;
}
Однопоточный немного оптимизированный код, который работает на 14-15 секунд на Core i3 330M и затрачивает большое количество памяти. С него и начнем.
Читать полностью »
Вычислительные Графы, Спекулятивные Замки и Арены для Задач в Intel® Threading Building Blocks
2014-07-15 в 5:48, admin, рубрики: c++, c++ библиотеки, c++11, intel parallel studio, intel tbb, intel threading building blocks, tbb, Блог компании Intel, параллельное программирование Данный пост является переводом статьи «Flow Graphs, Speculative Locks, and Task Arenas in Intel® Threading Building Blocks» из Parallel Universe Magazine, выпуск 18, 2014. Если вас интересует библиотека Intel® TBB в частности, и интересные современные концепции параллельного программирования в общем, то — добро пожаловать под кат.
Читать полностью »
Возобновились продажи Parallella board от Adapteva
2014-06-28 в 13:09, admin, рубрики: dsp, параллельное программирование, системное программирование, метки: dspЗдравствуйте.

Компания Adapteva в четверг, 26 июня, разослала всем о возобновлении продаж их open source плат Parallella board. Сами продажи начались вчера. На хабре ранее упоминалось, например здесь habrahabr.ru/post/168897/.
Читать полностью »
Java Multicore Programming: Lecture #1
2014-05-16 в 13:20, admin, рубрики: java, multithreading, Блог компании GolovachCourses, многопоточное программирование, параллельное программирование, метки: java, multithreading, многопоточное программирование Добрый день.
15 мая была проведен первый вебинар (из 16) курса «Multicore programming in Java». Вебинары, видео в записи, исходный код программ и проверка заданий доступны только записавшимся на курс (запись еще открыта, свяжитесь по контактам внизу страницы). Но тут я бы хотел опубликовать материалы, упоминавшиеся на лекции: ссылки на источники, термины, картинки, задание. Возможно кто-то сочтет их полезными для себя.
Введение
- Закон Мура, Moore’s law
- Herb Satter, “The Free Lunch Is Over”
- Закон Амдала, Amdahl’s law
“Железо”
Стоит «посмотреть картинки» в следующих источниках
Проба пера на суперкомпьютере Ломоносов
2014-04-25 в 19:31, admin, рубрики: mpi, математика, параллельное программирование, параллельные вычисления 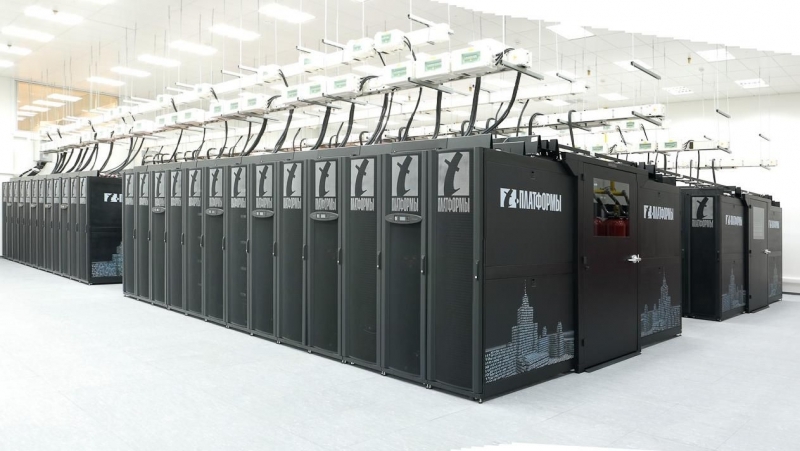
В этом посте я хочу рассказать о своём опыте расчётов на суперкомпьютере Ломоносов. Я расскажу о решении задачи, честно говоря, для которой не нужно использовать СК, но академический интерес превыше всего. Подробную информацию о Читать полностью »
Вышел Rust 0.10
2014-04-05 в 16:54, admin, рубрики: Rust, параллельное программирование, Программирование, системное программирование, метки: Rust 
Rust — это компилируемый мультипарадигмальный язык, позиционируется как альтернатива С/С++ с уклоном в параллельные вычисления, безопасность и удобство работы с памятью.
Что нового в Rust 0.10:
Читать полностью »
Реализация алгоритма BFS на GPU
2014-03-07 в 9:01, admin, рубрики: bfs, CUDA, gpgpu, gpu, Kepler, Nvidia, параллельное программирование, метки: bfs, CUDA, gpgpu, gpu, Kepler, NvidiaАннотация
В данной статье хочу рассказать как можно эффективно распараллелить алгоритм BFS — поиск в ширину в графе с использованием графических ускорителей. В статье будет приведен подробный анализ полученного алгоритма. Вычисления выполнялись на одном GPU GTX Titan архитектуры Kepler.
Введение
В последнее время все большую роль играют графические ускорители (GPU) в не графических вычислениях. Потребность их использования обусловлена их относительно высокой производительностью и более низкой стоимостью. Как известно, на GPU хорошо решаются задачи на структурных сетках, где параллелизм так или иначе легко выделяется. Но есть задачи, которые требуют больших мощностей и используют неструктурные сетки. Примером такой задачи является Single Shortest Source Path problem (SSSP) – задача поиска кратчайших путей от заданной вершины до всех остальных во взвешенном графе. Решение данной задачи рассмотрено мной в этой статье. Вторым примером задачи на неструктурных сетках является задача Breadth First Search (BFS) — поиска в ширину в неориентированном графе. Данная задача является основной в ряде алгоритмов на графах. Также она немного проще, чем поиск кратчайшего пути. На данный момент алгоритм BFS используется как основной тест для рейтинга Graph500. Далее рассмотрим, как можно использовать идеи решения задачи SSSP в задаче BFS. Про архитектуру GPU компании Nvidia и об упомянутых алгоритмах уже много написано, поэтому в этой статье я не стану дополнительно писать про это. Так же, надеюсь, что понятия warp, cuda блок, SMX, и прочие базовые вещи, связанные с CUDA читателю знакомы.
Читать полностью »
Умный видеоплеер или просто распознавание жестов
2014-02-21 в 9:54, admin, рубрики: c++, computer vision, qt, qt quick, Qt Software, обработка изображений, параллельное программирование, метки: c++, computer vision, Qt, qt quick, параллельное программированиеВведение
В этой статье речь пойдёт о распознавании жестов. Я считаю, что эта тема на сегодняшний день очень актуальна, потому что этот способ ввода информации более удобен для человека. В YouTube можно увидеть много роликов про распознавание, отслеживание предметов, в хабре тоже есть статьи по этой теме, так вот, я решил поэкспериментировать и сделать что-то своё, полезное и нужное. Я решил сделать видеоплеер, которым можно управлять жестами, потому что сам иногда очень ленюсь взяться за мышку, найти этот ползунок и перемотать чуть-чуть вперёд или чуть-чуть назад, особенно, когда смотрю фильмы на иностранном языке (там приходится часто перематывать назад).
В статье, в основном, речь будет идти о том, как я реализовал распознавание жестов, а о видеоплеере я только скажу в общем.
Читать полностью »