Рубрика «python» - 147

Legacy-код — это «старый» код, возраст которого может быть как 2 месяца, так и 10 лет. Часто его писали разработчики, о которых в компании смутно помнят. Возможно, их вообще не было, а legacy-код родился вместе со Вселенной во время Большого Взрыва. С тех пор требования к нему менялись много раз, код правили в режиме «нужно было еще вчера», а документацию никто не писал, как и тесты. Legacy-код запутан и хрупок, в нем не видно ни начала, ни конца. Как к нему подступиться?
Укрощая зверя: legacy-код, тесты и вы - 1
Здесь и далее кадры из сериала «Рик и Морти». Авторы Джастин Ройланд и Дэн Хармон.

Подбираться к нему нужно с тестов, но готовьтесь к боли. Проблемы начнутся уже с того момента, как вы решите взяться за такой проект. Вам нужно понять, зачем вы хотите за него браться, убедить руководство одобрить тестирование legacy-кода, а коллег — помочь. После этого возникнут вопросы, с чего начать изучение, какие тесты запустить первыми и как все не сломать? Но главное — как не впасть в отчаяние, когда поймете, что работе нет конца.

Кирилл Борисов 12 лет в индустрии, за эти годы прошел долгий путь по костылям, битому коду и гниющим каркасам старых систем: от монолитных учетных систем до микросервисов авторизации. Путешествие наградило его опытом и историями, которыми он поделится в виде ценных советов.Читать полностью »
Недавно на стендапе коллега внес рацпредложение: автоматизировать сборку релизов, взяв за основу готовые уже наработки по взаимодействию с Jira, написанные на Python.

Процесс деплоя у нас следующий: когда накапливается достаточное количество задач, прошедших тестирование из них собирается Релиз-кандидат (RC) в каждом проекте, затронутом задачами, затем задачи тестируются в составе RC. После этого RC заливается на стейджинг сервер, где в близком к боевому окружении все еще раз тестируется и проводится полный регресс. И затем, после необходимых деплойных действий свежий релиз заливается в мастер.

До недавнего времени весь процесс сборки проводился кем-либо из разработчиков вручную. Что отнимало час, два и больше времени и было, мне кажется, не очень интересным занятием. Теперь же, когда уже почти все готово, релиз из 20 задач, затрагивающий 5 проектов, собирается меньше минуты. Остается, конечно еще разрешение конфликтов, запуск пропущенных тестов и прочее, но даже с учетом этого, времени разработчиков и тестировщиков, вынужденных ждать, пока кто-то и первых освободится и создаст RC, экономится немало.

В общем, приступил я к задаче, и она оказалась очень интересной и увлекательной. А что еще надо для удовольствия от работы, как не увлекательных проектов?
Читать полностью »

CoLab блокнот с примерами

Возможно сделать скользящее окно (rolling window, sliding window, moving window) по массивам NumPy на языке программирования Python без явных циклов. В данной статье рассматривается создание одно-, двух-, трех- и N-мерных скользящих окон по массивам NumPy. В результате скорость обработки данных увеличивается в несколько тысяч раз и сравнима по скорости с языком программирования С.

Cкользящее окно применяется в: обработке изображений, искусственных нейронных сетях, интернет протоколе TCP, обработке геномных данных, прогнозировании временных рядов и т.д.

Отказ от ответственности: в исходном коде могут быть ошибки! Если вы видите ошибку, пожалуйста, напишите мне.

Читать полностью »

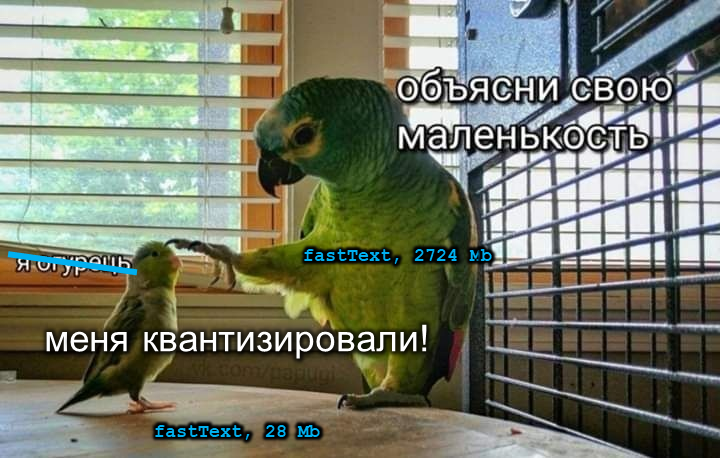
Модель fastText — одно из самых эффективных векторных представлений слов для русского языка. Однако её прикладная польза страдает из-за внушительных (несколько гигабайт) размеров модели. В этой статье мы показываем, как можно уменьшить модель fastText с 2.7 гигабайт до 28 мегабайт, не слишком потеряв в её качестве (3-4%). Спойлер: квантизация и отбор признаков работают хорошо, а матричные разложения — не очень. Также мы публикуем пакет на Python для этого сжатия и пример компактной модели для русских слов.
Как сжать модель fastText в 100 раз - 1

Читать полностью »

Доброго времени суток всем.

На сегодняшний день Python является одним из наиболее используемых языков в сфере создания не только непосредственно программных продуктов, но также обеспечения их инфраструктуры. Вследствие этого многим девопсам, по их воле или против оной, пришлось учить новый язык для последующего использования в качестве дополнения к старым добрым Bash-скриптам. Однако Bash и Python исповедуют различные подходы к написанию кода и имеют определенные особенности, в виду чего портирование Bash-скриптов на «змеиный язык» иногда оказывается ёмкой и далеко не тривиальной задачей.

Чтобы упростить жизнь девопсам, создано и продолжает создаваться много полезных библиотек и утилит на Python. Данная статья описывает сразу две новых библиотеки, созданные автором сего поста — smart-env и python-shell — и призванные избавить девопса от необходимости уделять много внимания тонкостям работы с Python, оставляя простор для более интересных задач. Сфера деятельности библиотек — переменные окружения и запуск внешних утилит.

Кого заинтересовало, прошу под кат.
Читать полностью »

image

Продолжаю публикацию решений отправленных на дорешивание машин с площадки HackTheBox. Надеюсь, что это поможет хоть кому-то развиваться в области ИБ. В данной статье узнаем IPv6 адрес сервера с помощью FXP, поработаем с rsync, а также запишем ssh-ключ используя SQL-инъекцию при обработке журналов логов в Postgres.

Подключение к лаборатории осуществляется через VPN. Рекомендуется не подключаться с рабочего компьютера или с хоста, где имеются важные для вас данные, так как Вы попадаете в частную сеть с людьми, которые что-то да умеют в области ИБ :)

Организационная информация

Специально для тех, кто хочет узнавать что-то новое и развиваться в любой из сфер информационной и компьютерной безопасности, я буду писать и рассказывать о следующих категориях:

  • PWN;
  • криптография (Crypto);
  • cетевые технологии (Network);
  • реверс (Reverse Engineering);
  • стеганография (Stegano);
  • поиск и эксплуатация WEB-уязвимостей.

Вдобавок к этому я поделюсь своим опытом в компьютерной криминалистике, анализе малвари и прошивок, атаках на беспроводные сети и локальные вычислительные сети, проведении пентестов и написании эксплоитов.
Читать полностью »

Перевод статьи подготовлен специально для студентов курса «Разработчик Python».


Когда вы пишете на низкоуровневом языке, таком как С, вы беспокоитесь о выборе правильного типа данных и спецификаторах для ваших целых чисел, на каждом шаге анализируете достаточно ли будет использовать просто int или нужно добавить long или даже long double. Однако при написании кода на Python вам не нужно беспокоиться об этих «незначительных» вещах, потому что Python может работать с числами типа integer любого размера.Читать полностью »

Перед Новым годом команда Михаила Sverdlove Свердлова объявила, что готова делиться обезличенными данными уроков Skyeng с внешними исследователями и стартапами. Вскоре после праздников мы поговорили с Мишей, о каких именно данных идет речь, что уже с ними делают и почему получить свой дата-сет можно, только написав ему на почту.

Делимся самым большим в РФ пластом данных по онлайн-обучению с проектами по лингвистике, персонализации, педдизайну, ML - 1

— Если вы делитесь данными, то почему бы просто не залить датасет куда-нибудь?
Самый большой корпус английского языка в России, по-моему, составляет 10 тысяч позиций. К концу января в нашей школе глобально прошло свыше 9,1 миллионов уроков — насколько знаю, большим набором именно по онлайн-образованию и урокам один-на-один обладают только китайские школы.

Мы знаем, что происходило и как менялись действия учителя и ученика за все уроки, которые мы провели, у нас есть трек истории всех упражнений по ним. Это порядка 120 метрик по учителям, а также около 300 параметров по детям двух возрастных групп (4-11 и 11-18 лет) и взрослым разных возрастов, городов, статусов (например, студентам) и так далее. И это точно не все параметры, которые мы можем собирать, — кажется можно использовать в 2-3 раза больше. На таком объеме история «вот ссылка на датасет, покрутите, кто хочет» едва ли будет работать.
Читать полностью »

Привет! Меня зовут Владимир Олохтонов, я старший разработчик в команде автоматической модерации Авито. Осенью 2019 мы запустили сервис поиска похожих изображений на основе библиотеки faiss. Он помогает нам понимать, что фотографии уже встречались в другом объявлении, даже если они достаточно серьёзно искажены: размыты, обрезаны и тому подобное. Так мы определяем потенциально фейковые публикации.

Мне бы хотелось рассказать о тех проблемах, с которыми мы столкнулись в процессе создания этого сервиса, и наших подходах к их решению.

Статья предполагает, что читатель хотя бы немного знаком с темой поиска по многомерным пространствам, поскольку дальше речь пойдёт в основном о технических деталях. Если это не так, я рекомендую сначала прочитать базовую статью в блоге Mail.ru.

Использование faiss для поиска по многомерным пространствам - 1

Читать полностью »

В прошлой статье мы описали эксперимент по определению минимального объема вручную размеченных срезов для обучения нейронной сети на данных сейсморазведки. Сегодня мы продолжаем эту тему, выбирая наиболее подходящую функцию потерь.

Рассмотрены 2 базовых класса функций – Binary cross entropy и Intersection over Union – в 6-ти вариантах с подбором параметров, а также комбинации функций разных классов. Дополнительно рассмотрена регуляризация функции потерь.

Спойлер: удалось существенно улучшить качество прогноза сети.

Настройка функции потерь для нейронной сети на данных сейсморазведки - 1
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js