
Василий Рябов из компании Aquantia объясняет, как с помощью Python можно наладить тестирование десктопных интерфейсов. Из лекции вы узнаете об инструментах open source и поддержке accessibility-технологий в библиотеке pywinauto. Видео и расшифровка в основном предназначены для тех, кто занимается тестированием софта для Windows, но про Linux и macOS автор тоже немного рассказывает.
Рубрика «python» - 270
Десктопные GUI-тесты на Python. Лекция в Яндексе
2017-08-27 в 11:58, admin, рубрики: accessibility, autohotkey, autoit, GUI, python, pywinauto, ui automation, UI Automation Testing, win32 api, Блог компании Яндекс, десктопное, Тестирование IT-систем, тестирование интерфейсов, тестирование поРешение прямой и двойственной задачи линейного программирования средствами Python
2017-08-27 в 11:20, admin, рубрики: python, scipy. optimize, двойственные задачи, Задачи линейного программирования, математика, методы оптимизации, разработка под windowsВведение
Следует отметить, что методы решения задач линейного программирования относятся не к экономике, а к математике и вычислительной технике. При этом экономисту нужно обеспечить максимально комфортные условия диалога с соответствующим программным обеспечением. В свою очередь такие условия могут обеспечивать только динамично развивающиеся и интерактивные среды разработки, имеющие в своём арсенале набор необходимых для решения таких задач библиотек. Одной из каких сред разработки программного обеспечения безусловно является Python.
Постановка задачи
В публикациях [1,2] рассматривались решения прямых задач оптимизации методом линейного программирования и был предложен обоснованный выбор решателя scipy. optimize.
Однако известно [3], что каждой задаче линейного программирования соответствует так называемая выделенная(двойственная)задача. В ней по сравнению с прямой задачей строки переходят в столбцы, неравенства меняют знак, вместо максимума ищется минимум (или наоборот, вместо минимума — максимум). Задача, двойственная к двойственной — эта сама исходная задача.
Решение двойственной задачи очень важно для анализа использования ресурсов. В данной публикации будет доказано, что оптимальные значения целевых функций в исходной и двойственной задачах совпадают (т.е. максимум в исходной задаче совпадает с минимумом в двойственной).
Оптимальные значения стоимости материала и труда будут оцениваться по их вкладу в целевую функцию. В результате будут получены «объективно обусловленные оценки» сырья и рабочей силы, которые не совпадают с рыночными ценами.Читать полностью »
Точим себе инструмент на PyQt
2017-08-27 в 10:16, admin, рубрики: python, инструменты, ПрограммированиеМне нужен был инструмент. Острый, практичный, универсальный. Отвечающий всем моим требованиям и расширяемый по моему желанию.

Но простой и удобный. Тут надо отметить, что на основной работе я не разработчик, поэтому постоянной среды программирования на рабочем компе не имею и, когда это требуется, пишу на чем придется — bat, JScript, VBA в MSOffice (да, это Windows, корпоративные системы, тут нет bash и perl «из коробки»), макросы в разном ПО и т.д. Все это помогает решить текущую задачу, но уровень и возможности маленько не те, что хотелось бы иметь.
Короче, мне нужна интегрированная среда со встроенным языком программирования, в которой я мог разбирать и конвертировать файлы, лазить в базы данных, получать отчеты, вызывать веб-сервисы, плодить запросы в джире и т.д., и т.п.
Вы скажете, что сейчас есть инструменты на любой вкус и цвет, только выбирай. Лягушка aka TOAD под Oracle, SoapUI для шины и продукты GNU и Apache для всего остального.
Но проблема в том, что все они они специализированы под одну какую-то деятельность, а с другой стороны слишком универсальны — можно сделать многое, но многими действиями. А если возможность в продукте отсутствует, то добавить ее нельзя. Либо продукт закрытый, либо нужно разрабатывать/покупать плагин, либо качать исходники и в них разбираться. А мне нужен был инструмент, в котором простые действия делаются просто, а на сложные сначала тратится немного времени и дальше опять все просто.
Читать полностью »
Как сделать проект по распознаванию рукописных цифр с дообучением онлайн. Гайд для не совсем начинающих
2017-08-25 в 11:04, admin, рубрики: cnn, data mining, deep learning, image recognition, machine learning, ods, open data science, python, TensorFlow, Блог компании Open Data Science, гайд, глубокое обучение, машинное обучение, нейронные сети, обработка изображений, проектПривет!
В последнее время машинное обучение и data science в целом приобретают все большую популярность. Постоянно появляются новые библиотеки и для тренировки моделей машинного обучения может потребоваться совсем немного кода. В такой ситуации можно забыть, что машинное обучение — не самоцель, а инструмент для решения какой-либо задачи. Мало сделать работающую модель, не менее важно качественно презентовать результаты анализа или сделать работающий продукт.
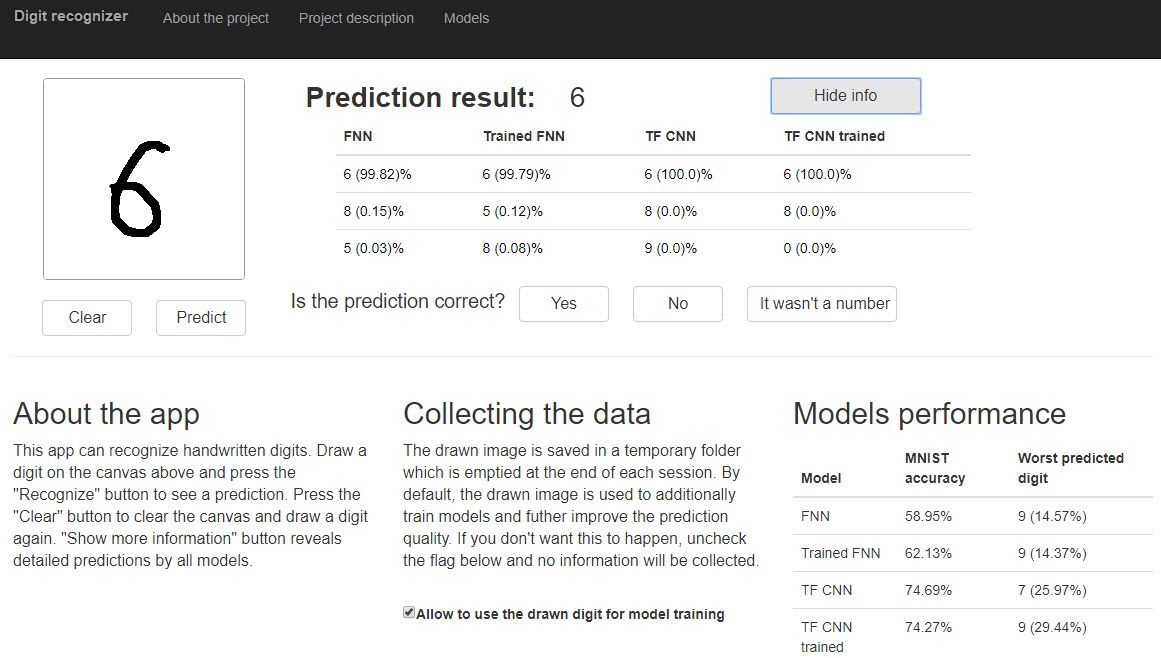
Я хотел бы рассказать о том, как создал проект по распознаванию рукописного ввода цифр с моделями, которые дообучаются на нарисованных пользователями цифрах. Используется две модели: простая нейронная сеть (FNN) на чистом numpy и сверточная сеть (CNN) на Tensorflow. Вы сможете узнать, как сделать практически с нуля следующее:
-
создать простой сайт с использованием Flask и Bootstrap;
-
разместить его на платформе Heroku;
-
реализовать сохранение и загрузку данных с помощью облака Amazon s3;
-
собрать собственный датасет;
-
натренировать модели машинного обучения (FNN и CNN);
-
сделать возможность дообучения этих моделей;
-
сделать сайт, который сможет распознавать нарисованные изображения;
Для полного понимания проекта желательно знать как работает deep learning для распознавания изображений, иметь базовые знания о Flask и немного разбираться в HTML, JS и CSS.
Как создать расистский ИИ, даже не пытаясь
2017-08-25 в 7:19, admin, рубрики: artificial intelligence, machine learning, microsoft, python, Блог компании Microsoft, искусственный интеллект, машинное обучение, ПрограммированиеНа днях, по мотивам очередной статьи, посвященной проблеме расизма в распознавании речи, я участвовала в большом споре о том, кто в этом виноват. Часть людей была уверена, что это заговор программистов. На самом деле, правда кроется в данных, которые ИИ использует для своего обучения. Я решила провести эксперимент, чтобы наглядно доказать это. Оказалось, что Роб Спир (Rob Speer) уже все сделал за меня.
Хочу поделиться с вами переводом его материала, который наглядно показывает, что даже самый дефолтный вариант ИИ будет насквозь пропитан расизмом. В первой статье мы проведем эксперимент, во второй попытаемся разобраться, как побороть то чудовище, которое мы породили.
Intro
Есть такой шаг в развитии языка, когда его компилятор написан на нем же.
Чтобы доказать крутость библиотеки trafaret я тоже решил сделать что-то такое же
рекурсивненькое, где надо идти глубже.
Напишем на трафарете парсер Json Schema, который на выходе вернет
готовый трафарет для проверки документов в соответствии с данным описанием.
То есть некий объект типа Trafaret, если ему скормить корректный документ json schema
на выходе вернет объект типа Trafaret, которому можно кормить документы
соответствующие описанию.
Как вообще такое сделать библиотекой валидации? Ну библиотекой валидации никак, а вот универсальным трансформером запросто. Trafaret это парсер данных, точнее комбинаторный парсер. Только те парсеры про которые вы наслышаны такие как parsec и funcparserlib парсят строки, а Trafaret парсит все что под руку подвернется, и на что у автора талантов хватит закодировать.
Json Schema описывается как водится пачкой документов из которых самый близкий народу пожалуй этот — http://json-schema.org/latest/json-schema-validation.html
Тут описание множества ключевых слов с помощью которых вы можете описать критерии корректности документа, а вот замечательный и зубодробительный в реализации $ref всего в одном месте вскользь.
Машинное обучение: от Ирисов до Телекома
2017-08-23 в 14:18, admin, рубрики: big data, data mining, data science, Fisher's iris, machine learning, Peter-Service, python, telecom, Блог компании Петер-Сервис, машинное обучение
Мобильные операторы, предоставляя разнообразные сервисы, накапливают огромное количество статистических данных. Я представляю отдел, реализующий систему управления трафиком абонентов, которая в процессе эксплуатации у оператора генерирует сотни гигабайт статистической информации в сутки. Меня заинтересовал вопрос: как в этих Больших Данных (Big Data) выявить максимум полезной информации? Не зря ведь одна из V в определении Big Data — это дополнительный доход.
Я взялся за эту задачу, не являясь специалистом в исследовании данных. Сразу возникла масса вопросов: какие технические средства использовать для анализа? На каком уровне достаточно знать математику, статистику? Какие методы машинного обучения надо знать и насколько глубоко? А может лучше для начала освоить специализированный язык для исследования данных R или Python?
Как показал мой опыт, для начального уровня исследования данных нужно совсем не много. Но мне для быстрого погружения не хватало простого примера, на котором наглядно был бы показан полный алгоритм исследования данных. В этой статье на примере Ирисов Фишера мы пройдем весь путь начального обучения, а далее применим полученное понимание к реальным данным оператора связи. Читатели, уже знакомые с исследованием данных, могут сразу переходить к главе, посвященной Телекому.
Читать полностью »
Kaggle Mercedes и кросс-валидация
2017-08-23 в 12:28, admin, рубрики: cross-validation, data mining, kaggle, Mercedes, Mercedes-Benz, python, scikit-learn, scipy, Блог компании Open Data Science, математика, машинное обучение
Всем привет, в этом посте я расскажу о том, как мне удалось занять 11 место в конкурсе от компании Мерседес на kaggle, который можно охарактеризовать как лидера по количеству участников и по эпичности shake-up. Здесь можно ознакомиться с моим решением, там же ссылка на github, здесь можно посмотреть презентацию моего решения в Yandex.
В этом посте пойдет речь о том, как студент консерватории попал в data science, стал призером двух подряд kaggle-соревнований, и каким образом методы математической статистики помогают не переобучиться на публичный лидерборд
Начну я с того, что немного расскажу о задаче и о том, почему я взялся ее решать. Должен сказать, что в data science я человек новый. Лет 7 назад я закончил Физический Факультет СПбГУ и с тех пор занимался тем, что получал музыкальное образование. Идея немного размять мозг и вернуться к техническим задачам впервые посетила меня примерно два года назад, на тот момент я уже работал в оркестре Московской Филармонии и учился на 3 курсе в Консерватории. Начал я с того, что вооружившись книгой Страуструпа стал осваивать C++. Далее были конечно же разные онлайн курсы и примерно год назад я стал склоняться к мысли о том, что Data Science — это пожалуй именно то, чем я хотел бы заниматься в IT. Мое “образование” в Data Science — это курс от Яндекса и Вышки на курсере, несколько курсов из специализации МФТИ на курсере и конечно же постоянное саморазвитие в соревнованиях.
Читать полностью »
Тавтологические тесты
2017-08-23 в 7:50, admin, рубрики: python, unit-тесты, Блог компании Badoo, отладка, Совершенный код, тавтология, Тестирование веб-сервисов
Привет! Меня зовут Артём, и большую часть своего рабочего времени я пишу сложные автотесты на Selenium и Cucumber/Calabash. Честно говоря, довольно часто я оказываюсь перед непростым выбором: написать тест, который проверяет конкретную реализацию функциональности (потому что это проще) или тест, который проверяет функциональность (потому что это правильнее, но намного сложнее)? Недавно мне попалась неплохая статья о том, что тесты реализации – это «тавтологические» тесты. И, прочитав её, я уже почти неделю переписываю некоторые тесты в другом ключе. Надеюсь, вас она тоже подтолкнёт к размышлениям.
Нейроаутентификация: введение в биометрическую аутентификацию
2017-08-22 в 18:57, admin, рубрики: deep learning, python, Алгоритмы, аутентификация, защита информации, информационная безопасность, искусственный интеллект, машинное обучение
Привет. Решил написать о применении нейронных сетей в совсем не традиционной для них сфере: аутентификация. Это лежит вне задач машинного обучения, и то от чего в ML пытаются избавиться — тут поощряется.
Минимум теории — максимум практики.
Заинтересовался? Тогда добро пожаловать под кат.
Читать полностью »