
Аналитический центр red_mad_robot разобрал объёмную научную статью «Advances and Challenges in Foundation Agents» от группы исследователей из передовых международных университетов и технологических компаний. Работа предлагает новый взгляд на текущее состояние и развитие «интеллектуальных агентов», которые могут адаптироваться к множеству задач и контекстов. Рассказываем, какие идеи лежат в основе Foundation Agents, с какими проблемами предстоит столкнуться, и что ждёт нас в будущем.
Рубрика «reinforcement learning» - 2
От мозга к мультиагентным системам: как устроены Foundation Agents нового поколения
2025-07-24 в 21:44, admin, рубрики: AI, alignment, deep learning, jailbreak, large language models, machine learning, multi-agent systems, prompt engineering, rag, reinforcement learningLiberalMind 1.5 новая LLM из России
2025-07-23 в 12:15, admin, рубрики: AI, Fine-tuning, llm, llm-модели, lora-адаптеры, ml, reinforcement learning, искусственный интеллект, машинное обучение, языковые модели
ИИ простыми словами, часть 2. Reinforcement Learning (RL)
2025-02-06 в 16:18, admin, рубрики: deepseek, reinforcement learning, ИИ, искусственный интеллектКогда я пишу новости про ИИ, то часто сталкиваюсь с проблемой: они пестрят техническими терминами, которые не всегда понятны даже людям использующим ИИ регулярно. SFT, MoE, RL/RLHF/DPO, миллионы их.
Я захотел описать самые популярные термины простым русским языком, чтобы каждый, даже нетехнический человек, мог разобраться в самой главной технологии современности. Чтобы, когда я пишу на Хабр или куда-то ещё, для сложных терминов я сразу мог бы дать ссылку на понятное и простое объяснение.
ИИ на путях: как решить задачу перепланирования расписания движения поездов
2025-01-23 в 15:30, admin, рубрики: artificial intelligence, machine learning, reinforcement learning, жд, ИИ, искусственный интеллект, машинное обучение, обучение с подкреплениемПривет. Я Артур Саакян, главный специалист по анализу данных и машинному обучению в ПГК Диджитал. Мы разрабатываем уникальные цифровые продукты для железнодорожных перевозок, такие как оптимизация ЖД перевозок, навигатор, ЖД карты, цифровой вагон и так далее.
В этой статье опишу подход к оптимизации расписания поездов в реальном времени при помощи обучения с подкреплением (RL), который применим и к российским грузовым ж/д перевозкам, но пока не используется. Тезисы статьи:
-
Перепланирование расписания движения поездов (Train Timetable Rescheduling)
-
Коротко об RL и Q-learning
-
Моделирование железнодорожной средыЧитать полностью »
Практическое обучение с подкреплением: от забав с MuJoCo’м до битв на арене
2025-01-15 в 16:19, admin, рубрики: jax, machine learning, MuJoCo, reinforcement learning, SAC, The MuJoCo Men, машинное обучение, обучение с подкреплениемДобрый день, уважаемыее!
Я хочу поделиться с вами очень интересным проектом, над которым работал в последнее время.
В первой статье я не буду сильно углубляться в технические подробности, а вместо этого постараюсь провести вас по пути, который я прошел при реализации своего пайплайна для обучения нейросеток, сражающихся друг с другом на арене. Весь код доступен на моем GitHub и готов к использованию, поэтому вы сразу сможете обучить чемпиона и поучаствовать в сражении!
Готовы? Тогда - вперед!
OpenAI o1 — LLM, обученная выполнять сложные логические рассуждения
2024-10-01 в 11:34, admin, рубрики: data engineering, llama, llm, mlops, nlp, reinforcement learning, большие языковые модели, квантизация, машинное обучение, нейронные сетиOpenAI изменили направление развития своих языковых моделей, от просто генерации текста их последняя модель перешла к решению задач с использованием логики и пошагового анализа проблемы.
До сих пор LLM генерировали текст на основе данных, использованных в процессе обучения. Веса модели хранят представление о зависимостях между текстовыми токенами, полученное из исходного корпуса данных. Соответственно, модель просто генерирует наиболее вероятные токены "по памяти", но не выполняет с их помощью никакой по-настоящему интеллектуальной работы.
Обучение с подкреплением на Python: Пример не из «качалки»
2021-10-30 в 12:33, admin, рубрики: python, reinforcement learning, машинное обучение, обучение с подкреплением, Разработка робототехникиПостановка задачи
Обучение с подкреплением молодая и бурно растущая дисциплина. Это обстоятельство привело к тому что информации об этом на русском языке почти нет. Особенно, если дело касается объектно-ориентированного подхода, и практических задач не из арсенала "качалки".
Представляю вам результат простой задачи, которая как я надеюсь, убережет вас от части шишек встречающихся на этом интересном пути.
Предположим задачу, в которой нано робот с антибиотиком должен подобраться к скоплению патогенных бактерий для их уничтожения.
Загрузим Reinforsment Learning от Keras и библиотеку для анимации.
Читать полностью »ИИ, пытающийся избежать проблем, научился сложному поведению
2019-12-21 в 20:38, admin, рубрики: reinforcement learning, ИИ, искусственный интеллект, нейронные сети, обучение с подкреплением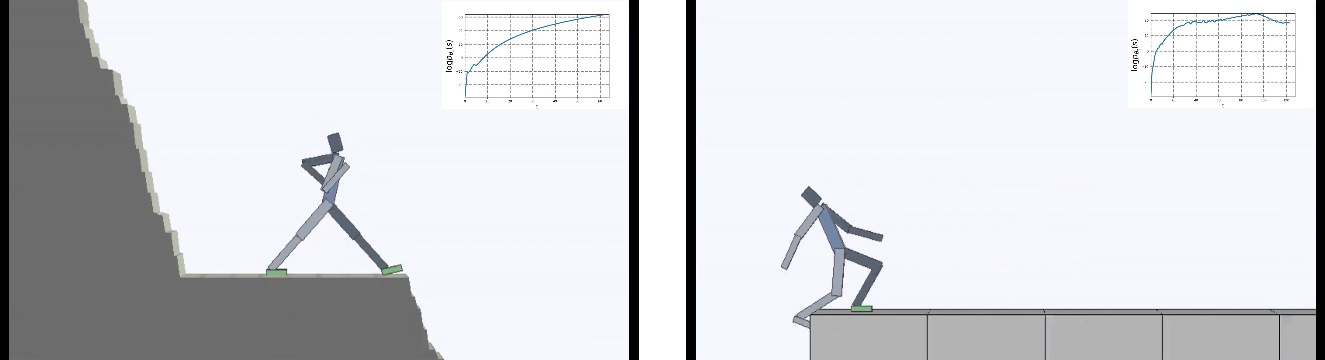
В обучении с подкреплением (Reinforcement Learning) часто используется любопытство в качестве мотивации для ИИ. Заставляющее его искать новые ощущения и исследовать окружающий мир. Но жизнь полна неприятных сюрпризов. Можно упасть с обрыва и с точки зрения любопытства это всегда будут очень новые и интересные ощущения. Но явно не то, к чему надо стремиться.
Разработчики из Berkeley перевернули задачу для виртуального агента с ног на голову: главной мотивирующей силой сделали не любопытство, а наоборот — стремление всеми силами избегать любой новизны. Но "ничего не делать" оказалось сложнее, чем кажется. Будучи помещенным в постоянно меняющийся окружающий мир, ИИ пришлось обучиться сложному поведению, чтобы избегать новых ощущений.
Оптимизация стратегии игры в Блэкджек методом Монте-Карло
2019-11-22 в 13:27, admin, рубрики: AI, blackjack, machine learning, monte carlo, reinforcement learning, Блог компании OTUS. Онлайн-образование, искусственный интеллект, машинное обучениеПеревод статьи подготовлен специально для студентов курса «Machine learning».
Обучение с подкреплением штурмом взяло мир Искусственного Интеллекта. Начиная от AlphaGo и AlphaStar, все большее число видов деятельности, в которых раньше доминировал человек, теперь завоевано агентами ИИ, работающими на основе обучения с подкреплением. Короче говоря, эти достижения зависят от оптимизации действий агента в определенной среде для достижения максимального вознаграждения. В последних нескольких статьях от GradientCrescent мы рассмотрели различные фундаментальные аспекты обучения с подкреплением, от основ систем с бандитами и подходов, основанных на политике, до оптимизации поведения на основе вознаграждения в Марковских средах. Все эти подходы требовали полных знаний о нашей среде. Динамическое программирование, например, требует, чтобы мы обладали полным распределением вероятностей всех возможных переходов состояний. Однако в действительности мы обнаруживаем, что большинство систем невозможно интерпретировать полностью, и что распределения вероятностей не могут быть получены в явном виде из-за сложности, врожденной неопределенности или ограничений вычислительных возможностей. В качестве аналогии рассмотрим задачу метеоролога – число факторов, участвующих в прогнозировании погоды, может быть настолько велико, что точно вычислить вероятность оказывается невозможным.Читать полностью »
Никогда больше не игнорируйте обучение с подкреплением
2019-11-10 в 18:49, admin, рубрики: algorithms, machine learning, reinforcement learning, машинное обучениеПривет! Представляю вашему вниманию перевод статьи «Don’t Ever Ignore Reinforcement Learning Again» автора Michel Kana, Ph.D.
Обучение с учителем и обучение без учителя — это ещё не все. Все это знают. Начните с OpenAI Gym.
Собираетесь победить чемпиона мира по шахматам, нардам или го?
Есть способ, который позволит вам это сделать — обучение с подкреплением.
Читать полностью »