Рубрика «spark» - 6

Пусть Жираф был не прав,
Но виновен не Жираф,
А тот, кто крикнул из ветвей:
«Жираф большой — ему видней!» (с)

Потребовалось оперативно разобраться с технологией Apache Spark заточенную для использования Big Data. В процессе выяснения активно использовал habrahabr, так что попробую вернуть информационный должок, поделившись приобретенным опытом.

А именно: установкой системы с нуля, настройкой и собственно программированием кода решающего задачу обработки данных для создания модели, вычисляющей вероятность банкротства клиента банка по набору таких признаков как сумма кредита, ставка и т.д.

Больших данных вроде как должно быть много, но почему-то не просто найти то злачное место, где их все щупают. Сначала попробовал вариант с ambari, но на моей Window7 валились ошибки настроек сетевого моста. В итоге прокатил вариант с преднастроенной виртуальной машиной от Cloudera (CDH). Просто устанавливаем VirtualBox, запускаем скачанный файл, указываем основные параметры (память, место) и через 5 минут достопочтенный джин Apache Hadoop жаждет ваших указаний.

Несколько слов, почему именно Spark. Насколько я понимаю, ключевые отличия от изначальной MapReduce в том, что данные удерживаются в памяти, вместо сброса на диск, что дает ускорение во много раз. Но, пожалуй, более важны реализации целого ряда статистических функций и удобным интерфейсом для загрузки/обработки данных.

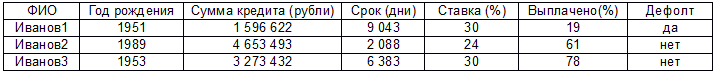
Дальше собственно код для решения следующей задачи. Есть реально большие данные (ибо рука очень устает скролить эти 2000 строк) в формате:
Маленький код для больших данных или Apache Spark за 3 дня - 1

Есть предположение, что дефолт как-то связан с остальными параметрами (кроме первого, к уважаемым Ивановым1…N претензий нет) и нужно построить модель линейной регрессии. Прежде чем начать, стоит оговориться, что это мой первый код на Java, сам я работаю аналитиком и вообще это мой первый запуск Eclipse, настройка Maven и т.д. Так что не стоит ждать изысканных чудес, ниже решение задачи в лоб тем способом, который почему-то заработал. Поехали:
Читать полностью »
Одной из самых важных новостей компании Oracle в 2015 году стал выход нового процессора SPARC M7 и линейки серверов на его основе. В эту линейку вошли серверы T-серии (T7-1, T7-2, T7-4) и серверы M-серии (M7-8, M7-16).

Помимо уникальных физических характеристик (частота 4,13 гГц, 32 ядра, до 256 потоков) на процессоре M7 заявлена возможность переноса части SQL-логики базы данных Oracle на специальные сопроцессоры DAX (Data Analytics Accelerator). Эта технология получила название «SQL in Silicon» – с ней новый процессор M7 позиционируется как первый процессор в истории ИТ, в том числе оптимизированный под задачи Oracle Database.

В начале 2016 года стало возможно тестирование серверов T-серии, и мы одними из первых в России параллельно протестировали сразу два тестовых сервера T7-2 (по два процессора M7 в каждом).
Читать полностью »

Исторически во многих уголках Яндекса разрабатывались свои системы хранения и обработки больших объемов данных — с учетом специфики конкретных проектов. При такой разработке в приоритете всегда была эффективность, масштабируемость и надежность, поэтому на удобные интерфейсы для использования подобных систем времени, как правило, не оставалось. Полтора года назад разработку крупных инфраструктурных компонентов выделили из продуктовых команд в отдельное направление. Цели были следующими: начать двигаться быстрее, уменьшить дублирование среди схожих систем и снизить порог входа новых внутренних пользователей.

Как писать меньше кода для MR, или Зачем миру ещё один язык запросов? История Yandex Query Language - 1

Очень скоро мы поняли, что тут мог бы здорово помочь общий высокоуровневый язык запросов, который бы предоставлял единообразный доступ к уже имеющимся системам, а также избавлял от необходимости заново реализовывать типовые абстракции на низкоуровневых примитивах, принятых в этих системах. Так началась разработка Yandex Query Language (YQL) — универсального декларативного языка запросов к системам хранения и обработки данных. (Сразу скажу, что мы знаем, что это уже не первая штука в мире, которая называется YQL, но мы решили, что это делу не мешает, и оставили название.)

В преддверии нашей встречи, которая будет посвящена инфраструктуре Яндекса, мы решили рассказать о YQL читателям Хабрахабра.

Читать полностью »

Видеозапись вебинара «Инструменты для работы Data Scientist» - 1

Вчера наша команда провела вебинар на тему «Инструменты для работы Data Scientist». В его рамках мы рассмотрели, кто такой data scientist и какими инструментами он пользуется. Поговорили о платформе FlyElephant и чем она может быть полезной для работы data scientist’а.
Читать полностью »

Big Data – это проблема. Количество информации растет с каждым днем, и она накапливается как снежный ком. Прекрасно то, что проблема эта имеет решения, только в мире JVM больший данных процессят десятки тысяч проектов.

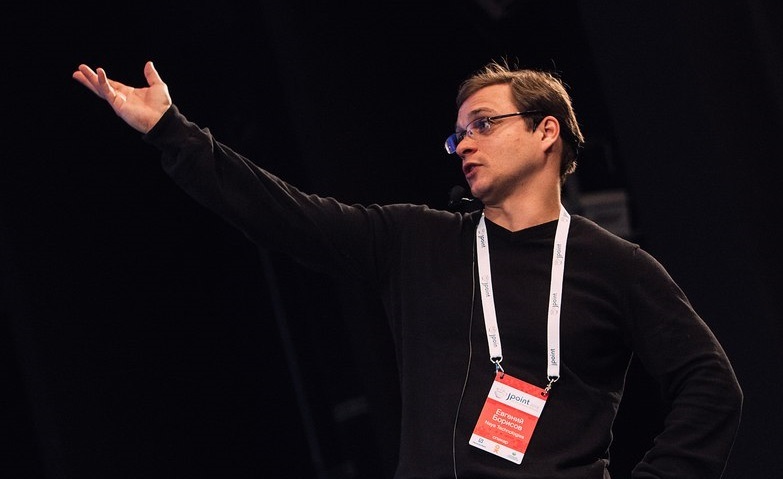
В 2012 году увидел свет фреймворк Apache Spark, разработанный на Scala и рассчитанный на повышение производительности определенных классов задач в работе с Big Data. Проекту уже 4 года он повзрослел и дорос до версии 2.0, к которой (на самом деле уже начиная с версии 1.3-1.5) имеет мощный и удобный API для работы с Java. Чтобы понять, для кого это все надо, какие именно задачи стоит решать при помощи Spark, а какие не стоит, мы поговорили с Евгением EvgenyBorisov Борисовым, автором тренинга «Welcome to Spark», который пройдет 12-13 октября в Петербурге.

Welcome to Spark… on Java: Интервью с Евгением Борисовым - 1
Читать полностью »

Apache Spark – универсальный инструмент для процессинга больших данных, с которым можно писать в Hadoop с различных СУБД, стримить всякие источники в реальном времени, параллельно делать с данными какую-нибудь сложную обработку, и все это не при помощи каких-то батчей, скриптов и SQL-запросов, а при помощи функционального подхода.

Твоя Data такая большая: Введение в Spark на Java - 1

Про Spark ходит несколько мифов:

  • Spark’y нужен Hadoop: не нужен!
  • Spark’у нужна Scala: не обязательно!

Почему? Смотрите под катом.
Читать полностью »

imageSpark – проект Apache, предназначенный для кластерных вычислений, представляет собой быструю и универсальную среду для обработки данных, в том числе и для машинного обучения. Spark также имеет API и для R(пакет SparkR), который входит в сам дистрибутив Spark. Но, помимо работы с данным API, имеется еще два альтернативных способа работы со Spark в R. Итого, мы имеем три различных способа взаимодействия с кластером Spark. В данном посте приводиться обзор основных возможностей каждого из способов, а также, используя один из вариантов, построим простейшую модель машинного обучения на небольшом объеме текстовых файлов (3,5 ГБ, 14 млн. строк) на кластере Spark развернутого в Azure HDInsight.
Читать полностью »

Представьте, что мы хотим написать на обычном SQL запрос не в базу данных, а к логам. В работе может возникнуть задача анализа логов, для которой потребуется делать запросы на SQL к неструктурированному набору данных, который даже не находится в СУБД. В этой заметке я расскажу о примере использования Spark SQL для выявления правил (логики) выбора необходимых документов из большого хранилища.

Читать полностью »

Основная цель статьи — поделиться практическим опытом создания и анализа индексов с помощью Spark SQL. Разумеется, это настолько обширная тема, что данная статья только поверхностно коснётся основных подходов в контексте упомянутой задачи. Создание индексов часто требуется после сложного анализа огромного числа документов. Допустим, аналитическая система записывает в лог уникальный идентификатор документа и ряд его метрик. Необходимо проанализировать этот отчёт, чтобы выбрать только необходимые идентификаторы документов.

Читать полностью »

Spark Summit 2016: обзор и впечатления - 1

В июне прошло одно из самых крупных мероприятий мира в сфере big data и data science — Spark Summit 2016 в Сан-Франциско. Конференция собрала две с половиной тысячи человек, включая представителей крупнейших компаний (IBM, Intel, Apple, Netflix, Amazon, Baidu, Yahoo, Cloudera и так далее). Многие из них используют Apache Spark, включая контрибьюторов в open source и вендоров собственных разработок в big data/data science на базе Apache Spark.

Мы в Wrike активно используем Spark для задач аналитики, поэтому не могли упустить возможности из первых рук узнать, что происходит нового на этом рынке. С удовольствием делимся своими наблюдениями.

Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js