После двух лет активной разработки и бурного роста пользовательской базы (свыше 125 тыс. клиентов) команда облачного сервиса Kimono радостно сообщает о своём присоединении к Palantir — частной американской компании-разработчику программного обеспечения анализа данных для организаций. Событие это радостное, но не во всём.Читать полностью »
Рубрика «big data» - 105
Сервис «Kimono» закрывается
2016-02-16 в 13:53, admin, рубрики: api, big data, data mining, javascript, Kimono, Kimonolabs, Веб-разработка, метки: Kimono, KimonolabsГлубокое обучение в гараже — Братство данных
2016-02-15 в 10:54, admin, рубрики: big data, data analysis, data mining, data science, deep learning, gpgpu, python, Программирование 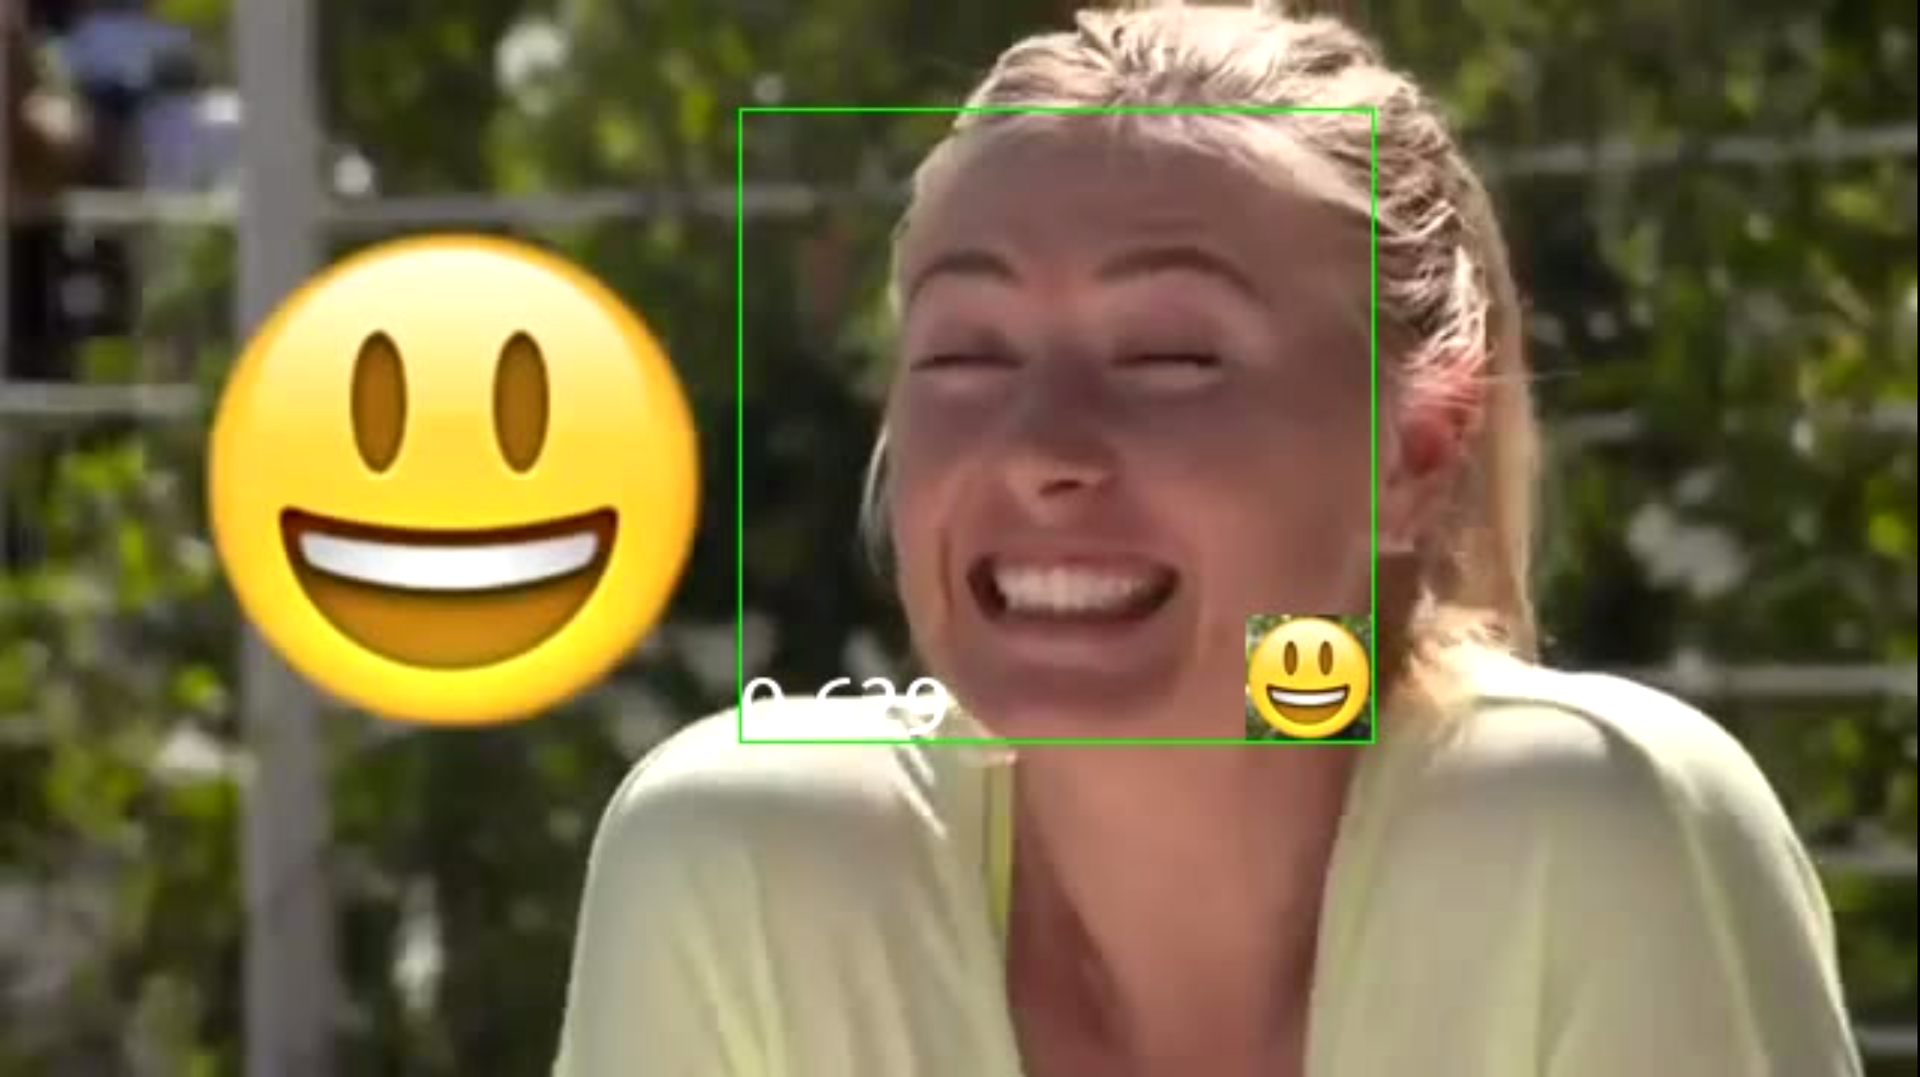
Вы тоже находите смайлы презабавнейшим феноменом?
В доисторические времена, когда я еще был школьником и только начинал постигать прелести интернета, с первых же добавленных в ICQ контактов смайлы ежедневно меня веселили: ну действительно, представьте, что ваш собеседник корчит рожу, которую шлет вам смайлом!
С тех пор утекло много воды, а я так и не повзрослел: все продолжаю иногда улыбаться присланным мне смайлам, представляя отправителя с глазами разного размера или дурацкой улыбкой на все лицо. Но не все так плохо, ведь с другой стороны я стал разработчиком и специалистом в анализе данных и машинном обучении! И вот, в прошлом году, мое внимание привлекла относительно новая, но интересная и будоражащая воображение технология глубокого обучения. Сотни умнейших ученых и крутейших инженеров планеты годами работали над его проблемами, и вот, наконец, обучать глубокие нейронные сети стало не сложнее "классических" методов, вроде обычных регрессий и деревянных ансамблей. И тут я вспомнил про смайлы!
Представьте, что чтобы отправить смайл, вы и вправду могли бы скорчить рожу, как бы было круто? Это отличное упражнение по глубокому обучению, решил я, и взялся за работу.
Читать полностью »
Почему так много «липовых» специалистов по анализу данных?
2016-02-14 в 20:32, admin, рубрики: big data, data scientist, Карьера в IT-индустрии[Перевод. Источник: www.linkedin.com/pulse/why-so-many-fake-data-scientist-bernard-marr Why So Many ‘Fake’ Data Scientists?]
Вы заметили, что подобно поганками после дождя, появилась огромная масса людей, называющих себя «специалистами по анализу данных»? И смазливая тёлка, живущая по соседству и с которой вы бухали на вечеринке и даже ваш знакомый бухгалтер — все вдруг сменили название профессии в визитке!
Применение машинного обучения в сфере финтеха
2016-02-10 в 9:05, admin, рубрики: big data, Алгоритмы, Блог компании PayOnline, Большие данные, машинное обучение, платежные системы, Программирование, финтех, финтех стартапы  Будучи активным игроком рынка, наша компания PayOnline, специализацией которой является организация платежей на сайтах и в мобильных приложениях, не может не отметить, что в наши дни сфера финансовых услуг претерпевает коренные изменения. Этому способствует развернувшаяся в последние десятилетия гонка вооружений в таких областях, как аналитика больших данных, нейронные сети, эволюционные алгоритмы, экспертные системы и машинное обучение. Данные технологии позволили обрабатывать значительно большие объемы разнообразных данных не только быстрее, но и эффективнее.
Читать полностью »
Быстрый старт в изучении анализа данных и машинного обучения от МФТИ и Яндекса
2016-02-09 в 10:40, admin, рубрики: big data, coursera, machine learning, Блог компании Московский физико-технический институт (МФТИ), МФТИ, Учебный процесс в IT, яндексПочему анализ данных
Потребность в анализе данных вышла далеко за пределы технологических и интернет-компаний. Методы машинного обучения все активнее используются в совершенно различных областях, вплоть до оптимизации маршрутов транспорта. С их помощью создаются новые лекарства и автомобили без водителя, подбирается музыка под настроение, находятся потенциальные спутники жизни.
Специалист по анализу данных или data scientist – одна из самых востребованных профессий сегодняшнего дня. За реальных практиков, умеющих получать значимые результаты в сжатые сроки, идет настоящая борьба, и стоимость таких специалистов взлетает до небес.
Также интерес подогревают государственные и коммерческие структуры, которые не только говорят об этих специальностях, но и уже готовятся к проведению первых олимпиад по ним.
Что же скрывается за этими словами, все ли понимают их значение? К сожалению, нередко к ним относятся как к некому волшебному ингредиенту, который решит все проблемы. Не осознаются ни границы его применения, ни порядок действий, чтобы использовать их «здесь и сейчас».
Пришла пора внести ясность в этот вопрос.

Школа Данных «Билайн», для менеджеров
2016-02-08 в 8:02, admin, рубрики: big data, data mining, kaggle, R, sna, Алгоритмы, алгоритмы обработки данных, анализ данных, анализ социальных сетей, Блог компании ВымпелКом (Билайн), машинное обучение, рекомендательные системы, школа данных 
Привет!
Итак, мы запустили третий курс Школы Данных «Билайн». Подробный отчет о занятиях от одного из участников можно почитать здесь.
Отчеты о работе Школы мы также будем выкладывать на официальной странице Школы в Facebook. Там же будем отвечать на вопросы, которые также можно направлять на dataschool@beeline.digital.
Набираем 4-ый курс, который стартует с 4 апреля. Запись, как всегда, на странице Школы.
Однако, данный пост не только об этом. До сих пор в Школе Данных мы учили аналитиков, учили тому, как применять методы машинного обучения для решения практических задач. Однако, практически любая практическая задача начинается с бизнес-потребности и бизнес- постановки.
Мы сейчас не будем говорить о том, что на заре больших данных считалось, что основные инсайты и применения аналитики идут скорее от данных. Это безусловно есть, но в нашей практике это происходит в соотношении 80 к 20, где 80 процентов всех задач для аналитика или даже больше рождается от бизнеса.
Однако, как же бизнес генерит эти задачи, если он, бизнес, не разбирается в аналитике данных? Да, очень просто. В нашей компании мы потратили какое-то время на объяснение бизнесу возможностей аналитики данных и теперь разные подразделения заваливают нас заказами придумывая все новые применения этим инструментам.
Читать полностью »
Еще одна пощечина Big Data? Фаза разочарования
2016-02-07 в 10:44, admin, рубрики: big data, Блог компании PalitrumLab, Исследования и прогнозы в ITВ предыдущих статьях мы уже показывали на реальных событиях, что термин Big Data, «засаленный и потертый», переходит в фазу «разочарования»:
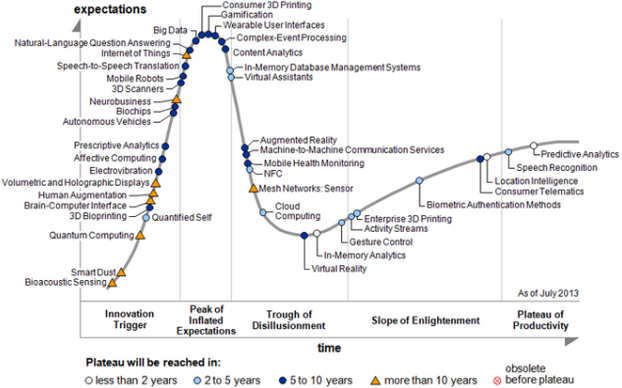
В качестве еще одного гвоздика в крышку приводим перевод одной из ряда статей очередного разочарования. Так ли все плохо и в чем Big Error такого подхода к Big Data — после статьи. Материал в любом случае полезен для ознакомления, поскольку содержит несколько важных ссылок на индустриальные исследования и наборы данных.
Читать полностью »
AI, BigData & HPC Digest #4
2016-02-06 в 13:24, admin, рубрики: AI, big data, BigData, data mining, FlyElephant, high performance computing, HPC, R, анализ данных, Блог компании FlyElephant, Большие данные, видео, высокая производительность, дайджест, искусственный интеллект, Мероприятия, Новости, подкасты, статьи 
Команда FlyElephant подготовила для Вас новый дайджест, включающий в себя подборку ссылок на интересные материалы по направлениям: искусственный интеллект, большие данные и высокопроизводительные вычисления.
Читать полностью »
Знакомство с Apache Spark
2016-02-05 в 13:49, admin, рубрики: Apache, big data, machine learning, scalability, spark, Блог компании Издательский дом «Питер», книги, ПрограммированиеЗдравствуйте, уважаемые читатели!
Мы наконец-то приступаем к переводу серьезной книги о фреймворке Spark:
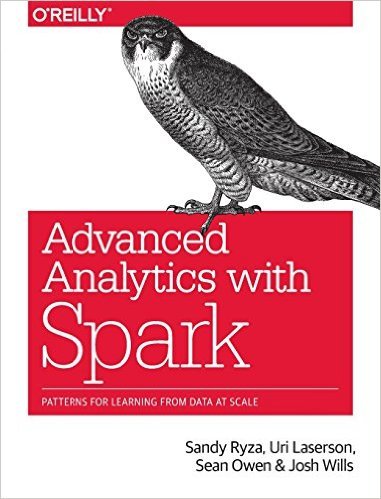
Сегодня мы предлагаем вашему вниманию перевод обзорной статьи о возможностях Spark, которую, полагаем, можно с полным правом назвать слегка потрясающей.
Рекомендации на потоке
2016-02-05 в 12:43, admin, рубрики: Aerospike, apache kafka, apache spark streaming, big data, python, recommender system, stream processing, Алгоритмы, Блог компании E-ContentaВсем привет!
Сегодня мы расскажем о том, как с помощью потоковой обработки данных можно увеличить качество рекомендаций и снизить время отклика всей рекомендательной системы в 5 раз. Речь пойдет об одном из наших клиентов – сервисе потокового видео Rutube.