
Generative adversarial networks (GAN) пользуются все большей популярностью. Многие говорят о них, кто-то даже уже использует… но, как выясняется, пока мало кто (даже из тех кто пользуется) понимает и может объяснить. ;-)
Давайте разберем на самом простом примере, как же они работают, чему учатся и что на самом деле порождают.Читать полностью »
Рубрика «big data» - 104
Разбираемся с войной нейронных сетей (GAN)
2016-03-03 в 3:42, admin, рубрики: big data, GAN, lasagne, python, theano, машинное обучение, нейронные сетиХабр умирает?
2016-03-01 в 22:31, admin, рубрики: big data, data mining, тот парень из трассы-60, хабр, хабрахабрЯ люблю писать тексты по мотивам проектов, которыми занимаюсь. За последний год я разместил на Хабре больше 20 постов. Меня постоянно удивляло, как мало толковых комментариев удаётся здесь получить. Просмотров много, а комментариев мало и большинство не по делу. Недавно я начал замечать, натыкаясь на старинные посты за 2012, 2013 годы, что в них обсуждение, как будто, более содержательное. Решил проверить это количественно. Скачал инфу по всем постам за все годы и построил несколько простых графиков. То что я увидел меня удивило и даже немного испугало. Решил разместить наблюдения здесь, чтобы проверить правильные ли я делаю выводы и всё ли учёл.
Для всех опубликованных на Хабре постов я собрал даты публикаций, число просмотров, число лайков и дислайков, число звёздочек и комментариев, список хабов и названия блогов компаний. В ходе прокачки узнал, что число плюсиков и минусиков может быть дробным и даже отрицательным, пост может быть опубликовал в блоги нескольких компаний и может не иметь автора. Если что, таблицу можно скачать из репозитория github.com/alexanderkuk/analyze-habr/blob/master/data/posts.csv
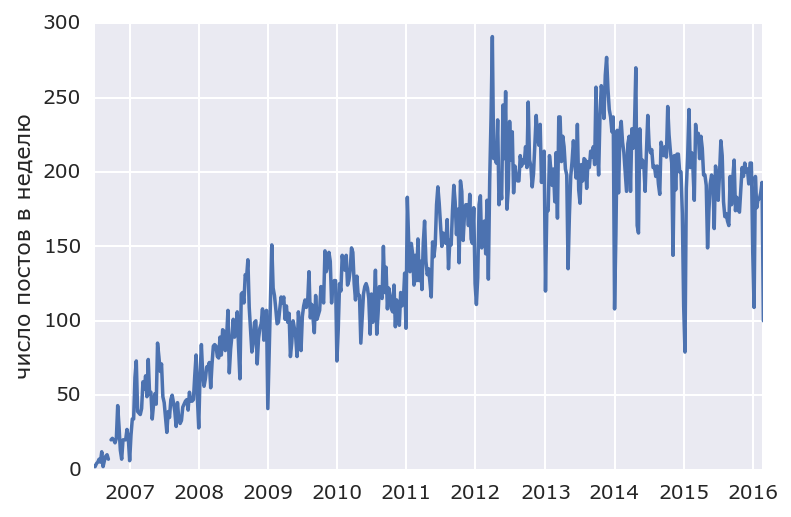
Первым делом я посмотрел как менялось общее число постов со временем. Оно перестало расти в 2013 и немного падает с 2014, что уже немного тревожно:
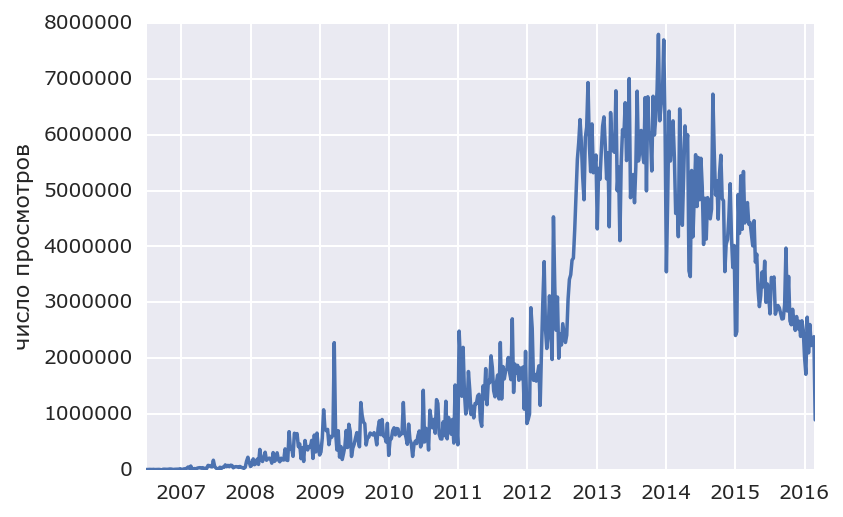
Потом я построил такой же график для суммарного числа просмотров и испугался. С 2014 оно упало в 3.5 раза:
Это серьёзное утверждение, поэтому я решил свериться с Similarweb.
Читать полностью »
Где и у кого учиться робототехнике, управлению большими данными, качественной разработке ПО
2016-02-29 в 8:13, admin, рубрики: big data, бесплатно, Блог компании Innopolis University, Веб-разработка, гранты, Иннополис, лекции, Облачные вычисления, образование, Разработка робототехники, роботы Мы собрали в одном месте все созданные совместно с ПостНаукой краткие обучающие видеоматериалы от профессоров Университета Иннополис.
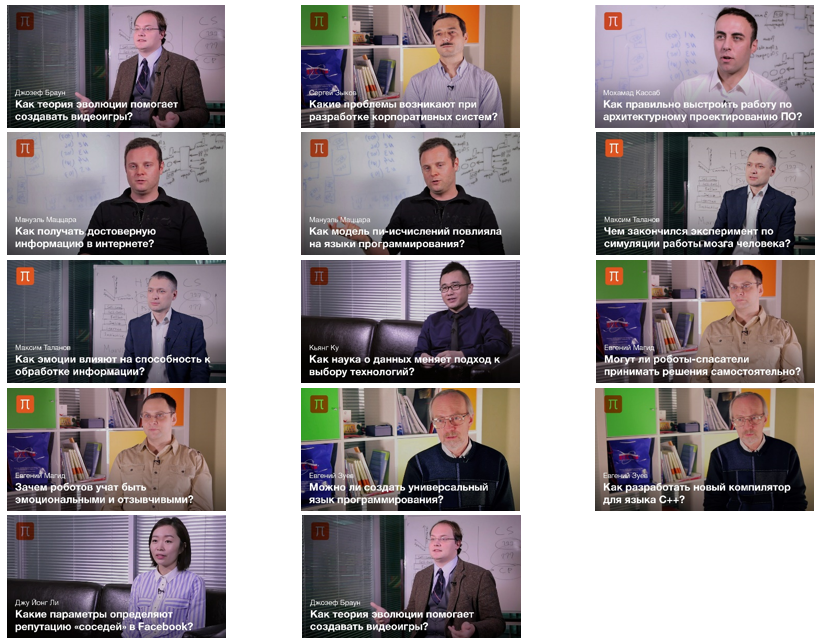
Если темы вам интересны, добро пожаловать под кат.
Читать полностью »
Онлайн-конференция на Ярмарке вакансий для ИТшников
2016-02-25 в 5:54, admin, рубрики: big data, Блог компании HeadHunter, вакансии, Веб-разработка, вебинары, конференция, медведи, Программирование, работа, управление разработкой 
Сегодня, 25-го февраля, HeadHunter устраивает «Ярмарку вакансий онлайн» специально для IT-специалистов. Программа получилась обширная: кроме вакансий с онлайн-собеседованиями, мы подготовили для вебинары, которые покрывают разные сферы из ИТшной и софтверной области. Сегодня нон-стоп один за другим пройдут 9 вебинаров. Специально для “Хабра” я попросил авторов вебинаров рассказать о своих темах, подробности под катом.
Читать полностью »
Как устроен Relap.io — сервис, который выдает 30 миллиардов рекомендаций в месяц
2016-02-19 в 11:56, admin, рубрики: big data, elasticsearch, Hadoop, nginx, perl, postgresql, Блог компании Surfingbird, Веб-разработка, высокая производительность, машинное обучение, Медиа, рекомендательные системы, СМИ, сми в интернетеМы давно ничего не писали в наш блог и возвращаемся с рассказом о нашем новом проекте: Relap.io (relevant pages).
Мы запустили рекомендательный B2B-сервис Relap.io полтора года назад. Он облегчает жизнь редакции и читателям СМИ. В будние дни Relap.io обслуживает 15 млн уников и выдаёт 30 миллиардов рекомендаций в месяц.
Сейчас Relap.io крупнейшая рекомендательная платформа в Европе и Азии.
О пользе технологий больших данных в повседневной жизни
2016-02-19 в 7:04, admin, рубрики: big data, data mining, social network analysis, spark, Блог компании Одноклассники, высокая производительность, Хакатоны 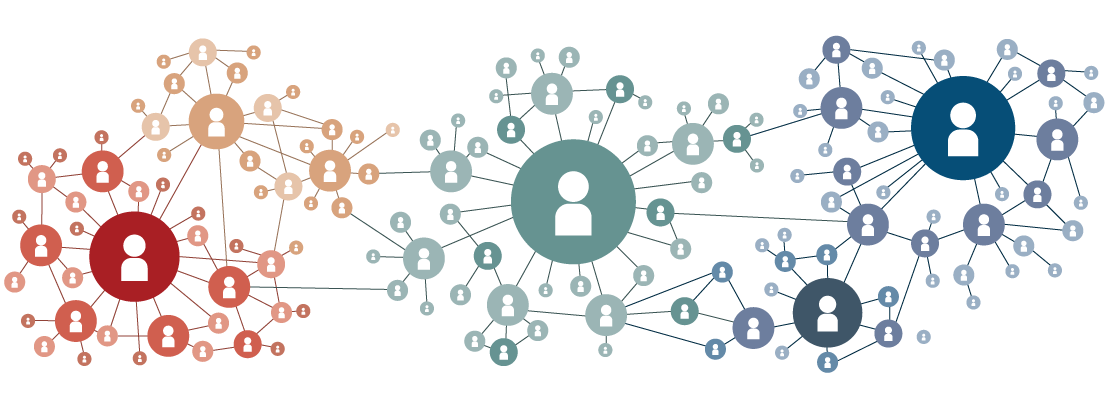
Среди многих исследователей и разработчиков бытует мнение, что инструменты обработки больших данных в области машинного обучения часто избыточны – всегда можно сделать сэмпл, загнать в память и использовать любимые R, Python и Matlab. Но на практике встречаются задачи, когда даже относительно небольшой объем данных, размером в пару гигабайт, обработать в таком стиле затруднительно – и тут-то и могут помочь те самые технологии «больших данных».
Хорошим наглядным примером такой задачи является задача нашего конкурса SNA Hakathon 2016: дан социальный граф одного миллиона пользователей и их демография. Задача — найти скрытые связи в этом графе. Размер предоставленного графа всего два гигабайта в GZip и, казалось бы, применение технологий больших данных здесь не оправданно, но это только на первый взгляд.
Одной из самых важных «фич» в задаче поиска скрытых связей в социальном графе является количество общих друзей. И в расчетном плане это очень тяжелая «фича» — количество узлов, между которыми существуют пути длины 2, на несколько порядков больше, чем количество прямых связей в графе. В результате при расчете граф «взрывается» и из разрежённой матрицы на два гигабайта превращается в плотную терабайтную матрицу.
Казалось бы, для решение этой задачи впору поднимать небольшой кластер, но спешить не стоит: взяв на вооружение принципы обработки больших данных и соответствующие технологии, задачу можно решить и на обычном ноутбуке. Из принципов мы возьмем «разделяй и властвуй» и «руби хвосты сразу», а в качестве инструмента — Apache Spark.
Читать полностью »
Делицын: Как мы [в ФИНАМ] прогнозировали выручку «Яндекса», и почему это было бессмысленно?
2016-02-18 в 20:03, admin, рубрики: big data, аналитика, биржи, инвестиции, Интернет-реклама, итоги года, контекстная реклама, кризис, курс рубля, Леонид Делицын, Текучка, Финам, эффективность бизнеса, яндекс, метки: big data, аналитика, биржи, инвестиции, интернет-реклама, итоги года, контекстная реклама, кризис, Курс рубля, Леонид Делицын, Текучка, Финам, эффективность бизнеса, яндексАналитик инвестиционной компании «ФИНАМ» Леонид Делицын в Facebook подвёл итоги 2015 года для Яндекса и рассказал о том, что поможет Аркадию Воложу во второй раз «сделать свой первый миллиард долларов». С разрешения Леонида, ниже публикуем его текст полностью.
* * *
Как мы прогнозировали выручку Яндекса, и почему это было бессмысленно
Сопоставим Читать полностью »
«Яндекс» собрал по онлайну «черных кредиторов» для растерзания их Центробанком
2016-02-18 в 16:04, admin, рубрики: big data, Yandex Data Factory, банки, блоги, Госвеб, Доверие к соцсетям, поиск, соцсети, Текучка, Центробанк, яндекс, метки: big data, Yandex Data Factory, банки, блоги, Госвеб, Доверие к соцсетям, поиск, соцсети, Текучка, Центробанк, яндексYandex Data Factory, подразделение «Яндекса», занимающееся аналитикой «больших данных», создало для Центробанка решение по поиску в сети сайтов «черных кредиторов», сообщил «Интерфакс» со ссылкой на начальника главного управления по микрофинансированию ЦБ Михаила Мамуты.
В области потребительских займов высока активность нелегальных кредиторов, Читать полностью »
Специализация по машинному обучению на Coursera от Физтеха и Яндекса
2016-02-17 в 15:10, admin, рубрики: big data, coursera, ml, Алгоритмы, Блог компании Яндекс, курс от Физтеха, курс от Яндекса, машинное обучение, Программирование, физтех, ШАДВ начале года на Coursera открылся курс по машинному обучению от Яндекса и Вышки, о котором мы уже рассказывали. К моменту старта на него записались 14000 человек. Через час после открытия пользователи создали канал в Slack, где стали обсуждать программу. Сейчас слушателей уже 21000.

9 февраля на платформе стала доступна запись на специализацию по машинному обучению, которая разрабатывается нашими специалистами уже совместно с Физтехом. Она устроена таким образом, чтобы помочь слушателям плавно погрузиться в тему.
Специализация «Машинное обучение и анализ данных» состоит из пяти курсов и работой над собственным проектом. Обучение будет длиться несколько месяцев. Записаться на него можно до 19 февраля. Если вы не успеете это сделать, с 14 марта можно будет записаться на второй поток.
Авторы курса — сотрудники Яндекса, специалисты Yandex Data Factory, которые преподают в Физтехе. Константин Воронцов тоже среди них. Мы попросили некоторых из коллег рассказать, кому может быть полезна специализация и для чего она нужна. Также под катом — программа всех курсов.
Читать полностью »
Глубокое обучение в гараже — Возвращение смайлов
2016-02-17 в 14:23, admin, рубрики: big data, data analysis, data mining, data science, deep learning, python, обработка изображений, Программирование 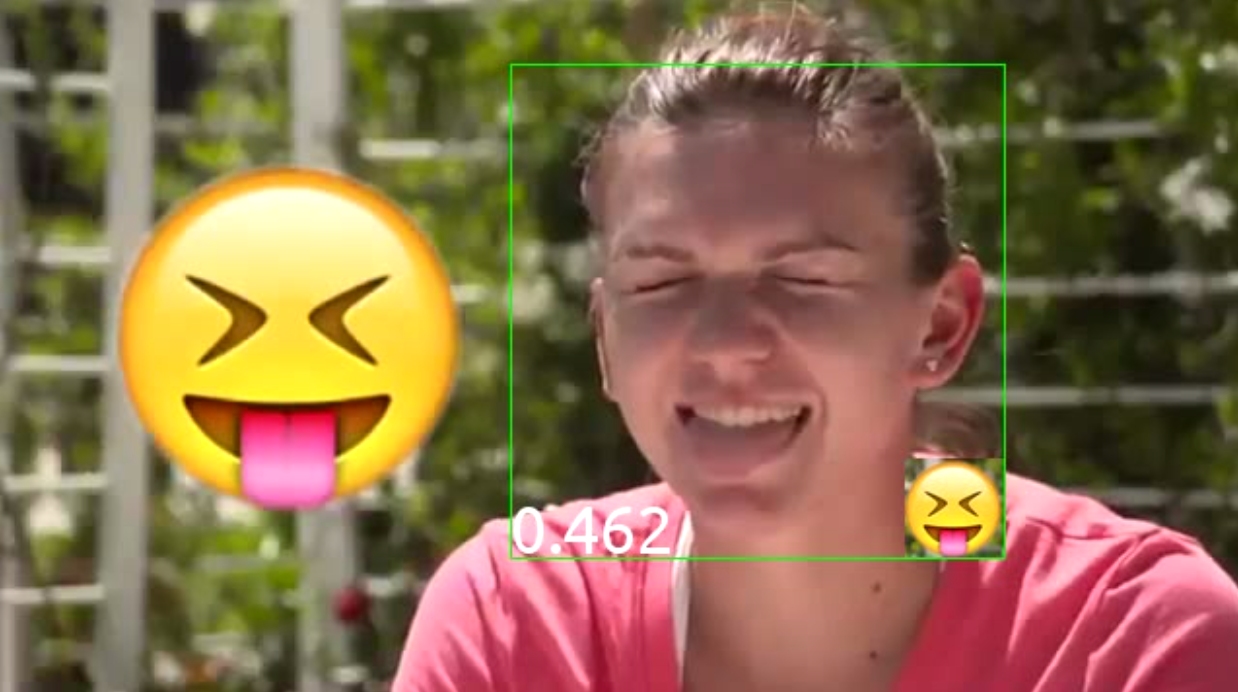
Это третья статья из серии про определение смайла по выражению лица.
Глубокое обучение в гараже — Братство данных
Глубокое обучение в гараже — Две сети
Глубокое обучение в гараже — Возвращение смайлов
Так что же со смайлами?
Фух, ну наконец, детекция лиц работает, можно учить сеть распознавания смайла. Только вот на чем учить? Открытых наборов данных нет. А из того, как долго в предыдущей части я добирался до, собственно, обучения моделей вы уже должны были понять, что в глубоком обучении данные решают все. И их нужно много.
Читать полностью »