Рубрика «big data» - 103

Под большими данными обычно понимают серию подходов, инструментов и методов обработки структурированных и неструктурированных данных, которые отличают огромные объёмы и значительное многообразие. Цель такой обработки — получение воспринимаемых человеком результатов.

BDRA – современная архитектура для аналитики больших данных - 1


Поток данных может поступать из разных источников, эти данные гетерогенны и передаются в различных форматах: текст, документы, изображения, видео и многое другое. Для извлечения из таких данных полезной информации определяющее значение имеет программно-аппаратная платформа.
Читать полностью »

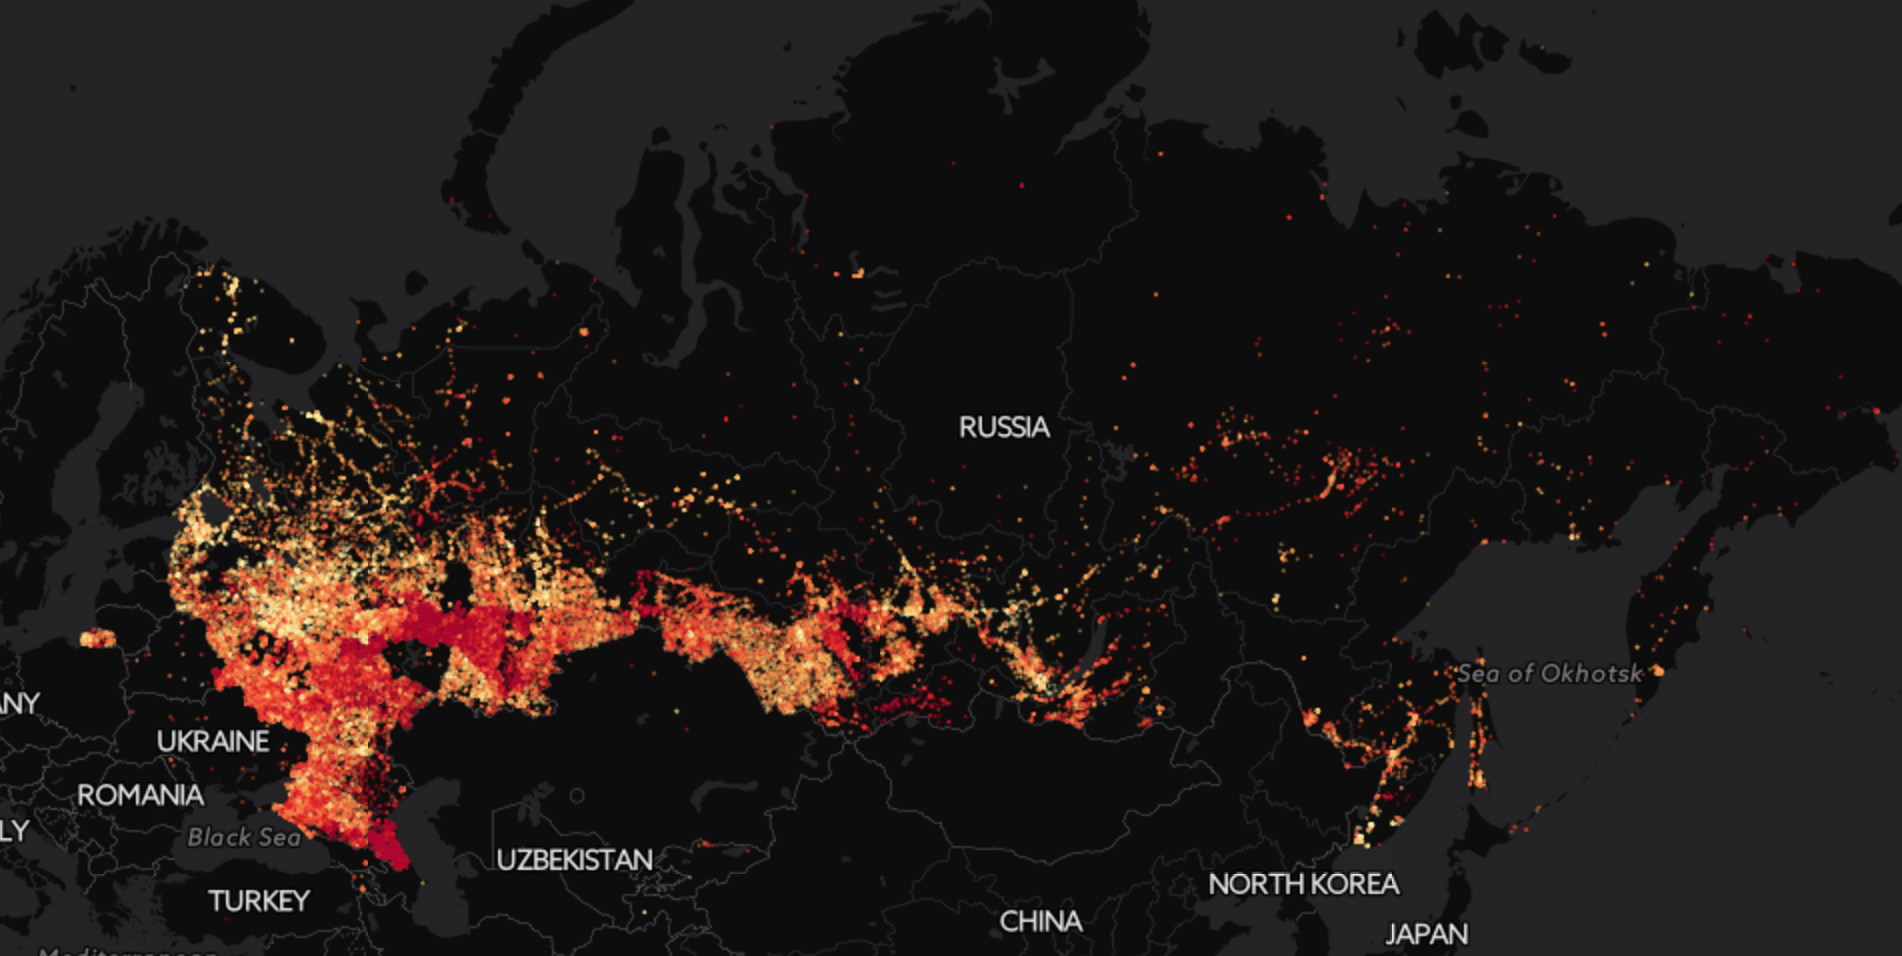
Выборы в Государственную думу только осенью, но мы уже начинаем готовиться. Если повторится история 2011 года, будет очень интересно. Наверное, многие помнят, как сразу после тех выборов появилась куча статистических исследований, намекающих на фальсификации и как все узнали, как выглядит распределение Гаусса. Я хотел бы рассказать, где искать данные про выборы и как с ними работать. Кроме хорошо известных графиков я покажу некоторые другие прикольные картинки, которых раньше в паблике не видел. Так, например, выглядит распределение голосов за Единую Россию по стране, хорошо видны регионы с максимальной поддержкой партии власти — Северный Кавказ и Татарстан:
Анализ результатов выборов в Госдуму. Готовимся к голосованию 2016 года - 1

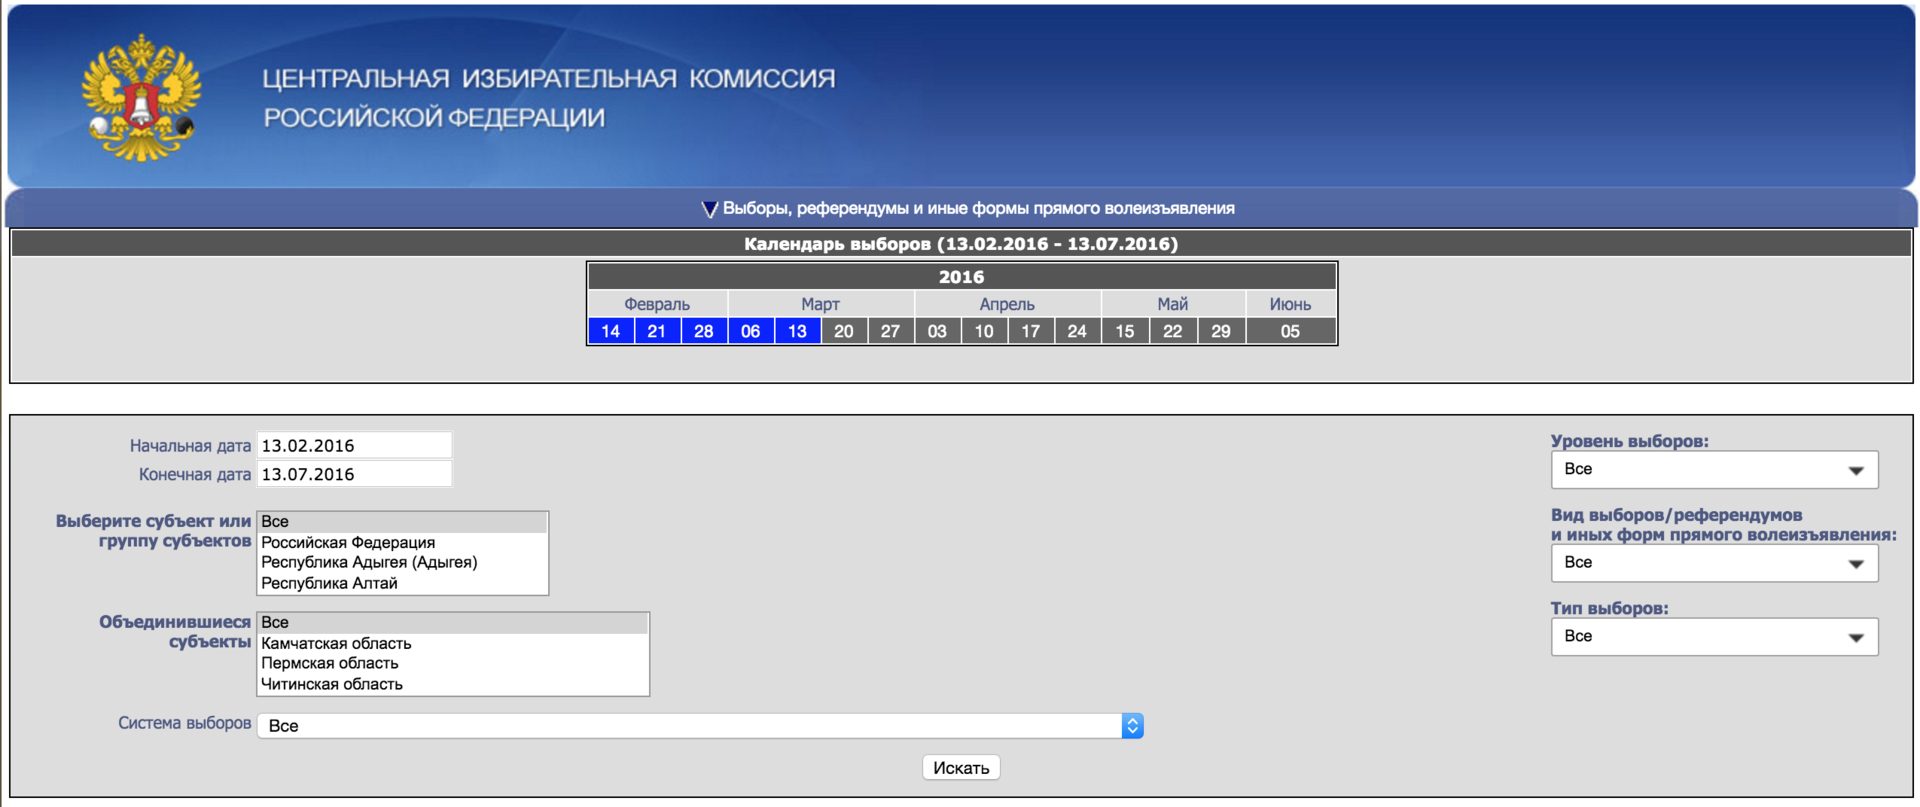
Есть такой замечательный сайт izbirkom.ru. Его здесь даже недавно упоминали в контексте, что, типа, на него потратили слишком много денег. Но лично мне не жалко, сайт прекрасный:
Анализ результатов выборов в Госдуму. Готовимся к голосованию 2016 года - 2
Читать полностью »

Не встречали еще разработчика, который вместо стандартной в скриптовом языке функции деления строки по регулярке — пишет C-подобный код с конечным автоматом, который вводит неокрепшие умы в трепет?

И так ужасно ли то, что ты не знаешь в тонкостях работу красно-черных деревьев или путаешь линейный дискриминантный анализ с вторым законом Ньютона? :-)
Читать полностью »

Эксперимент: Использование Google Trends для прогнозирования обвалов фондового рынка - 1

В нашем блоге на Хабре мы уже рассказывали о различных исследованиях, направленных на создание алгоритмов прогнозирования цен акций, к примеру, с помощью машинного обучения. Еще в 2013 году исследователи из бизнес-школы Уорика (Warwick Business School) опубликовали результаты эксперимента, в ходе которого в качестве инструмента для прогнозирования трендов фондового рынка использовался поисковик Google.

В эпоху интернета огромное количество генерируемой людьми информации доступно онлайн. И из этого шума вполне можно вычленить и нечто полезное. Исследователи убеждены, что в анализе тенденций фондового рынка можно использовать информацию о поисковых запросах.Читать полностью »

Машинное обучение шагает по планете. Искусственный интеллект, поскрипывая нейронными сетями, постепенно опережает людей в тех задачах, до которых успел дотянуться своими нейронами. Однако не стоит забывать и про простую модель линейной регрессии. Во-первых, потому что на ней построены многие сложные методы машинного обучения, включая нейронные сети. А, во-вторых, потому что зачастую прикладные бизнес-задачи легко, быстро и качественно решаются именно линейными моделями.
И для начала небольшой тест. Можно ли с помощью линейной модели описать:
— зависимость веса человека от его роста?
— длительность ожидания в очереди в магазине в разное время суток?
— посещаемость сайта в фазе экспоненциального роста?
— динамику во времени количества человек, ожидающих поезда на станции метро?
— вероятность, что клиент не оформит заказ на сайте в зависимости от его производительности?
Как вы догадываетесь, на все вопросы ответ будет «Да, можно». Так что линейные модели не так просты, как может показаться на первый взгляд. Поэтому давайте познакомимся с их богатым разнообразием.
Читать полностью »

IBM и X Prize Foundation объявили конкурс по искусственному интеллекту с призовым фондом в $5 млн - 1

Корпорация IBM вместе с организацией X Prize Foundation объявили конкурс Watson AI XPRIZE Cognitive Computing Competition. О старте конкурса объявили Дэвид Кенни (David Kenny), руководитель проекта IBM Watson, и Питер Диамандис (Peter Diamandis), председатель Фонда XPRIZE. Изначальная цель конкурса — использование искусственного интеллекта для выполнения прикладных задач, включая решение актуальных для человека проблем. К участию планируется привлечь команды разработчиков со всего мира.

Итоговая цель — объединение творческих умов в единое целое, создание команды, которая сможет генерировать креативные идеи, предлагать пути решения самых разных задач и проблем в медицине, промышленности, научной сфере, бизнесе. У Фонда XPRIZE в плане проведения конкурсов огромный опыт, поэтому IBM и решила объединить усилия с этой организацией.
Читать полностью »

6 дней назад около полуночи мы, команда «EC.Dota2» из четырех человек, начали работать над онлайн частью хакатона «Dota Science». Никто из нас ничего не знал об игре Dota2.

Сначала, хронологически, о первой, «онлайн» части. Есть сетка игр мирового финала «The Shanghai Major 2016». Нужно до матча предсказать его исход. Как показало время (но не описание конкурса), предсказывать нужно было матчи за 3, 4, 5 марта. Для обучения были даны исторические данные о матчах в Dota2 по разным прошлым турнирам с агрегированной информацией о каждом матче. Со среды пришлось начать недосыпать, т.к. все днем работают. Для онлайн этапа были разработаны две модели.

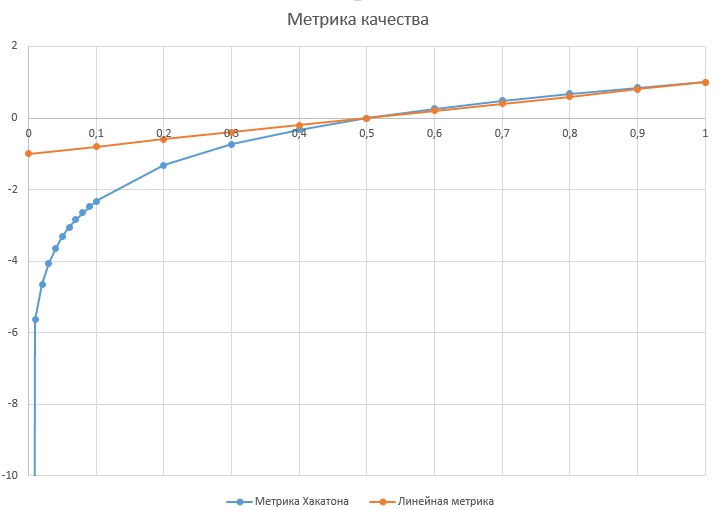
В качестве показателя качества прогноза использовалась следующая метрика: score=log2(p_winner)+1, где p_winner — предсказанная до начала матча вероятность победы команды, которая в результате победила.
Уроки участия в хакатоне «Dota Science» в рамках «Data Fest 2» - 1

Тут стоит сказать несколько слов о целях хакатона. Цель формальная — получить самую высокую относительно других оценку качества прогнозов. Цель, соответствующая смыслу Data Fest — построить самую лучшую, относительно других, модель для прогнозирования исхода матча методами машинного обучения.

Один выступающий в последний день Data Fest 2 (Nuker?) верно заметил, что «задачу машинного обучения всегда можно решить и без машинного обучения» (своими собственными нейронными сетями в голове). Кто использовал модели, кто использовал экспертный опыт, кто просто случайно играл? Неизвестно.

Финальная оценка первого этапа – среднее всех значений метрики качества для предсказанных вероятностей. Как показывает турнирная таблица первого этапа Хакатона, количество предсказаний на «команду» разнилось в 10-20 раз. Читать полностью »

Работа с приватными репозиториями и другие обновления платформы FlyElephant - 1

Команда платформы FlyElephant подготовила ряд обновлений, которые позволяют работать с приватными репозиториями, повышают безопасность системы и улучшают работу с задачами.

FlyElephant — это платформа для ученых, которая предоставляет готовую вычислительную инфраструктуру для проведения расчетов, помогает находить партнеров и совместно работать над проектами, а также управлять всеми данными из одного места. FlyElephant автоматизирует рутинные задачи и позволяет сосредоточиться на основных вопросах исследований.

В качестве вычислительного ресурса используется облако Azure. Пользователи могут запускать вычислительные задачи, написанные с помощью С++ (с поддержкой OpenMP), R, Python, Octave, Scilab, Java, Julia, OpenFOAM, GROMACS, Blender на серверах с количеством ядер от 1 до 32 и оперативной памятью до 448 ГБ.

Среди нововведений можно отметить следующие:
Читать полностью »

Сегодня, когда во всех деревнях и сёлах идёт нейрореволюция, мы всё больше убеждаемся, что нейросети — это чистая магия и манна-небесная. Их стали использовать везде и всюду, и даже встроили в Excel. Неявно, при виде сложной задачи многим представляется следующая картина:

Введение в практическую аналитику, или что общего у нейронных сетей с таблетками для похудения - 1

И сегодня мы займёмся совмещением приятного с полезным: разберём интересную (практическую) аналитическую задачу и заодно проанализируем ряд факторов, определяющих (не-)применимость нейронных сетей к аналитическим задачам.

Представьте, вы работаете аналитиком в какой-нибудь компании, которой важен её облик на Хабре (условно назовём её Почта.com). И тут к вам приходит девушка из PR-отдела и говорит: "Мы с менеджерами определили в качестве важного KPI нашего бренда Хабра-рейтинг компании. У нас есть бюджет и мы хотим понять, как его распределить, чтобы максимизировать Хабра-индекс. Нам нужно, чтобы ты определил ключевые факторы, которые на него влияют и вывел наиболее разумную стратегию. Попробуй там какие-нибудь нейросети".

Во время этой речи у вас начинает дергаться глаз, но спустя пару минут составляете список вопросов для анализа:

  • Q1: Какие ключевые факторы влияют на Хабра-индекс компании?
  • Q2: Где найти данные?
  • Q3: Какой будет оптимальная стратегия согласно восстановленной эмпирической зависимости?

Структура статьи

  1. Определяем потенциальные факторы
  2. Сбор данных
  3. Эффект кармы и рейтинга подписчиков и работников
  4. Финальная формула
  5. Анализ применимости нейросетей
  6. Анализ оптимальной стратегии

Читать полностью »

В данной статье мы выясним, почему связи важнее всего, что придет на смену BigData и что такое «колесо сансары» применительно к вашему бизнесу.

image Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js