Рубрика «big data» - 102

Один мой приятель, учитель латинского языка, в начале урока спрашивал своих студентов, выполнили ли они домашнее задание. Как правило, если не первый, то второй или третий ученик сознавался: простите, господин Учитель, я ничего не сделал. «Фак!» — говорил учитель. «Фак!» — повторял он, вводя в еще большее недоумение своих чад. «Сегодня мы будем проходить глагол третьего спряжения facio – делать», который в повелительном наклонении единственного числа так и произносится: fac! – делай!

Нет, мы не собираемся витийствовать о том, что не бывает хороших и плохих слов, а есть наша оценка оных. Также мы не будем говорить об истоках и функциях русской брани, не будем обсуждать моральную сторону вопроса, как и искать причинно-следственные связи ее употребления. Мы проведем небольшое исследование обсценной лексики на материалах русскоязычных соц. медиа, сделаем ряд замеров и расчетов на большой выборке из интернет-источников.
Читать полностью »

Вместе с компанией Edison продолжаем расследование возможностей системы Palantir.

Palantir и отмывание денег - 1

Palantir — частная американская компания, разработчик программного обеспечения анализа данных для организаций, основные заказчики — спецслужбы, инвестиционные банки, хедж-фонды. Основана в 2003 году группой инвесторов — выходцев из PayPal во главе с Питером Тилем.

До 2008 года ЦРУ было единственным заказчиком компании, когда с его разрешения программное обеспечение Palantir начало внедряться правоохранителям и в другие американские спецслужбы. С 2010 года началась активная кампания по публичному продвижению продукции компании на широком рынке.

В конце 2010 года представлены результаты шестнадцатимесячной разработки Palantir для тактико-аналитической поддержки военных операций в Афганистане, проводимых Армией США, в которой кроме серверных технологий и настольных клиентских программ применены также мобильные приложения для носимых устройств; вскоре в прессе появились сведения о том, что технологии Palantir предположительно были задействованы в спецоперации по уничтожению лидера «Аль-Каиды» Усамы бин Ладена весной 2011 года.

По состоянию на начало 2016 года считается четвёртым по капитализации стартапом в мире (после Uber, Xiaomi и Airbnb) с оценкой стоимости бизнеса в $20 млрд.

На официальном канале Palantir есть видео с демонстрацией работы аналитика, использующего систему Palantir в ходе расследования отмывания денег. По-моему, как-то так видели пользу информационных технологий «отцы-основатели» Вэнивар Буш («As We May Think»), Дуглас Энгельбарт («The Mother of All Demos») и Джозеф Ликлайдер («Интергалактическая компьютерная сеть» и «Симбиоз человека и компьютера»), о которых я писал немного ранее.

(За помощь с переводом спасибо Ворсину Алексею)

Читать полностью »

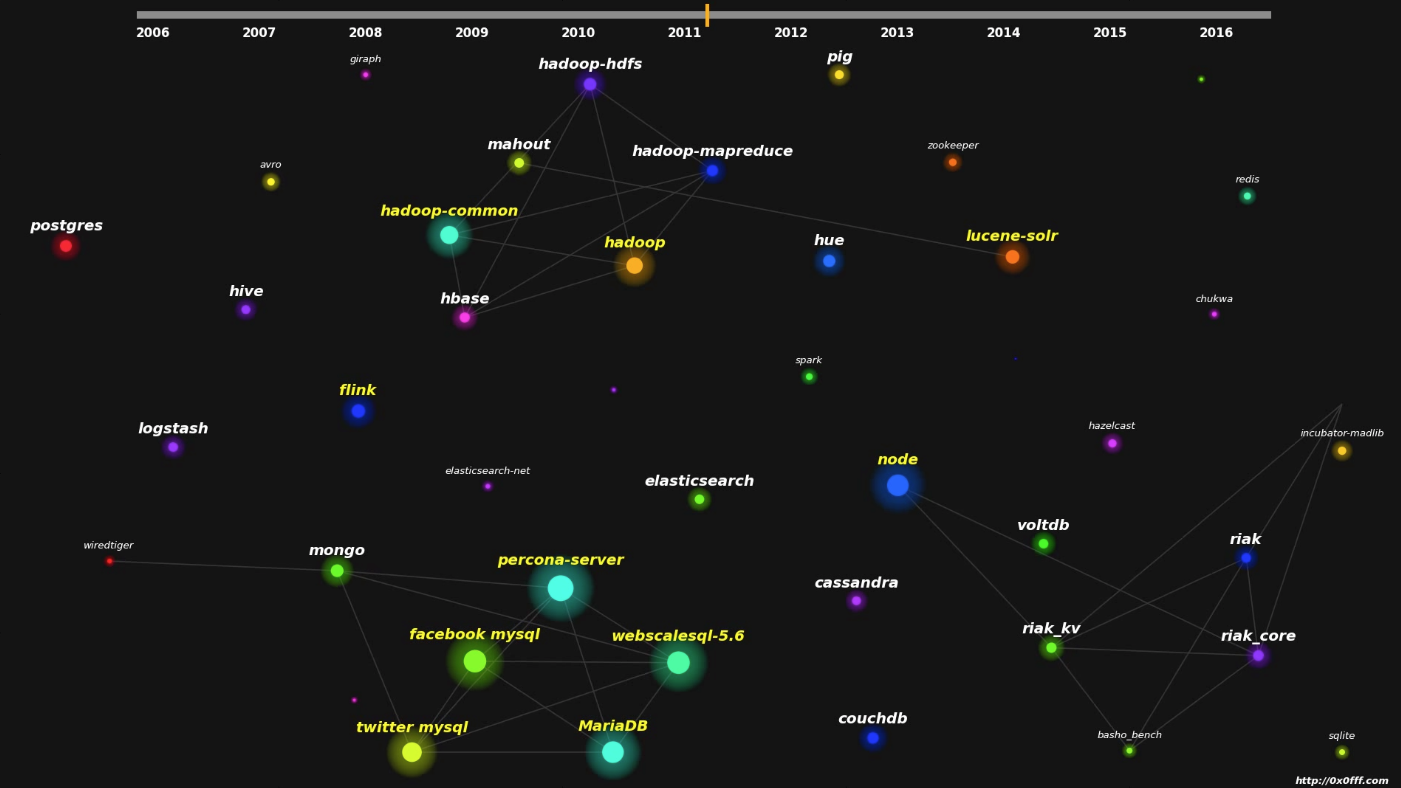
В своей работе вы используете MySQL, Postgres или Mongo, а может даже Apache Spark? Хотите знать с чего начинались эти проекты и куда они движутся сейчас? В этой статье я представлю соответствующую визуализацию

Визуализация инструментов обработки данных с Github - 1

Читать полностью »

Школа Данных «Билайн»: весна, знания, новый курс - 1

Привет.

Итак, третий курс Школы Данных «Билайн» подходит к завершению и мы набираем четвёртый.

У нас 18 занятий, 36 часов, все основные темы машинного обучения и анализа данных, куча практики, куча домашек, два Kaggle соревнования, презентации и воркшопы от партнеров, возможность устройства в Билайн в команду BigData для лучших студентов, сокурсники из различных областей бизнеса, где применяется машинное обучение и много чего ещё.
Читать полностью »

В свете текущих выходных, важно не забывать, что алкоголь и общение, вместе составляют не всегда хорошую комбинацию, даже у звезд. Тем не менее, многие из нас повторяют этот опыт снова и снова. И этот опыт дал американским ученым (Nabil Hossain с приятелями из University of Rochester) интересную идею. В итоге, американские ученые разработали нейронную сеть, способную распознавать в Twitter посты написанные в состоянии алкогольного опьянения. Кроме того, полученная математическая модель может определять, где авторы «пьяных» постов находились в момент их написания.
Об этом сообщает MIT Technology Review.

Ученые создали нейросеть, распознающую «пьяные» сообщения в Twitter - 1
Читать полностью »

В новом выпуске «Черной археологии датамайнинга» мы немного поиграемся в шпионов. Увидим, что может узнать обычный Data Specialist на основе открытых в сети данных.

Всё началось со статьи на хабре, о том, что некий анинимный хакер делился слитыми в сеть данными агентов ФБР. Я получил эти данные, и стал смотреть, что с ними можно сделать? В данных есть только фамилия, имя, и служебные мейлы и телефон – немного информации.

Fbi Detected: Как я обнаружил агентов ФБР - 1

Получив эти данные, я увидел, что они заканчиваются буквой J. То есть, датасет не полон. Интресено, каков его полный размер? Чтобы узнать его, надо построить статистику частоты встречаемости фамилий.

Для этого я начал искать наборы американских фамилий, и тут меня ждало открытие – в Америке можно найти открытые данные по, скажем, избирателям штата – как я понял, совершенно легально. Например, я за полчаса без проблем получаю данные всех избирателей штата Юта.

Читать полностью »

Во время общения с медиа мы в Relap.io часто сталкиваемся с массой заблуждений, в которые все верят, потому что так сложилось исторически. На сайте есть блоки типа «Читать также» или «Самое горячее» и т.п. Словом, всё то, что составляет обвязку статьи и стремится дополнить UX дорогого читателя. Мы расскажем, какие заблуждения есть у СМИ, которые делают контентные рекомендации, и развеем их цифрами.
 
HAbr1


Рекомендовать по тегам

Самое большое и самое популярное заблуждение. Чаще всего СМИ делают рекомендации в конце статьи по тегам. Так поступает Look At Me и РБК, например. Есть материал с тегами: трактор, Путин, сыр. К нему выводятся тексты про трактора, про Путина и сыр. На первый взгляд, логично:
вилладж
Подобная механика рекомендаций в реальной жизни выглядела бы так. Вы идёте в магазин за продуктами. И кладёте в корзину сливочное масло. К вам подходит консультант с потными от волнения ладошками и говорит: «О, я вижу, вы взяли масло и это значит, что вам нужно масло. Возьмите еще пять видов сливочного деревенского и подсолнечного и козьего масла». Максимум, что может случиться из ряда вон выходящее — вам предложат трансмиссионное, если вы читали что-то про автомобили. И это уже будет считаться rocket science.Читать полностью »

Как использовать Parquet и не поскользнуться - 1

О хранении данных в Parquet-файлах не так много информации на Хабре, поэтому надеемся, рассказ об опыте Wrike по его внедрению в связке со Spark вам пригодится.
В частности, в этой статье вы узнаете:

— зачем нужен “паркет”;
— как он устроен;
— когда стоит его использовать;
— в каких случаях он не очень удобен.

Читать полностью »

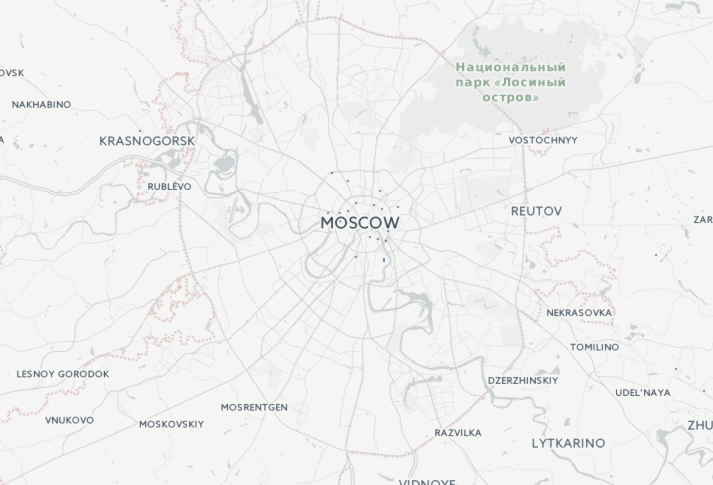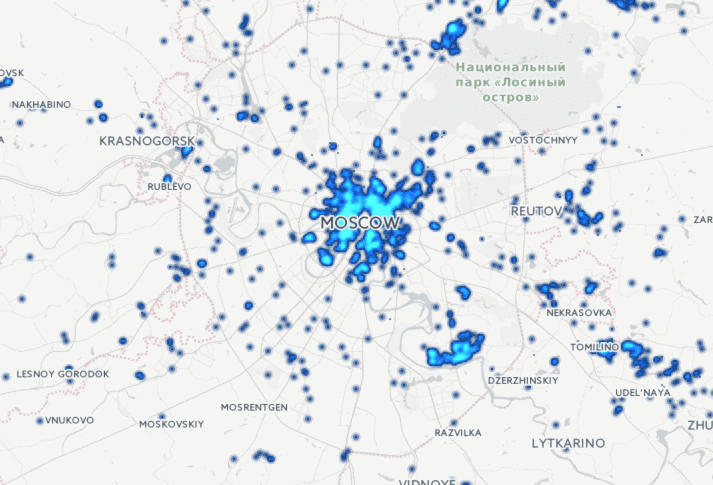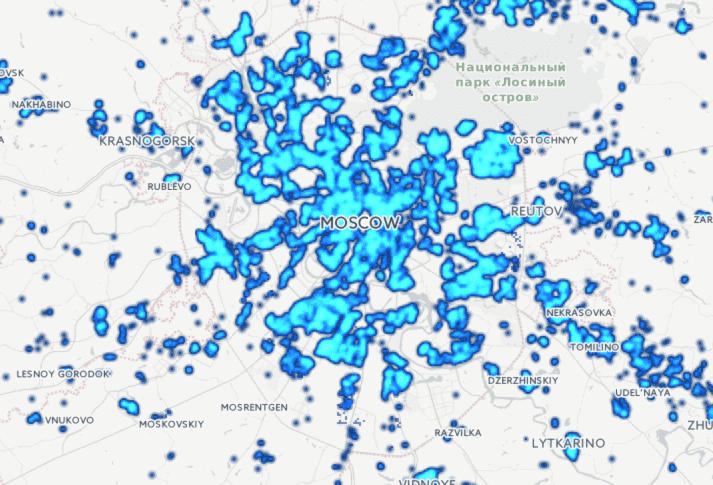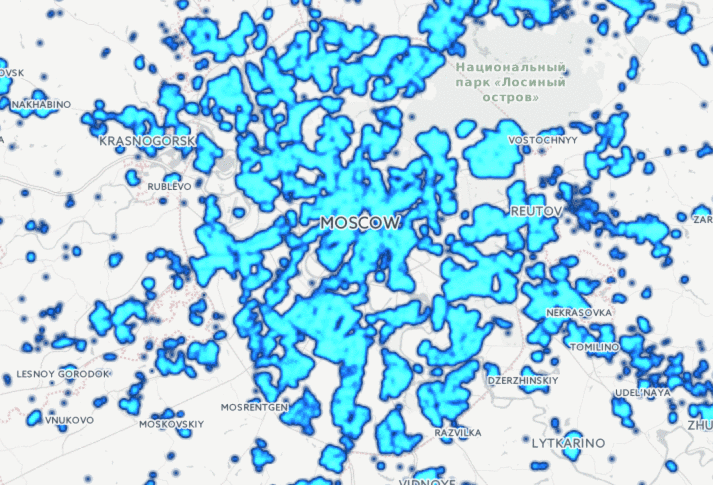
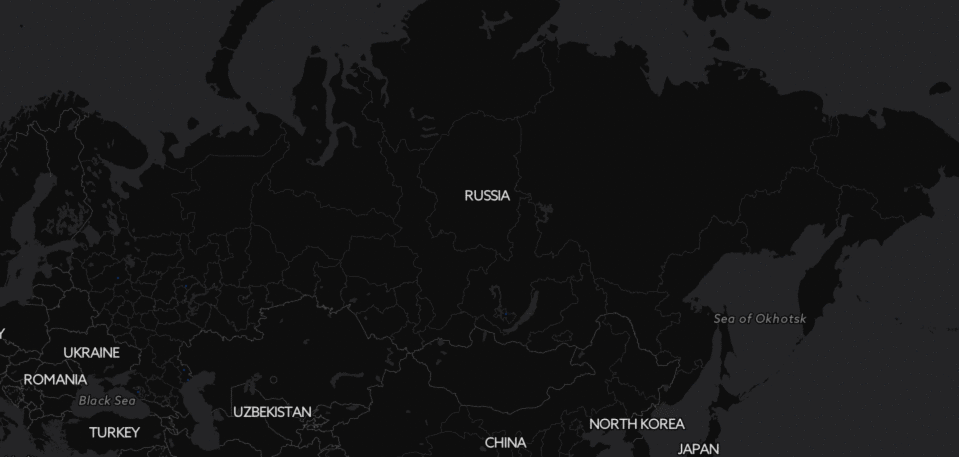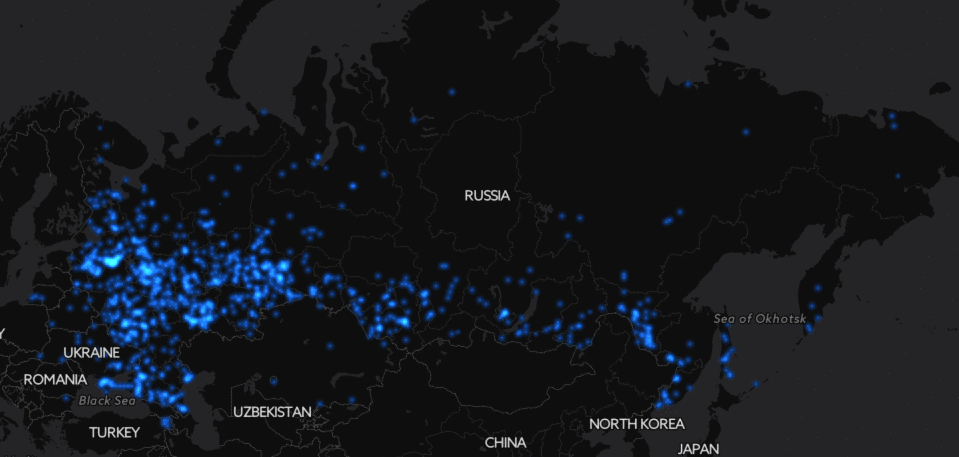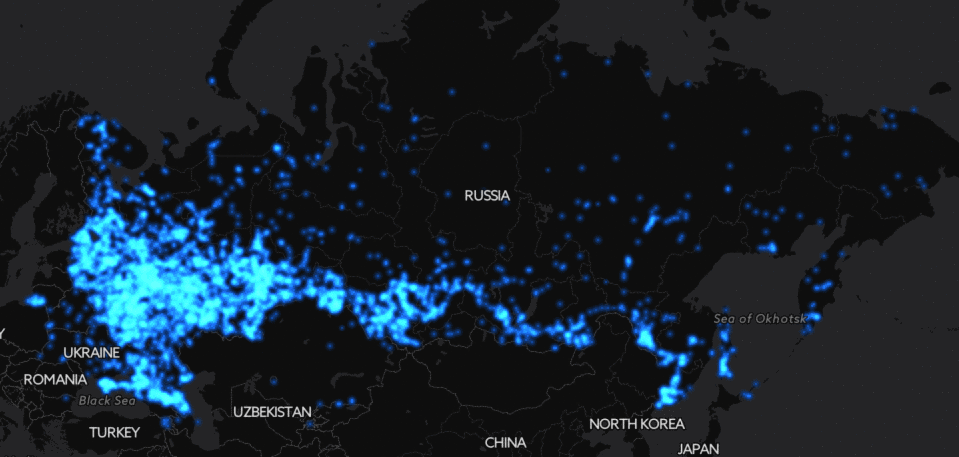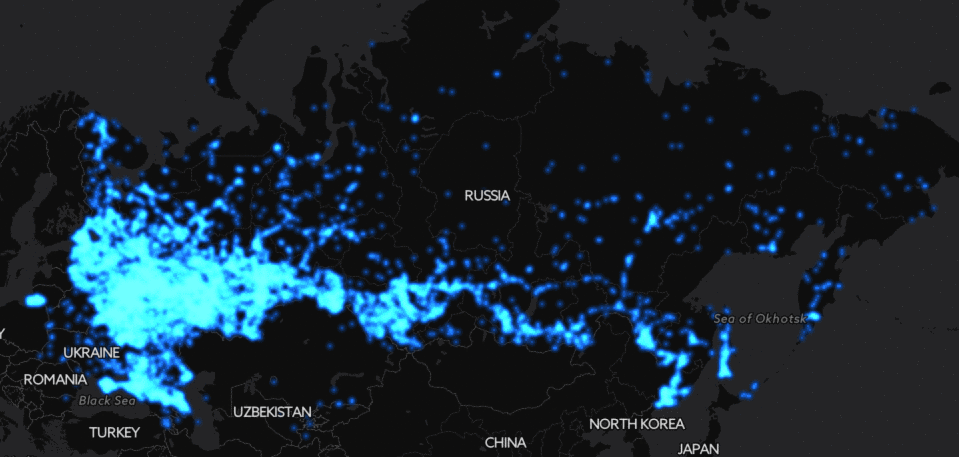
Есть прекрасный сайт www.reformagkh.ru. На нём можно найти, управляющую компанию, закреплённую за домом, сколько денег, на что тратится и всё такое. Но кроме этого можно узнать разные интересные вещи о нашей стране в целом, например, для каждого дома на сайте указана дата его постройки, поэтому можно посмотреть, как строилась Москва с 1900 года:
1 000 000 жилых домов России - 1

Ещё более эпичная картинка получается, если посмотреть на Россию целиком:
1 000 000 жилых домов России - 2
Читать полностью »

В этой статье хочу поделиться способом, который позволил нам прекратить хаос с процессингом данных. Раньше я считал этот хаос и последующий ре-процессинг неизбежным, а теперь мы забыли что это такое. Привожу пример реализации на BiqQuery, но трюк довольно универсальный.
Строим надёжный процессинг данных — лямбда архитектура внутри Google BigQuery - 1
У нас вполне стандартный процесс работы с данными. Исходные данные в максимально сыром виде регулярно подгружаются в единое хранилище, в нашем случае в BigQuery. Из одних источников (наш собственный продакшн) данные приходят каждый час, из других (обычно сторонние источники) данные идут ежедневно.

В последствии данные обрабатываются до состояния пригодного к употреблению разнообразными пользователями. Это могут быть внутренние дашборды; отчёты партнёрам; результаты, которые идут в продакшн и влияют на поведение продукта. Эти операции могут быть довольно сложными и включать несколько источников данных. Но по большей части мы с этим справляется внутри BigQuery с помощью SQL+UDF. Результаты сохраняются в отдельные таблицы там же.
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js