Рубрика «big data» - 101

В этой статье я хочу рассказать про важную задачу, о которой нужно думать и нужно уметь решать, если в аналитической платформе для работы с данными появляется такой важный компонент как Hadoop — задача интеграции данных Hadoop и данных корпоративного DWH. В Data Lake в Тинькофф Банке мы научились эффективно решать эту задачу и дальше в статье я расскажу, как мы это сделали.

Data Lake – от теории к практике. Методы интеграции данных Hadoop и корпоративного DWH - 1

Данная статья является продолжением цикла статей про Data Lake в Тинькофф Банке (предыдущая статья Data Lake – от теории к практике. Сказ про то, как мы строим ETL на Hadoop).

Читать полностью »

В 2009 году китайская киберразведка на своей шкуре испытала мощь всевидящего ока Palantir. Аналитики из Information Warfare Monitor раскрыли крупные китайские разведывательные операции — Ghostnet и Shadow Network. (отчет)

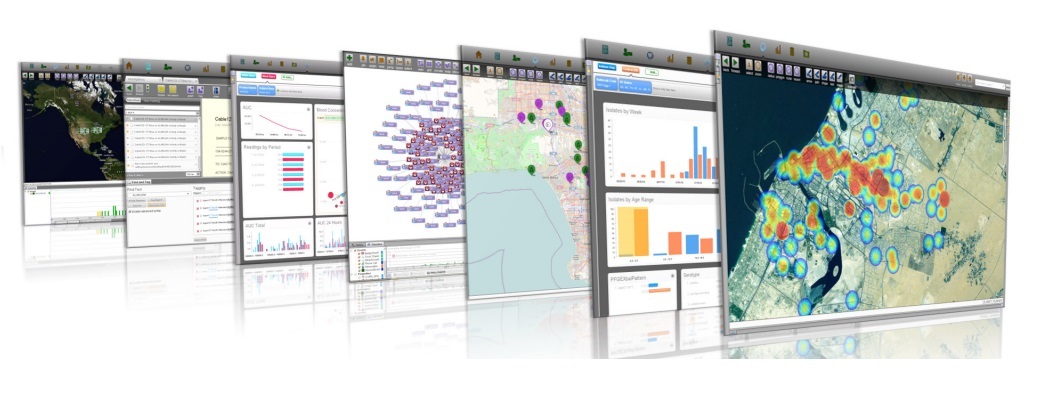
Вместе с компанией Edison продолжаем расследование возможностей системы Palantir.
Palantir: как обнаружить ботнет - 1

«Надеюсь, что немного осталось лет до того, как человеческий мозг и вычислительные машины будут тесно связаны, а получившееся партнерство будет думать так, как человеческий мозг никогда не сможет, и обрабатывать данные способами, недоступными известным нам машинам.» — Сказал Джозеф Ликлайдер 56 лет назад, стартанул кафедры информационных технологий в ведущих вузах Америки и начал строить ARPANET. — «Люди будут задавать цели, формулировать гипотезы, определять критерии и выполнять оценку. Компьютеры будут делать рутинную работу чтобы расчистить путь к открытиям в технических и научных областях».

«Взаимодополняемость человека и компьютера — не только глобальный факт. Это еще и путь к созданию успешного бизнеса. Я осознал это на собственном опыте, полученном в PayPal. В середине 2000-х наша компания, пережив крах пузыря доткомов, быстро росла, но нас тревожила одна серьезная проблема: из-за мошенничеств с кредитными картами мы теряли больше 10 миллионов долларов ежемесячно. Совершая сотни и даже тысячи переводов в минуту, мы не могли физически отслеживать каждый из них — никакая команда контролеров не в состоянии работать с подобной скоростью. Мы поступили так, как поступила бы на нашем месте любая команда инженеров: попытались найти автоматизированное решение.»
Сказал Питер Тиль и основал Palantir.

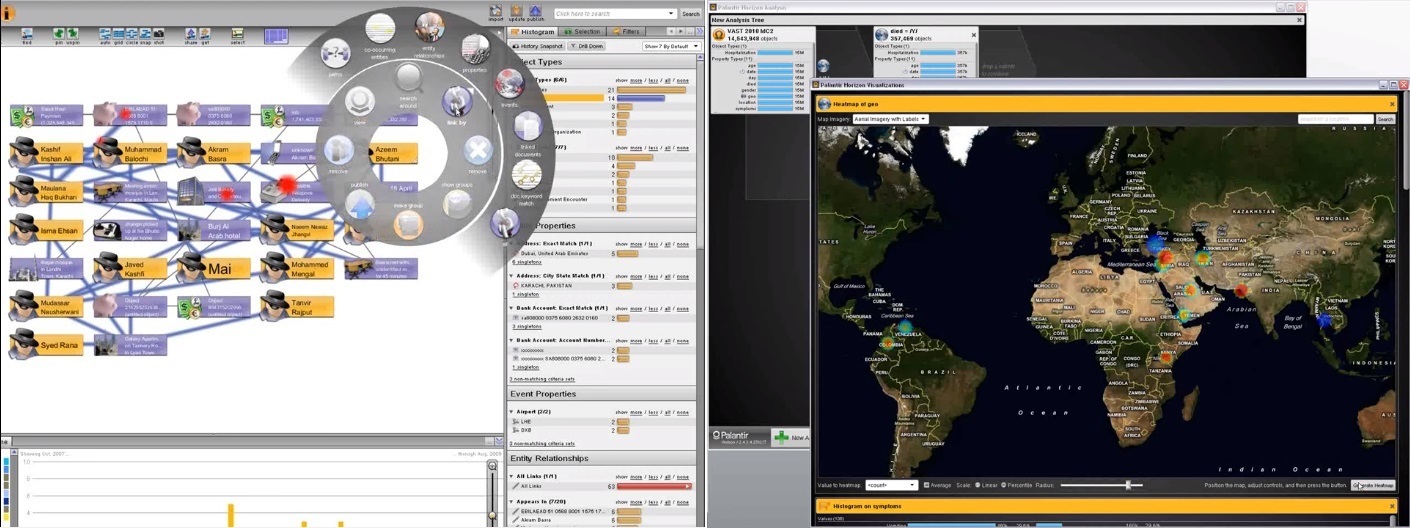
Под катом кейс о том, как с помощью инструмента финансовой аналитики можно вскрыть ботнет.
Кейс «вымышленный», но на скриншотах фигурируют данные 2009 года.

(За помощь с переводом спасибо Ворсину Алексею)
Читать полностью »

Цель этого рассказа — поделиться способами решения проблемы, над которой работали авторы при разработке рекомендательного сервиса imhonet.ru. Поскольку проблема не является чисто научно-технической, а скорее находится на стыке технологий и бизнеса и может быть полезна более широкой аудитории, чем обычный технический отчёт, мы выбрали именно такой формат представления нашей работы — попытались написать рассказ настолько простым языком, насколько это возможно. Первая часть рассказа посвящена довольно подробному обоснованию того, как правильно измерять качество работы алгоритмов рекомендательной системы. А в конце иллюстративно перечислено несколько примеров, в которых мы проводили эти измерения для решения конкретных задач.

image

Читать полностью »

Как данные в руках разведчиков аналитиков Palantir превращаются из неструктурированных в структурированные.

Вместе с компанией Edison продолжаем расследование возможностей системы Palantir.
Palantir: торговля оружием и распространение пандемии - 1

Palantir — частная американская компания, четвертый по капитализации (после Uber, Xiaomi и Airbnb) стартап в мире (данные на начало 2016 года). Основные заказчики — ЦРУ, военные, ЦКЗ и крупные финансовые организации.

По-моему, как-то так видели пользу информационных технологий «отцы-основатели» Вэнивар Буш («As We May Think»), Дуглас Энгельбарт («The Mother of All Demos») и Джозеф Ликлайдер («Интергалактическая компьютерная сеть» и «Симбиоз человека и компьютера»), о которых я писал немного ранее.

Под катом — два кейса (2010 года).

  • Первый — анализ распространения вируса во время национальной пандемии на основе пятнадцати миллионов записей обращений в больницу и трехсот пятидесяти семи тысячах записей о смерти.
  • Второй — анализ сотни отчетов из расследования по глобальной сети торговцев оружием.

(За помощь с переводом спасибо Ворсину Алексею)

Читать полностью »
Стек рассматриваемых технологий: Postgresql 9.3, Python 2.7 с установленным модулем «psycopg2».

Проблема

Как часто в вашей практике приходилось сталкиваться с задачей обработки таблиц большого объема (более 10 млн. записей)? Думаю вы согласитесь, что данная задача является довольно ресурсоемкой как в плане времени обработки, так и задействованных ресурсов системы. Сегодня я постараюсь показать альтернативный способ решения задачи.

Предложение:

В СУБД Postgresql есть прекрасный оператор для работы с большими объемами информации, а именно «COPY». Применение данного оператора позволяет нам читать и записывать огромные объемы информации в таблицу. В данной статье мы будем рассматривать режим чтения.

Согласно документации оператора «COPY» нам доступны несколько режимов чтения в файл либо в поток STDOUT, а также различные форматы, в том числе и «csv». Как раз его мы и постараемся использовать с максимальной пользой.
Читать полностью »

Прием докладов на конференцию по искусственному интеллекту и большим данным AI&BigData Lab - 1

4 июня в Одессе, наша команда FlyElephant совместно с GeeksLab будет проводить третью ежегодную техническую конференцию по искусственному интеллекту и большим данным — AI&BigData Lab.

Читать полностью »

Привет! Наконец-то долгожданная четвёртая статья нашего цикла о больших данных. В этой статье мы поговорим про такой замечательный инструмент как Hbase, который в последнее время завоевал большую популярность: например Facebook использует его в качестве основы своей системы обмена сообщений, а мы в data-centric alliance используем hbase в качестве основного хранилища сырых данных для нашей платформы управления данными Facetz.DCA

В статье будет рассказано про концепцию Big Table и её свободную реализацию, особенности работы и отличие как от классических реляционных баз данных (таких как MySQL и Oracle), так и key-value хранилищ, таких как Redis, Aerospike и memcached.
Заинтересовало? Добро пожаловать под кат.

Big Data от А до Я. Часть 4: Hbase - 1

Читать полностью »

21 популярная и 21 непопулярная технология в IT - 1

Популярно или не очень? Посмотрим, что приходит и уходит в мире разработки.
Программисты любят иронизировать над миром моды, где ветра трендов дуют туда-сюда. Юбки становятся длиннее и короче, цвета приходят и уходят, галстуки становятся шире, потом уже. Но в мире технологий строгость, наука, математика и точность господствуют над причудой.
Это не значит, что программирование — профессия, лишенная тенденций. Разница в том, что тенденции программирования управляются большей эффективностью, увеличенной вариативностью и простотой использования. Новые технологии по большей части затмевают предыдущие. Это меритократия, а не власть прихоти.
Дальше список популярного и не очень популярного среди программистов сегодня. Не все согласятся с этим списком. Это то, что делает программирование бесконечно увлекательной профессией: быстрые изменения, жаркие дебаты и внезапные возвращения.Читать полностью »

Школа Данных «Билайн»: весна, пора зарабатывать на Big Data - 1

Привет, Мегамозг!

Итак, мы запустили наш курс Big Data для менеджеров. На этом курсе мы учим тому, как менеджерам, маркетологам и владельцам бизнеса успешно применять Big Data у себя в компании.

Как выделять направления и формировать бизнес-кейсы, как ставить задачи, кого набирать в команду, как выстраивать процессы, как выбирать технологии, сколько все это стоит и, собственно, что может анализ данных, машинное обучение и Big Data привнести в зависимости от направления бизнеса.

Первый набор уже прошел обучение. Впечатления участников можно почитать здесь и здесь. Более подробно о курсе можно прочитать здесь.

Мы набираем второй. Начало занятий 12 апреля.
Читать полностью »

Привет! В этом цикле статей я планирую рассказать о том, как можно организовать сбор и передачу данных с помощью одного из инструментов Hadoop — Apache Flume.

Flume — управляем потоками данных. Часть 1 - 1

Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js