
В Ташкенте квартиру в аренду ищут не на большом сайте объявлений, а в Telegram. Каналов с объявлениями — сотни: у каждого агентства свой, плюс районные, студенческие, «без посредников». Одну и ту же квартиру выкладывают в пяти-десяти из них, с разными фото, ценой в долларах или сумах, на русском, узбекском латиницей и узбекском кириллицей — часто в одном посте.
Рубрика «дедупликация»
Как мы собираем и склеиваем объявления из 200+ Telegram-каналов Ташкента
2026-11-20 в 8:36, admin, рубрики: gemini, llm, phash, postgis, telegram, дедупликация, медиана, недвижимость, парсинг, ташкент5 технических граблей на пути к AI‑агрегатору Telegram‑каналов
2026-09-23 в 5:58, admin, рубрики: n8n, rss, telegram, дедупликацияДелаю в одиночку приложение, которое собирает публикации из подобранных Telegram‑каналов по темам, убирает дубли и шум с помощью AI‑классификации и превращает результат в короткий аудио‑дайджест. Ниже — не обзор архитектуры целиком, а разбор конкретных мест, где план и реальность разошлись, и что пришлось чинить.
Грабля 1. RSS — не от Telegram, а через чужой мост со своим невидимым лимитом
Как создать архитектуру B2B-пайплайна, в которой не проверяется лишнее и не теряется нужное
2026-08-14 в 12:49, admin, рубрики: at-least-once, B2B-пайплайн, crawler, DNS, email validation, email-аутрич, smtp, дедупликацияЗадача и откуда она появилась
При разработке стратегии email-аутрича была поставлена задача: без готовой базы B2B-контактов ежедневно находить новые B2B-компании, которые подходят под ЦА, и распределять их по сценариям коммуникации.
Как за один вечер разгрести 36 000 фотографий и почту с 2005 года, руками AI-агента и локальных моделей
2026-06-14 в 8:48, admin, рубрики: CLIP, czkawka, insightface, mlx, Qwen2.5-VL, дедупликация, диаризация, локальные модели, распознавание лицЕсть задачи, которые не делаются никогда. Не потому что сложные, а потому что объём убивает любое намерение на втором часу. У меня такой задачей был фотоархив: около 36 000 фото и видео, 222 ГБ, копившиеся 20 лет и размазанные вообще везде:
-
часть в OneDrive, разложенная по годам;
-
часть там же, но в свалках: дампы с телефонов, выгрузки из WhatsApp, папка буквально с названием «разобрать старые фото», которая ждала своего часа лет десять;
-
часть уже в Apple Photos, с iPhone, сама по себе и никак не связанная с остальным архивом;
maxpack: межфайловая дедупликация на версионных данных
2026-04-06 в 7:16, admin, рубрики: 7z, snapshots, tar, versioned data, zstd, архивация, дедупликация, сжатие данныхПредставьте: у вас 100 файлов, 90% содержимого повторяется между ними. Вы пакуете их через tar | zstd. Получаете сжатие порядка 3.1x. А могли бы получить 10.0x.
Проблема в том, что обычная упаковка не знает, что файлы похожи. tar склеивает их в линейный поток и отдаёт компрессору. zstd работает в пределах окна и плохо сопоставляет одинаковые куски, если они разнесены по потоку на десятки мегабайт.
Колин Персиваль, автор tarsnap — математик, криптограф и программист. Невольный пособник крипты
2023-06-05 в 9:00, admin, рубрики: AWS, bsdiff, EC2, freebsd, litecoin, PiHex, portsnap, ruvds_статьи, scrypt, tar, Tarsnap, Блог компании RUVDS.com, дедупликация, Колин Персиваль, криптография, олимпиады по математике, Программирование, Софт, формула Беллара, число пи Выдающиеся программисты современности часто оказываются самоучками. Иногда попадаются специалисты с официальным академическим образованием в области компьютерных наук. Или учёные из других областей: физики, математики, криптографы. Все они вносят в программирование академические знания и научную основательность.
Типичный пример — д-р математических наук Колин Персиваль (Colin Percival), бывший директор по безопасности FreeBSD, автор уникального сервиса резервного копирования Tarsnap и других проектов.
Выдающийся криптограф, который без своего желания оказался причастен к созданию Litecoin. Сотни криптовалют основаны на алгоритме, который придумал и написал скромный математик из Канады.
Читать полностью »
RSync на стероидах с поддержкой Windows
2023-05-10 в 9:00, admin, рубрики: casync, CDC, CDC RSync, cdc_rsync, cdc_stream, Content-Defined Chunking, rcp, rolling hash, Rsync, ruvds_статьи, scp, sftp, ssh, stadia, адресация по контенту, Алгоритмы, Блог компании RUVDS.com, дедупликация, резервное копирование, сжатие данных, синхронизация данных, системное администрирование, скользящий хеш
На Хабре периодически рассказывают о новых инструментах для синхронизации данных. Это интересная тема. Такие программы используются:
- для синхронизации файлов на разных устройствах,
- дедупликации,
- резервного копирования,
- сжатия.
Малейшая оптимизация даёт экономию трафика, места, ускоряет синхронизацию и общую производительность любых систем. Всё, везде и сразу. В эпоху веб-приложений и клиент-серверной архитектуры со множеством девайсов, которые работают в единой инфраструктуре, синхронизация — Святой Грааль, одна из базовых технологий в компьютерной области.
Кроме того, инструменты синхронизации интересны с алгоритмической точки зрения. Любопытно, как люди умудряются оптимизировать базовые алгоритмы типа rsync, которые вроде бы работают идеально. Но нет, всегда можно придумать что-то получше.
Читать полностью »
Как посчитать «похожесть» номеров в паспортах. И найти одинаковые даже с опечатками
2020-01-15 в 10:52, admin, рубрики: cdi, data mining, data quality, Алгоритмы, Анализ и проектирование систем, Блог компании HFLabs, дедупликация, документы, информационная безопасность, качество данных, номера паспортов, паспорта
Продукты HFLabs ищут дублированных клиентов в базах федеральных компаний. Очевиднейший способ найти одинаковые клиентские карточки — сравнить паспорта или другие документы, удостоверяющие личность.
Раньше мы сравнивали номера документов строго: одинаковые — отлично, нет — извините. На ручной разбор из-за опечатки в номере уходили даже те карточки, у которых совпадали ФИО и адреса́ проживания. Такой подход излишне нагружал персонал заказчиков.
Поэтому мы с головой залезли в данные, изучили статистику и вывели критерии — когда разные номера действительно разные, а когда дело в опечатках. Рассказываю, как работает алгоритм.
Читать полностью »
Как уплотнить до 90% хранение бэкапов в объектном хранилище
2019-07-30 в 6:23, admin, рубрики: s3, Блог компании КРОК Облачные сервисы, бэкап, виртуализация, данные, дата-центр, дедупликация, облачные сервисы, сервис, хранение данных, хранилище, цодНаши турецкие клиенты попросили нас правильно настроить бэкап для дата-центра. Мы делаем подобные проекты в России, но именно здесь история была больше про исследование того, как лучше сделать.
Дано: есть локальное S3-хранилище, есть Veritas NetBackup, который обзавёлся новым расширенным функционалом по перемещению данных в объектные хранилища теперь уже с поддержкой дедупликации, и есть проблема со свободным местом в этом локальном хранилище.
Задача: сделать всё так, чтобы процесс хранения резервных копий был быстр и дешев.
Собственно, до этого в S3 всё складывалось просто файлами, причём это были полные слепки критичных машин дата-центра. То есть не так, чтобы очень оптимизированно, но зато всё работало на старте. Сейчас же пришло время разобраться и сделать правильно.
На картинке то, к чему мы пришли:
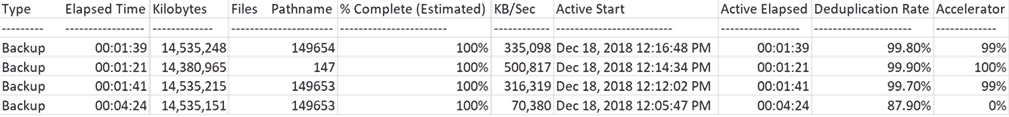
Как видно, первый бэкап делался медленно (70 Мб/с), а последующие бэкапы тех же систем — значительно быстрее.
Собственно, дальше чуть больше деталей про то, какие там особенности. Читать полностью »
Сократить бэкапы на 99.5% с hashget
2019-06-17 в 5:28, admin, рубрики: hashget, архиваторы, дедупликация, резервное копирование, сжатие, системное администрированиеhashget — это бесплатный, оперсорсный дедупликатор — похожая на архиватор утилита, которая позволяет значительно сократить размер бэкапов, а так же организовать схемы инкрементального и дифференциального бэкапа и не только.
Это обзорная статья для описания возможностей. Само использование hashget (довольно простое) описано в README проекта и wiki-документации.
Сравнение
По закону жанра, начну сразу с интриги, сравнения результатов:
| Data sample | unpacked size | .tar.gz | hashget .tar.gz |
|---|---|---|---|
| WordPress-5.1.1 | 43 Mb | 11 Mb ( 26% ) | 155 Kb ( 0.3% ) |
| Linux kernel 5.0.4 | 934 Mb | 161 Mb ( 20% ) | 4.7 Mb ( 0.5% ) |
| Debian 9 (LAMP) LXC VM | 724 Mb | 165 Mb ( 23% ) | 4.1 Mb ( 0.5% ) |
Предыстория, каким должен быть идеальный и эффективный бэкап
Каждый раз когда я делал бэкап свежесозданной виртуалки мне не давало покоя чувство, что я что-то делаю не так. Почему у меня получается увесистый бэкап от системы, где моего бесценного нетленного творчества — однострочный index.html с текстом "Hello world"?