Привет. В конце прошлого года мы стали автоматически скрывать номера автомобилей на фотографиях в карточках объявлений на Авито. О том, зачем мы это сделали, и какие есть способы решения таких задач, читайте в статье.
Рубрика «machine learning» - 28
Для чего и как мы скрываем госномера автомобилей в объявлениях Авито
2019-04-09 в 10:17, admin, рубрики: computer vision, development, machine learning, object detection, production, python, Алгоритмы, машинное обучение, Программирование
Обман нейронной сети для начинающих
2019-03-28 в 6:01, admin, рубрики: adversarial attacks, digital security, machine learning, python, Блог компании «Digital Security», информационная безопасность, машинное обучение
В рамках ежегодного контеста ZeroNights HackQuest 2018 участникам предлагалось попробовать силы в целом ряде нетривиальных заданий и конкурсов. Часть одного из них была связана с генерированием adversarial-примера для нейронной сети. В наших статьях мы уже уделяли внимание методам атаки и защиты алгоритмов машинного обучения. В рамках же этой публикации мы разберем пример того, как можно было решить задание с ZeroNights Hackquest при помощи библиотеки foolbox.
SNA Hackathon 2019: усложняем архитектуру — упрощаем признаки
2019-03-26 в 13:30, admin, рубрики: machine learning, Алгоритмы, Блог компании Mail.Ru Group, машинное обучение
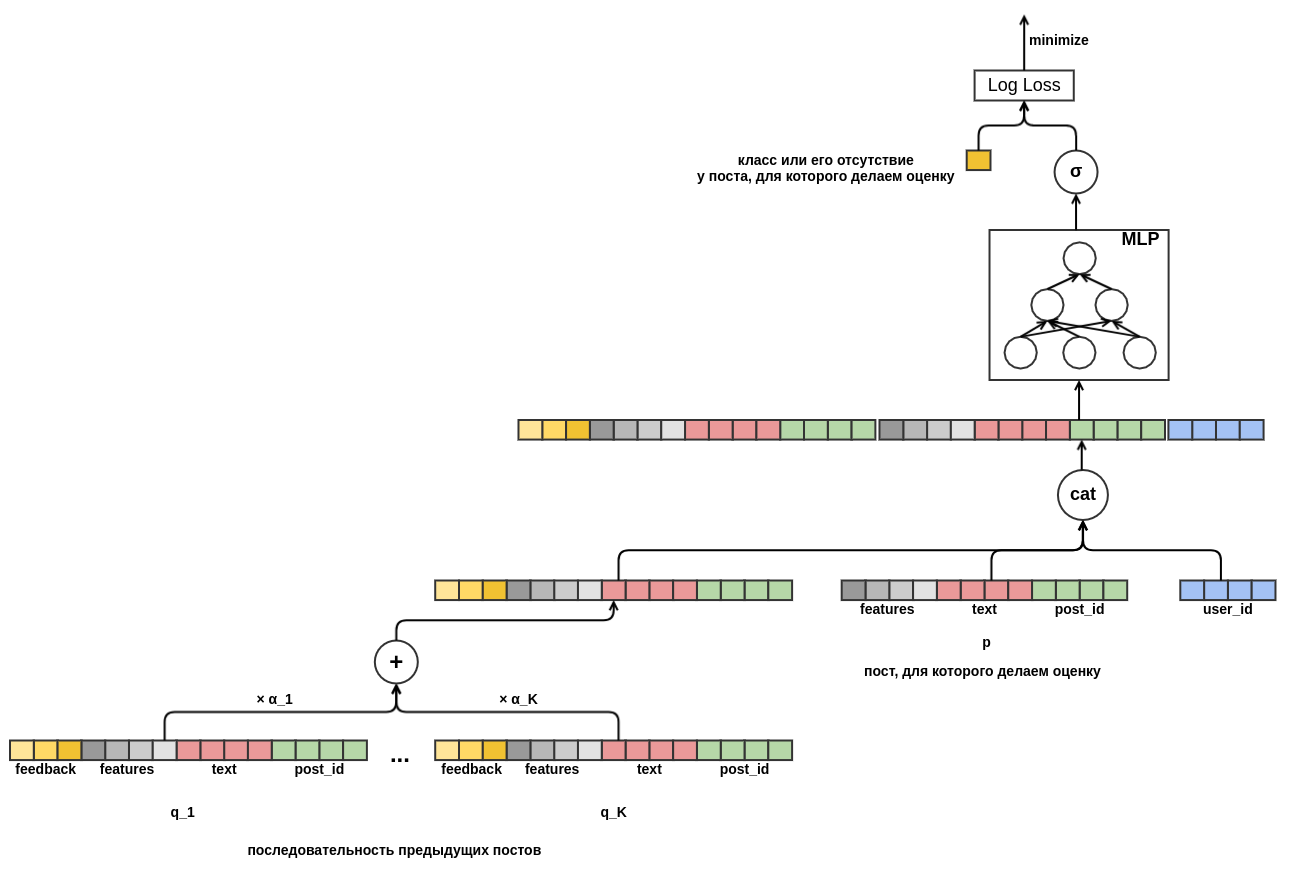
В этой статье я расскажу про свое решение текстовой части задачи SNA Hackathon 2019. Какие-то из предложенных идей будут полезны участникам очной части хакатона, которая пройдет в московском офисе Mail.ru Group с 30 марта по 1 апреля. Кроме того, этот рассказ может быть интересен и читателям, решающим практические задачи машинного обучения. Так как я не могу претендовать на призы (я работаю в Одноклассниках), я постарался предложить наиболее простое, но при этом эффективное и интересное решение.
Читая про новые модели машинного обучения, я хочу понять, как рассуждал автор, работая над задачей. Поэтому в этой статье я попробую подробно обосновать все компоненты своего решения. В первой части я расскажу про постановку задачи и ограничения. Во второй — про эволюцию модели. Третья часть посвящена результатам и анализу модели. Наконец, в комментариях я постараюсь ответить на любые возникшие вопросы. Нетерпеливые читатели могут сразу посмотреть на финальную архитектуру.
Читать полностью »
Big data, deus ex machina
2019-03-18 в 9:00, admin, рубрики: big data, BigData, data mining, Hadoop, machine learning, Блог компании Mail.Ru Group, машинное обучение
«Данные — это новая нефть». Эту фразу на выступлении для PopTech произнёс несколько лет назад Джер Торп (Jer Thorp), художник и эксперт в вопросах анализа и визуализации данных, один из основателей «Бюро креативных исследований». Сегодня мы хотим поговорить не просто о данных, а о больших данных. Разбираемся, какие данные big, а какие нет, как они работают и как на этом зарабатывает бизнес.
Говорит и показывает: отличается ли риторика популярных украинских политиков?
2019-03-11 в 12:29, admin, рубрики: machine learning, natural language processing, open data, python, sklearn, машинное обучение, открытые данныеМожно ли по цитате определить, кто из политиков ее автор? Украинская НКО Vox Ukraine делает проект VoxCheck, в рамках которого проверяет высказывания наиболее рейтинговых политиков. Недавно они выложили всю базу проверенных цитат. Я как раз слушаю курсы по NLP и решила проверить, насколько точно по тексту цитаты можно определить ее автора.
Disclaimer. Эта статья написана из интереса к теме и желания опробовать изученный материал на практике, без претензий на максимально точный и детальный анализ.
Читать полностью »
Deep Learning — не только котики на мобилках или как мы производим дефектовку тележек локомотивов
2019-03-11 в 11:02, admin, рубрики: machine learning, python, Алгоритмы, Блог компании Open Data Science, машинное обучение, обработка изображений
Буквально пару дней назад компания Aurorai передала в опытную эксплуатация систему распознавания дефектов и контроля состояния тележек для локомотивов Ермак. Задача нетривиальная и очень интересная, первым этапом которой было предложено оценить состояние тормозных колодок и ширины бандажа. Нам удалось решить задачу с точность до 1мм при скорости локоматива до 30 км/ч! Хочу отметить, что благодаря специфики можно было использовать “TTA (test-time augmentation)” – яркий пример kaggle-style хака из соревнований, который плохо ложится на прод и семантическую сегментацию на базе se_resnext50 encoder, которая даёт поразительный по точности результат в предсказании маски.
Читать полностью »
Руководство по развертыванию моделей машинного обучения в рабочей среде в качестве API с помощью Flask
2019-03-07 в 9:55, admin, рубрики: data science, machine learning, python, Блог компании Отус, машинное обучениеДрузья, в конце марта мы запускаем новый поток по курсу «Data Scientist». И прямо сейчас начинаем делиться с вами полезным материалом по курсу.
Введение
Вспоминая ранний опыт своего увлечения машинным обучением (ML) могу сказать, что много усилий уходило на построение действительно хорошей модели. Я советовался с экспертами в этой области, чтобы понять, как улучшить свою модель, думал о необходимых функциях, пытался убедиться, что все предлагаемые ими советы учтены. Но все же я столкнулся с проблемой.
Как же внедрить модель в реальный проект? Идей на этот счет у меня не было. Вся литература, которую я изучал до этого момента, фокусировалась только на улучшении моделей. Я не видел следующего шага в их развитии.
Именно поэтому я сейчас пишу это руководство. Мне хочется, чтобы вы столкнулись с той проблемой, с которой столкнулся я в свое время, но смогли достаточно быстро ее решить. К концу этой статьи я покажу вам как реализовать модель машинного обучения используя фреймворк Flask на Python.Читать полностью »
Анализ данных на Scala — суровая необходимость или приятная возможность?
2019-03-06 в 13:03, admin, рубрики: big data, data mining, machine learning, scala, spark, Блог компании Mail.Ru Group, Блог компании Одноклассники, машинное обучение
Традиционными инструментами в сфере Data Science являются такие языки, как R и Python — расслабленный синтаксис и большое количество библиотек для машинного обучения и обработки данных позволяет достаточно быстро получить некоторые работающие решения. Однако бывают ситуации, когда ограничения этих инструментов становятся существенной помехой — в первую очередь, если необходимо добиться высоких показателей по скорости обработки и/или работать с действительно крупными массивами данных. В этом случае специалисту приходится, скрепя сердце, обращаться к помощи "темной стороны" и подключать инструменты на "промышленных" языках программирования: Scala, Java и C++.
Но так ли уж темна эта сторона? За годы развития инструменты "промышленного" Data Science прошли большой путь и сегодня достаточно сильно отличаются от своих же версий 2-3 летней давности. Давайте попробуем на примере задачи SNA Hackathon 2019 разобраться, насколько экосистема Scala+Spark может соответствовать Python Data Science.
Машинное обучение в Додо. Как запустить новое направление, если ты разработчик
2019-03-06 в 5:57, admin, рубрики: data mining, dodopizza, dodopizzaengineering, machine learning, Алгоритмы, Блог компании Dodo Pizza Engineering, додо, Додо Пицца, ИТ в Додо Пицце, ИТ в пиццерии, машинное обучениеПо катом история о том, как в Додо появилось направление машинного обучения. Спойлер: это я его запустил. Хардкорных технических подробностей тут не будет, обязательно посвящу им отдельную статью. Сегодня больше про мотивацию и поддержку коллег.
Kaggle: не можем ходить — будем бегать
2019-03-06 в 5:22, admin, рубрики: cnn, data mining, gru, kaggle, keras, LightGBM, LSTM, machine learning, RNN, scikit-learn, Блог компании Singularis, искусственный интеллект, машинное обучение, рекуррентная нейронная сеть, финансы в ITНасколько сложна тема машинного обучения? Если Вы неплохо математически подкованы, но объем знаний о машинном обучении стремится к нулю, как далеко Вы сможете зайти в серьезном конкурсе на платформе Kaggle?