Рубрика «monitoring» - 4

.NET – управляемая среда выполнения. Это означает, что в ней представлены высокоуровневые функции, которые управляют вашей программой за вас (из Introduction to the Common Language Runtime (CLR), 2007 г.):

Среда выполнения предусматривает множество функций, поэтому их удобно разделить по следующим категориям:

  1. Основные функции, которые влияют на устройство других. К ним относятся:
    1. сборка мусора;
    2. обеспечение безопасности доступа к памяти и безопасности системы типов;
    3. высокоуровневая поддержка языков программирования.
  2. Дополнительные функции– работают на базе основных. Многие полезные программы обходятся без них. К таким функциям относятся:
    1. изолирование приложений с помощью AppDomains;
    2. защита приложений и изолирование в песочнице.
  3. Другие функции – нужны всем средам выполнения, но при этом они не используют основные функции CLR. Такие функции отражают стремление создать полноценную среду программирования. К ним относятся:
    1. управление версиями;
    2. отладка/профилирование;
    3. обеспечение взаимодействия.

Видно, что хотя отладка и профилирование не являются основными или дополнительными функциями, они находятся в списке из-за ‘стремления создать полноценную среду программирования’.
Мониторинг .NET приложений - 1

Читать полностью »

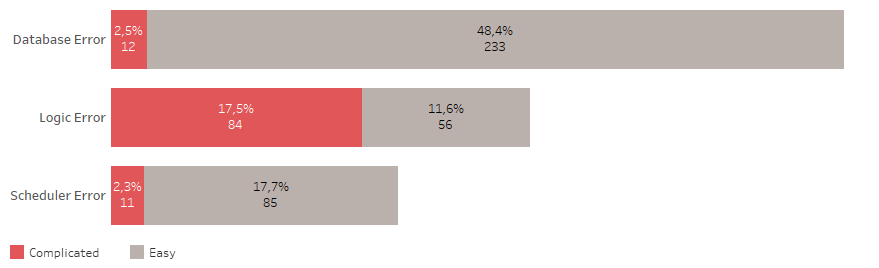
Многие используют специализированные инструменты для создания процедур извлечения, трансформации и загрузки данных в реляционные базы данных. Процесс работы инструментов логируется, ошибки фиксируются.

В случае ошибки в логе содержится информация о том, что инструменту не удалось выполнить задачу и какие модули (часто это java) где остановились. В последних строках можно найти ошибку базы данных, например, нарушение уникального ключа таблицы.

Чтобы ответить на вопрос, какую роль играет информация об ошибках ETL, я классифицировал все проблемы, произошедшие за последние два года в немаленьком хранилище.

imageЧитать полностью »

Быстрая локализация проблем производительности Microsoft SQL Server в Quest Foglight - 1

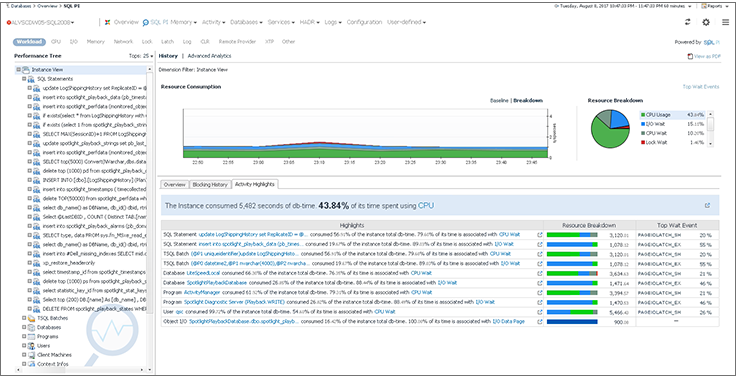
В прошлой статье об инструменте для мониторинга Foglight for Databases мы рассказывали о возможностях контроля из единого интерфейса SQL Server, Oracle, PostgreSQL, MySQL, SAP ASE, DB2, Cassandra и MongoDB. Сегодня разберём подходы к быстрому выявлению причин нештатной работы Microsoft SQL Server:

  • Поиск источника блокировки;
  • Сравнение настроек БД «было-стало» с привязкой к метрикам производительности;
  • Поиск изменений в структуре БД, из-за которых снизилась производительность.

Подробности под катом.
Читать полностью »

Chaos Constructions 2019

24-25 августа, традиционно в последние выходные лета, в Санкт-Петербурге пройдет компьютерный фестиваль Chaos Constructions 2019. На конференции в рамках фестиваля вашему вниманию будут представлены более 60 докладов на разные тематики.

  • Безопасность
  • Администрирование
  • Программирование
  • Разработка игр и другие

.

Изначально фестиваль был посвящен демосцене, а те компьютеры, которые теперь ретро, были самыми современными. Все началось в 1995 году с фестиваля ENLiGHT, который был организован Петром Соболевым (frog). В те годы толком не было ни системного администрирования, ни интернета, первые программисты создавали код, который выводил звуки и анимацию. Первопроходцы собирались раз в год под одной крышей показать свои работы и поделиться кодом, который и сейчас доступен для просмотра и изучения на http://ftp.cc.org.ru, где можно посмотреть работы за все эти годы. Из демопати ENLiGHT вырос компьютерный фестиваль Chaos Constructions. В 1999 году мероприятие впервые проходило под новым именем, постепенно на фестивале появилась выставка из коллекций энтузиастов. Сейчас эта выставка известна как объединение RTS, вы можете посещать её в разных городах России и на крупнейших фестивалях, и на небольших мероприятиях.
image
Читать полностью »

21 августа трансляция Zabbix Moscow Meetup #5 - 1

Привет!

Меня зовут Илья Аблеев, я работаю в команде мониторинга Badoo. 21 августа приглашаю на традиционную, пятую, встречу сообщества специалистов по Zabbix в нашем офисе!

Поговорим о вечной боли — хранилищах исторических данных. Многие сталкивались с проблемами производительности, вызванными типичными причинами: низкой скоростью дисков, недостаточно хорошим тюнингом СУБД, внутренними процессами Zabbix, которые удаляют старые данные и т.п. Но не всегда всё сводится к стандартным решениям. 

«Из коробки» в Zabbix’е доступно два вида бэкенда: MySQL и PostgreSQL. Не так давно добавили поддержку noSQL хранилища — Elasticsearch. В то же время на рынке есть множество других решений, которые могут хорошо решать задачу хранения и отдачи исторических данных, например, ClickHouse, TimescaleDB, Cassandra.

На митапе мы обсудим опыт внедрения хранилищ, отличных от MySQL и Postgresql, поговорим об их плюсах и минусах, поделимся результатами производительности. 

Трансляция будет на YouTube. Под катом информация о формате и экспертах.
Читать полностью »

Полное руководство по Prometheus в 2019 году - 1

DevOps- и SRE-инженеры уже, наверное, не раз слышали о Prometheus.

Prometheus был создан на SoundCloud в 2012 году и с тех пор стал стандартом для мониторинга систем. У него полностью открытый исходный код, он предоставляет десятки разных экспортеров, с помощью которых можно за считанные минуты настроить мониторинг всей инфраструктуры.

Prometheus обладает очевидной ценностью и уже используется новаторами в отрасли, вроде DigitalOcean или Docker, как часть системы полного мониторинга.

Что такое Prometheus?
Зачем он нужен?
Чем он отличается от других систем?

Если вы совсем ничего не знаете о Prometheus или хотите лучше разобраться в нем, в его экосистеме и всех взаимодействиях, эта статья как раз для вас.

Читать полностью »

Метод CASE: гуманный мониторинг - 1
Дзииииииинь! На часах 3 утра, вы смотрите чудесный сон, и вдруг — звонок. На этой неделе вы дежурите, и, видимо, что-то случилось. Автоматизированная система зовет разобраться, в чем дело. Это важный момент управления современными компьютерными системами, но давайте посмотрим, как сделать уведомления удобнее для людей.

Знакомьтесь с философией мониторинга, родившейся за несколько десятилетий моих дежурств в разных командах по мониторингу. На нее во многом повлияла настоящая библия от Роба Еващука My Philosophy on Alerting (Моя философия уведомлений), включенная в книгу по Google SRE, и книга Джона Олспо Considerations for Alert Design (Замечания по настройке оповещений).

Келли Данн, Ариджит Мукхерьи и Максим Петаццони — спасибо за помощь в редактировании поста.

Что такое CASE?

Я решил придумать красивую аббревиатуру, как у метода USE Брендана Грегга или метода RED Тома Уилки. Я зову это метод CASE. Он описывает четыре момента, на которые нужно обратить внимание при работе с автоматическим мониторингом:

Читать полностью »

Всем привет.

Я — сисадмин linux, переехал из России в Австралию по независимой профессиональной визе в 2015 году, но статья будет не о том, как поросёнку завести трактор. Таких статей уже и так достаточно (тем не менее, если будет интерес — напишу и про это), так что я хотел бы рассказать о том, как на своей работе в Австралии в должности linux-ops-инженера я был инициатором миграции с одной системы мониторинга на другую. Конкретно — Nagios => Icinga2.

Статья частично техническая и частично — про общение с людьми и проблемы, связанные с разницей в культуре и методах работы.

Читать полностью »

У нас было 14 000 объектов, zabbix, api, python и нежелание добавлять объекты руками. Под катом — о том, как сетевиками внедрялся мониторинг с автоматическим добавлением узлов сети, и немного про боль, через которую пришлось пройти.

Статья больше ориентирована на сетевых инженеров с небольшим опытом в python. В помощь при автоматизации мониторинга и улучшения качества жизни и работы, в отсутствии необходимости руками актуализировать весь парк объектов.

Как мы делали мониторинг сети на 14 000 объектов - 1
Читать полностью »

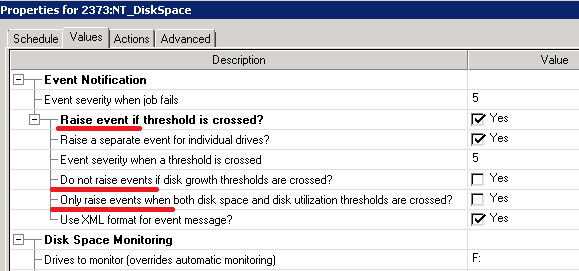
A long time ago in a galaxy far, far away there was a company grown from a startup to something much bigger, but for a while the IT department was still compact and very efficient. That company hosted on prem hundreds of virtual Windows servers, and of course these servers were monitored. Even before I joined the company, NetIQ had been chosen as a monitoring solution.

One of my new tasks was to support NetIQ. The person, who worked with NetIQ before, said a lot about his experience with NetIQ, unfortunately, if I try to put it here it would be just a long line of ‘****’ characters. Soon I realized why. Steve Jobs is probably spinning in his grave looking at the interface like this:

image
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js