Рубрика «python» - 276

Яндекс уже несколько лет сотрудничает с ЦЕРНом. Он сделал для учёных-физиков поиск по событиям в БАК, предоставил свои вычислительные ресурсы и технологии обработки данных — в том числе Матрикснет и ClickHouse. В 2014 году Яндекс стал ассоциированным членом CERN openlab.

Школа анализа данных Яндекса тоже принимает участие в экспериментах ЦЕРНа. Машинное обучение в наши дни становится «микроскопом» для современных учёных, которым необходимо изучать большие объемы данных и находить в них различные закономерности. В этом году ШАД совместно с лабораторией Методов анализа больших данных Вышки и Имперским колледжем Лондона организует в Великобритании международную школу, которая посвящена способам применения современных технологий в научных исследованиях.

Машинное обучение и поиск темной материи: соревнование от ЦЕРНа и Яндекса - 1
Эксперимент OPERA — из Швейцарии в Италию (картинка взята с сайта коллаборации OPERA)

Сегодня в рамках школы начинается открытое соревнование, участники которого будут ни много ни мало искать нейтрино. Принять участие в поисках мы приглашаем всех желающих. Им предстоит обрабатывать данные с международного эксперимента OPERA. Для этого будут предоставлены исходные данные — результаты сканирования слоев фотопленок одного «кирпича» эксперимента OPERA. Соревнование состоит из двух этапов. На первом этапе участники будут искать отдельный ливень в «кирпиче», первая вершина которого известна, на втором — несколько ливней, рассредоточенных по объему «кирпича» без дополнительной информации. Победители смогут рассказать о своих решениях ученым, работающим в ЦЕРНе.
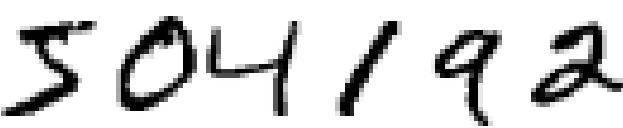
Читать полностью »

Начать стоит от печки, то есть с постановки задачи. Откуда берется сама задача word embedding?
Лирическое отступление: К сожалению, русскоязычное сообщество еще не выработало единого термина для этого понятия, поэтому мы будем использовать англоязычный.
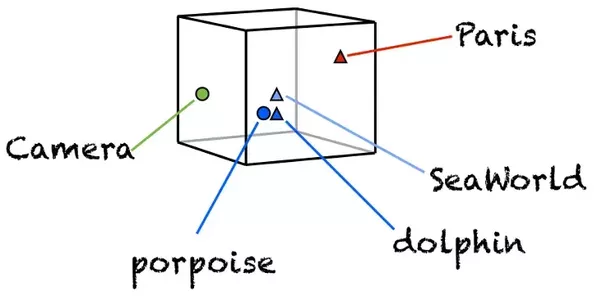
Сам по себе embedding — это сопоставление произвольной сущности (например, узла в графе или кусочка картинки) некоторому вектору.
image

Читать полностью »

Привет! В этой серии статей приведу краткий перевод с английского языка первой главы книги Майкла Нильсона «Neural Networks and Deep Learning».

Перевод я разбил на несколько статей на хабре, чтобы было удобнее читать:
Часть 1) Введение в нейронные сети
Часть 2) Построение и градиентный спуск
Часть 3) Реализация сети для распознавания цифр
Часть 4) Немного о глубоком обучении

Введение

Человеческая визуальная система — одна из самых удивительных на свете. В каждом полушарии нашего мозга есть зрительная кора, содержащая 140 млн. нейронов с десятками млрд. связей между ними, но такая кора не одна, их несколько, и вместе они образуют настоящий суперкомпьютер в нашей голове, лучшим образом адаптированный в ходе эволюции под восприятие визуальной составляющей нашего мира. Но трудность распознавания визуальных образов становится очевидной, если вы попытаетесь написать программу для распознавания, скажем, рукописных цифр.
image
Простую интуицию — «у 9-тки есть петля сверху, и вертикальный хвост внизу» не так просто реализовать алгоритмически. Нейронные сети используют примеры, выводят некоторые правила и учатся на них. Более того чем больше примеров мы покажем сети, тем больше она узнает о рукописных цифрах, следовательно классифицирует их с большей точностью. Мы напишем программу в 74 строчки кода, которая будет определять рукописные цифры с точностью >99%. Итак, поехали!
Читать полностью »

image Всем привет! Это уже тринадцатый выпуск дайджеста на Хабрахабр о новостях из мира Python.

В сегодняшнем выпуске вы найдёте интересные материалы, касающиеся оптимизации Python, его внутренностей, Django, машинного обучения и многого другого. Присылайте свои актуальные материалы, а также любые замечания и предложения, которые будут добавлены в ближайший дайджест.

А теперь к делу!
Читать полностью »

Доброе время суток! В данном посте я хочу рассказать как с помощью инструмента Sparrow лёгко и просто писать собственные обёртки к существующим скриптам и утилитам, а так же зачем вам это может понадобиться.

Читать полностью »

Метод BFGS или один из самых эффективных методов оптимизации. Пример реализации на Python - 1

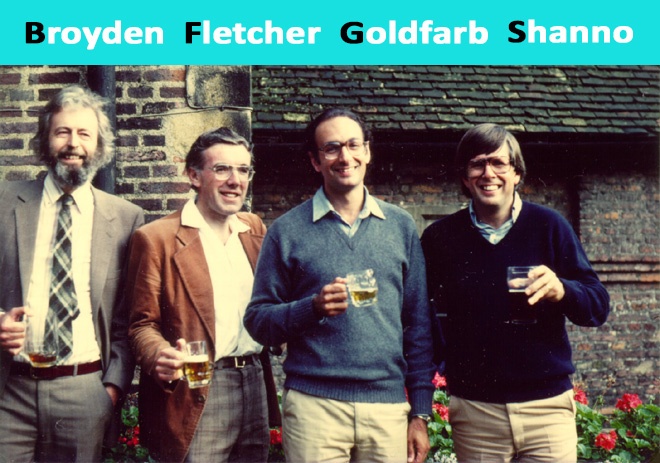
Метод BFGS, итерационный метод численной оптимизации, назван в честь его исследователей: Broyden, Fletcher, Goldfarb, Shanno. Относится к классу так называемых квазиньютоновских методов. В отличие от ньютоновских методов в квазиньютоновских не вычисляется напрямую гессиан функции, т.е. нет необходимости находить частные производные второго порядка. Вместо этого гессиан вычисляется приближенно, исходя из сделанных до этого шагов.

Существует несколько модификаций метода:
L-BFGS (ограниченное использование памяти) — используется в случае большого количества неизвестных.
L-BFGS-B — модификация с ограниченным использованием памяти в многомерном кубе.

Метод эффективен и устойчив, поэтому зачастую применяется в функциях оптимизации. Например в SciPy, популярной библиотеки для языка python, в функции optimize по умолчанию применяется BFGS, L-BFGS-B.

Читать полностью »

«Пока что возможности по полноценной аналитике каналов
ограничены, в первую очередь, возможностями BotAPI Telegram»

канал «Телеграм-маркетинг», 28 июня 2016

Всё хорошо c каналами в Телеграме, кроме одного — их слишком сложно искать. Ссылки есть практически везде,…

Например:

В интернете:

1. С помощью роботов, индексирующих одни каналы в поисках других каналов (1.1, 1.2)
2. В каталогах каналов, пополняемых владельцами каналов (2.1, 2.2)
3. На биржах каналов (3.1, 3.2)
4. В тематических подборках каналов (сюда тоже залетало: 4.1, 4.2)
5. В списках каналов (5.1)
6. В Гугл Доке с каналами о каналах (взял из @raskruti: 6.1)

В мобильном приложении:

7. Скачав приложение с каталогом каналов (под iOS: TeleBots)

В самом Телеграме:

8. На каналах о каналах (8.1)
9. Используя ботов для каналов (9.1)
10. На каналах о каналах о каналах (10.1)

… но процесс поиска остаётся далек от совершенства. Без единого источника данных и нормального аналитического инструментария сложно не просто найти, но даже понять:
1. Насколько каналы распространены в России?
2. Насколько каналы пользуются популярностью и что такое «популярность» в числах?

На такие вопросы нужно отвечать цифрами. В интернете удаётся разыскать только разрозненные данные. Что-то есть на Rusbase (тут), в Ведомостях (тут), в Твиттере (тут), но вся эта информация получена не систематически и сложно верифицируема.

Данная статья посвящена анализу рынка русскоязычных Телеграм-каналов. Проделана работа от сбора обобщенного (не обязательно полного) списка русскоязычных каналов до кроулинга их содержимого и построения метрик. Анализировались только те каналы, которые продвигаются в большом интернете, указывая ссылки на себя. Такое поведение – индикатор каналов, создаваемых для большой аудитории.

Читать полностью »

image
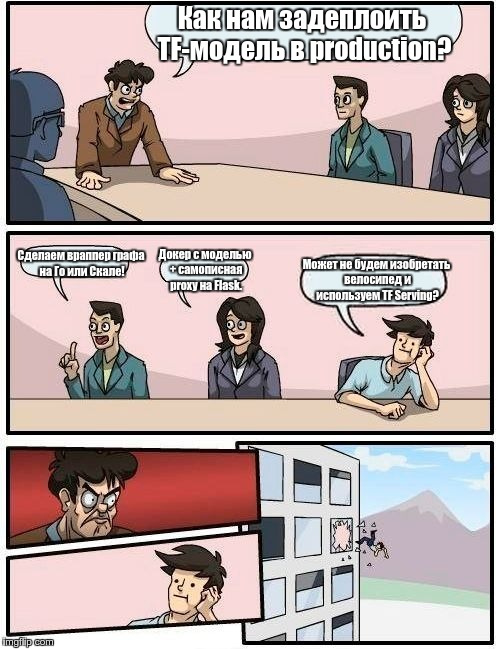
Всегда наступает то самое время, когда обученную модель нужно выпускать в production. Для этого часто приходится писать велосипеды в виде оберток библиотек машинного обучения. Но если Ваша модель реализована на Tensorflow, то у меня для Вас хорошая новость — велосипед писать не придется, т.к. можно использовать Tensorflow Serving.

В данной статье мы рассмотрим как использовать Tensorflow Serving для быстрого создания производительного сервиса по распознаванию изображений.

Читать полностью »

Всем привет!
У нас отличные новости — вышел Upsource 2017.2! В этом релизе мы добавили ряд наиболее часто запрашиваемых возможностей, и, как обычно, улучшили уже имеющуюся функциональность.
Давайте посмотрим, что попало в этот релиз.

Поддержка внешних инспекций кода
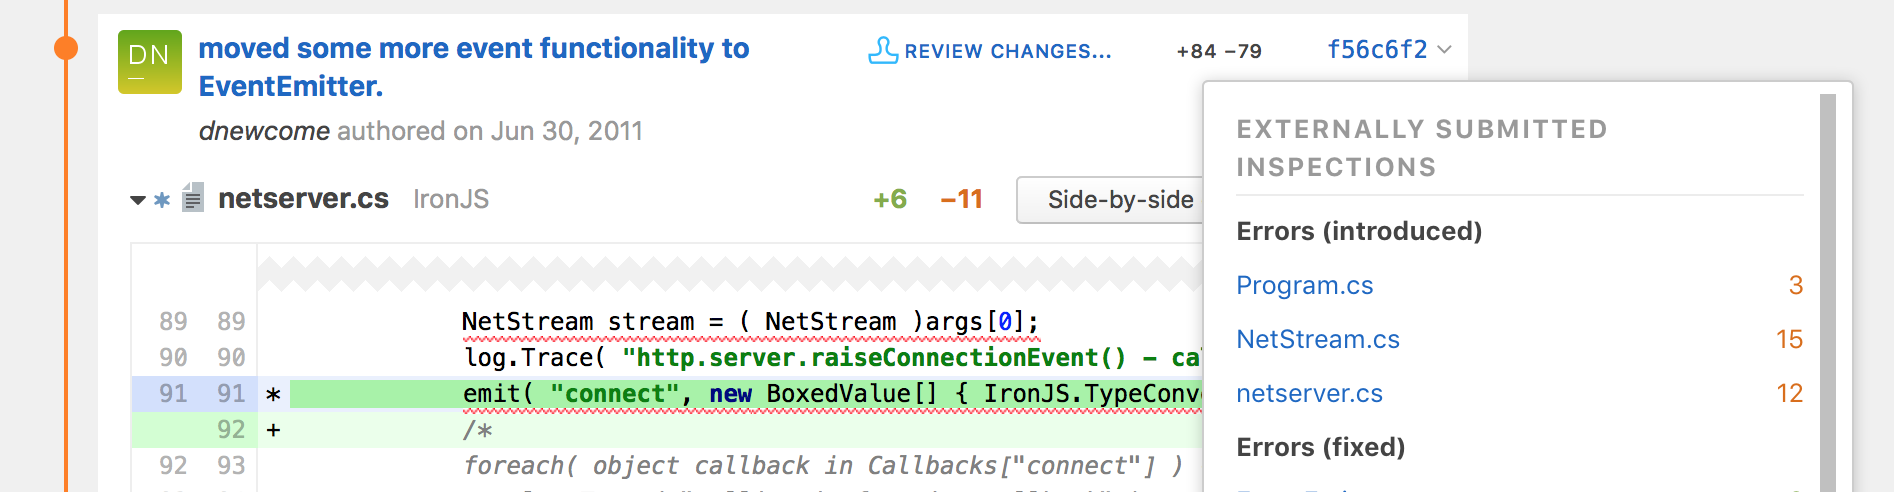
Если Вы используете встроенные в TeamCity инспекции кода на базе ReSharper или IntelliJ IDEA, или пользуетесь инспекциями SonarQube, теперь Вы сможете извлечь из них дополнительную пользу. Upsource 2017.2 умеет показывать результаты такого анализа в своем UI, наряду с результатами встроенных инспекций. Рецензирование кода становится немного проще, если сразу видно, какие новые потенциальные проблемы привнесло именно это изменение.
Инспекции ReSharper в Upsource

Читать полностью »

Как мы упоролись и откалибровали кофе-машину на спектрофотометре - 1
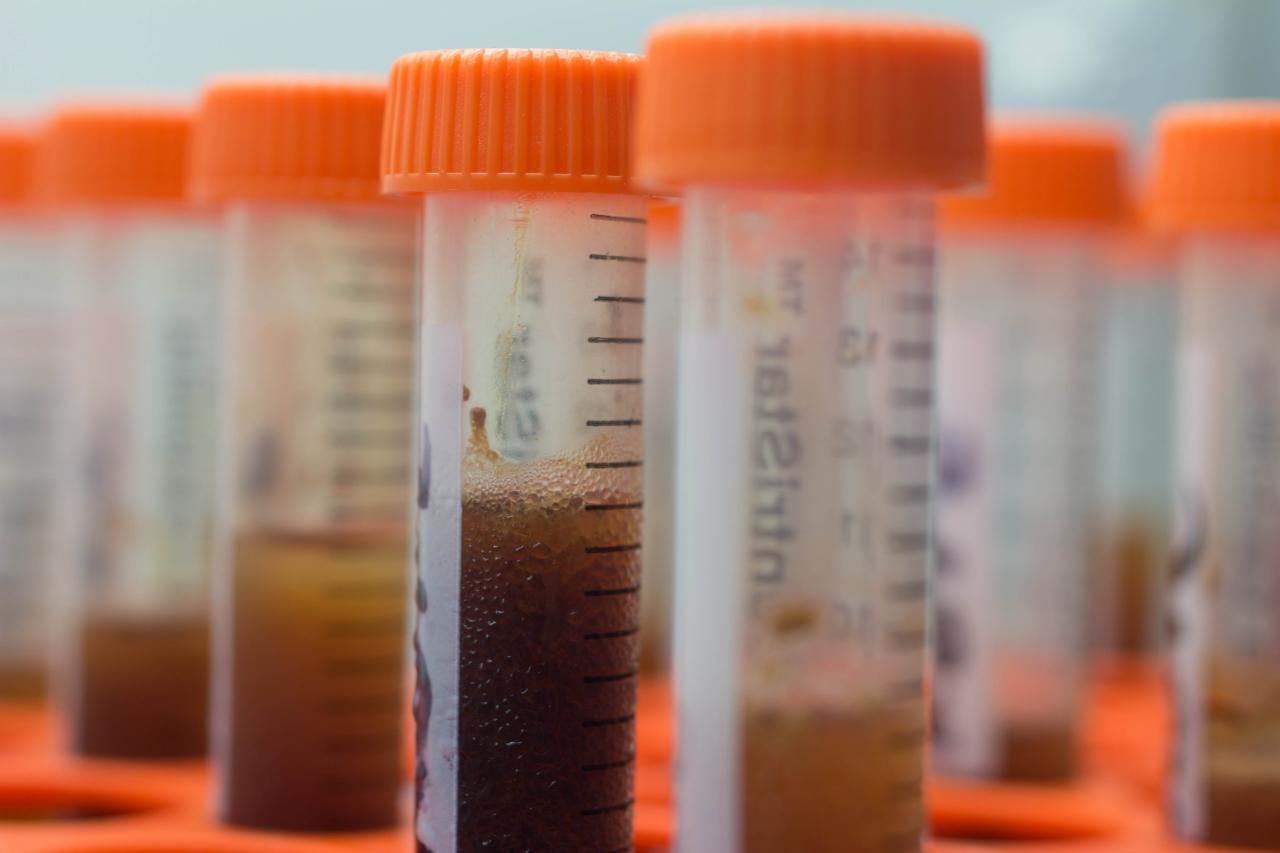
Однажды, посреди рабочего дня мы внезапно осознали, что мы больше не можем так жить. Душа требовала совершить что-то бессмысленное и беспощадное во имя науки. И мы решили откалибровать кофе-машину. Нормальные люди тыкают в дефолтную кнопку и пьют все, что вытечет из кофеварки. Чуть более продвинутые для этого открывают инструкцию и тщательно ей следуют. Может быть еще читают рекомендации обжарщика, если конечно это не прогорклые noname зерна, которые пару лет лежали на безымянном складе. Нас к нормальным можно отнести с большой натяжкой, поэтому мы решили идти своим путем. Короче говоря, под легкой кофеиновой интоксикацией от седьмой чашки эспрессо мы решили задействовать весь возможный арсенал лаборатории, чтобы получить эталонный напиток.
Добро пожаловать в мир безумия, ультрацентрифуг, спектрофотометрии кофе в специальных планшетах и небольшого количества python, pandas и seaborn, чтобы визуализировать все это безобразие.
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js