Рубрика «sql» - 45

PostgreSQL: материализованные представления и FDW - 1

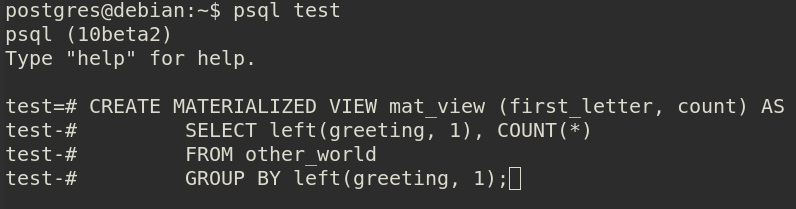
Вы наверняка знаете, что в Postgres есть материализованные представления (materialized views) и обертки сторонних данных (foreign data wrappers, FDW). Материализованные представления позволяют материализовывать запросы и обновлять их по требованию. Обертки сторонних данных предоставляют функциональность загрузки данных из внешних источников, таких как, например, NoSQL-хранилища или другие серверы Postgres.

Вероятно, что вариант использования материализованных представлений совместно с обертками сторонних данных вы еще не рассматривали. Материализованные представления ускоряют доступ к данным: результаты запросов сохраняются и отпадает необходимость выполнять их еще раз. Доступ к сторонним данным через FDW может быть довольно медленным, поскольку они находятся в других системах. Объединив эти функции, можно в итоге получить быстрый доступ к сторонним данным.

Читать полностью »

В прошлой статье мы говорили об истории развития Microsoft Data Protection Manager. Сегодня предлагаем пойти дальше. Вы узнаете о том, как он работает технически, с заглядыванием на страшного зверя VSS.

DPM: Почему он похож на лук? - 1
Читать полностью »

Секционирование PostgreSQL с помощью pg_pathman - 1

Александр Коротков, Дмитрий Иванов (Postgres Professional)

Ведущий: Тяжелая артиллерия в лице Александра и Дмитрия будет рассказывать про важную фичу Postgres. И не то, чтобы фичу, а проблему, с которой сталкиваются люди, работающие с Postgres – это то, как правильно секционировать или партиционировать, как вам более удобно произносить, таблицы. И Александр с Дмитрием уже довольно длительное время трудятся над расширением, которое позволяет это делать гибко, хорошо, удобно и быстро.

Александр Коротков: Как правильно уже сказали, наш доклад будет посвящен расширению pg_pathman, которое реализует продвинутое секционирование в Postgres. Основную часть доклада будет рассказывать мой коллега Дмитрий Иванов, который сейчас очень активно включился в работу над расширением pg_pathman, а я буду время от времени что-то добавлять.
Читать полностью »

Планировщик заданий (scheduler) не во все времена считался обязательным инструментом в мире баз данных. Все зависело от назначения и происхождения СУБД. Классические коммерческие СУБД (Oracle, DB2, MS SQL) представить себе без планировщика решительно невозможно. С другой стороны, трудно вообразить потенциального пользователя MongoDB, который откажется от выбора этой модной NoSQL-СУБД из-за отсутствия планировщика. (Кстати, термин «планировщик заданий» в русском контексте СУБД употребляют, чтобы отличить его от планировщика запросов — query planner, мы же для краткости будем звать его здесь планировщиком).

PostgreSQL, будучи Open Source и впитав традиции сообщества с образом жизни DIY («сделай сам»), в наше время регулярно претендует на место как минимум заместителя коммерческой СУБД. Из этого автоматически следует, что PostgreSQL просто обязана иметь планировщик, и что этот планировщик должен быть удобен для администратора базы и для пользователя. Читать полностью »

Система мониторинга PERFEXPERT — решение проблем производительности СУБД - 1Специализированный программный комплекс «PERFEXPERT» – самостоятельный программный продукт, позволяющий без вмешательства в работу баз данных и обслуживающих их программ в режиме реального времени собирать, протоколировать и визуально отображать сведения о нагрузке на систему баз данных MS SQL, оценивать эффективность их работы и выявлять причины низкой производительности.
В начале лета разработчик этого программного продукта компания SOFTPOINT и производитель серверного оборудования компания STSS запустили акцию: при покупке любого сервера или СХД
клиент получает Сертификат на бесплатное тестирование ПО диагностики СУБД PERFEXPERT сроком на 3 месяца. Акция продлится до конца лета.
Учитывая положительный результат акции, мы решили расширить круг её охвата. С сегодняшнего дня, в течение 3 месяцев, любой читатель этой статьи получает 2 недели тестирования PERFEXPERT в своей инфраструктуре СУБД.
Читать полностью »

Привет! Продолжаем серию постов о новых версиях IDE от JetBrains. Поговорим о том, что нового в DataGrip 2017.2.

— Поддержка Amazon Redshift и Microsoft Azure
— Несколько баз данных для одного источника PostgreSQL
— Контроль транзакций
— Вычисление выражений
— Разделены вкладки DDL и Data для таблиц
— Интеграция с инструментами восстановления для PostgreSQL и MySQL
— Улучшения, связанные с запуском запросов
— Улучшения, связанные с написанием кода
и другое…

DataGrip 2017.2: Поддержка Redshift и Azure, несколько баз в PostgreSQL, контроль транзакций и другое - 1

Читать полностью »

WI-FI в метро: Поймай меня, если сможешь. Сложности конфигурирования динамических сетей - 1

Когда Wi-Fi только появился на первых линиях метро, мы поняли, что превращаемся в героя Билла Мюррея из «Дня сурка». С той лишь разницей, что он каждый раз просыпался 2 февраля, а мы неделями пытались поймать поезда хотя бы одной ветки и залить на них одну и ту же конфигурацию. Настраивать ее вручную было плохой идеей — поезда уходили в депо и стояли там несколько дней.

Читать полностью »

В прошлые разы мы рассмотрели механизм индексирования PostgreSQL, интерфейс методов доступа, и два метода: хеш-индекс и B-дерево. В этой части займемся индексами GiST.

GiST

GiST — сокращение от «generalized search tree». Это сбалансированное дерево поиска, точно так же, как и рассмотренный ранее b-tree.

В чем же разница? Индекс b-tree жестко привязан к семантике сравнения: поддержка операторов «больше», «меньше», «равно» — это все, на что он способен (зато способен очень хорошо!). Но в современных базах хранятся и такие типы данных, для которых эти операторы просто не имеют смысла: геоданные, текстовые документы, картинки…

Тут на помощь и приходит индексный метод GiST. Он позволяет задать принцип распределения данных произвольного типа по сбалансированному дереву, и метод использования этого представления для доступа по некоторому оператору. Например, в GiST-индекс можно «уложить» R-дерево для пространственных данных с поддержкой операторов взаимного расположения (находится слева, справа; содержит и т. п.), или RD-дерево для множеств с поддержкой операторов пересечения или вхождения.

За счет расширяемости в PostgreSQL вполне можно создать совершенно новый метод доступа с нуля: для этого надо реализовать интерфейс с механизмом индексирования. Но это требует продумывания не только логики индексации, но и страничной структуры, эффективной реализации блокировок, поддержки журнала упреждающей записи — что подразумевает очень высокую квалификацию разработчика и большую трудоемкость. GiST упрощает задачу, беря на себя низкоуровневые проблемы и предоставляя свой собственный интерфейс: несколько функций, относящихся не к технической сфере, а к прикладной области. В этом смысле можно говорить о том, что GiST является каркасом для построения новых методов доступа.
Читать полностью »

VAX — инструмент для визуального программирования, или как написать SQL мышкой - 1

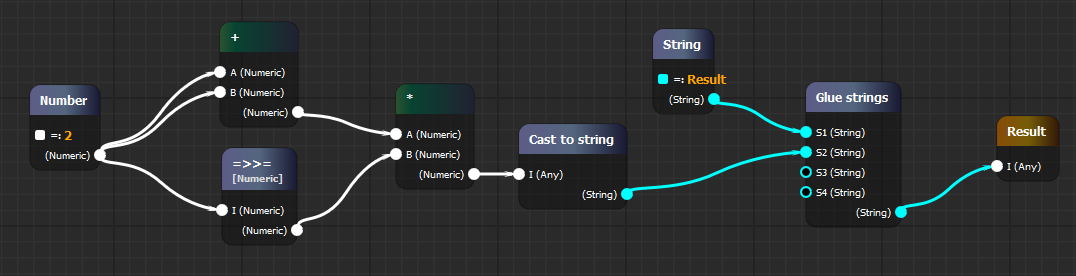
Я хочу рассказать про созданный мною web редактор для «визуального программирования» и его историю создания.
Читать полностью »

Работа с Liquibase всегда приносит уверенность в том, что объекты БД находятся в том состоянии, в котором ты этого хочешь. Именно эта уверенность и делает системы миграций баз данных столь популярными.

Сегодня я хочу вам рассказать, как сделать работу с liquibase немного удобнее. Если вы пишите миграции вручную, а вашей целевой базой данных является PostgreSQL, то прочитайте эту статью, уверен, время потраченное на чтение статьи окупится с лихвой.

Логотип Liquibase и pgCodeKeeper

Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js