
Перевод руководства по рекуррентным нейросетям с сайта Tensorflow.org. В материале рассматриваются как встроенные возможности Keras/Tensorflow 2.0 по быстрому построению сеток, так и возможности кастомизации слоев и ячеек. Также рассматриваются случаи и ограничения использования ядра CuDNN позволяющего ускорить процесс обучения нейросети.
Рубрика «big data» - 19
Рекуррентные нейронные сети (RNN) с Keras
2020-02-11 в 17:07, admin, рубрики: big data, keras, LSTM, python, TensorFlow, искусственный интеллект, машинное обучение, рекуррентная нейронная сеть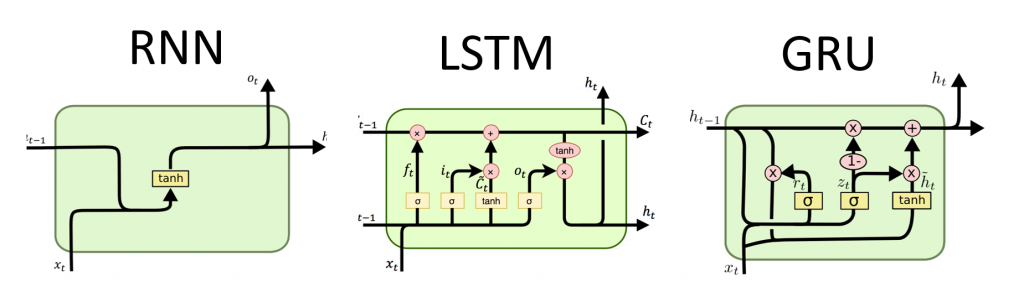
Ким Дотком: пойманный в сеть, самый разыскиваемый человек онлайн. Часть 3
2020-02-11 в 12:22, admin, рубрики: big data, clickhouse, elasticsearch, LSD, MergeTree, Блог компании ua-hosting.company, Законодательство в IT, информационная безопасность, СУБД, хостингДля одних Ким Дотком, основатель скандально известного файлообменника «MegaUpload», преступник и интернет-пират, для других — несгибаемый борец за неприкосновенность персональных данных. 12 марта 2017 года состоялась мировая премьера документальной киноленты, в которой приведены интервью с политиками, журналистами и музыкантами, знающими Кима «со всех сторон». Новозеландский режиссер Энни Голдсон с помощью видео из личных архивов рассказывает о сути судебных баталий Доткома с правительством США и другими государственными структурами, провозгласившими бой мировому интернет-пиратству.
В юности Ким Дотком считал США оплотом мировой демократии, страной, правительство которой самоотверженно борется за торжество справедливости во всем мире. Побывав в ролях хакера, малолетнего преступника и консультанта по компьютерной безопасности, к 30-ти годам Ким решает заняться бизнесом и создает крупнейший файлообменник «MegaUpload», число пользователей которого достигло 160 млн. человек. Практически до самого закрытия сайта в 2012 году он занимал 13 место в рейтинге самых посещаемых интернет-ресурсов. За 7 лет существования «MegaUpload» Ким заработал более сотни миллионов долларов, но в результате судебных разбирательств превратился в банкрота. Инициатором судебного преследования выступили США, обвинившие Доткома в размещении пиратского контента и нарушении авторских прав, что будто бы принесло правообладателям ущерб в размере 500 млн. долларов.
До сих пор Киму так и не удалось оправиться от удара и поправить финансовые дела, так как все средства он тратит на услуги адвокатов и создание новых инновационных проектов, таких как платформа «K.im» — так называемый «магазин файлов», совершающий платежи на основе криптовалюты.
В статье рассказывается о сюжете фильма «Пойманный в сеть», а также приводятся выдержки из других публицистических материалов, недоступных русскоязычному читателю.Читать полностью »
«Да, они существуют!» Чем занимаются и сколько зарабатывают Data Science-специалисты в Казахстане?
2020-02-10 в 14:06, admin, рубрики: big data, data engineering, data science, kolesa group, machine learning, зарплаты, исследование, Казахстан, Карьера в IT-индустрииДмитрий Казаков, Data Analytics Team Lead в Kolesa Group, делится инсайтами из первого казахстанского опроса специалистов по работе с данными.
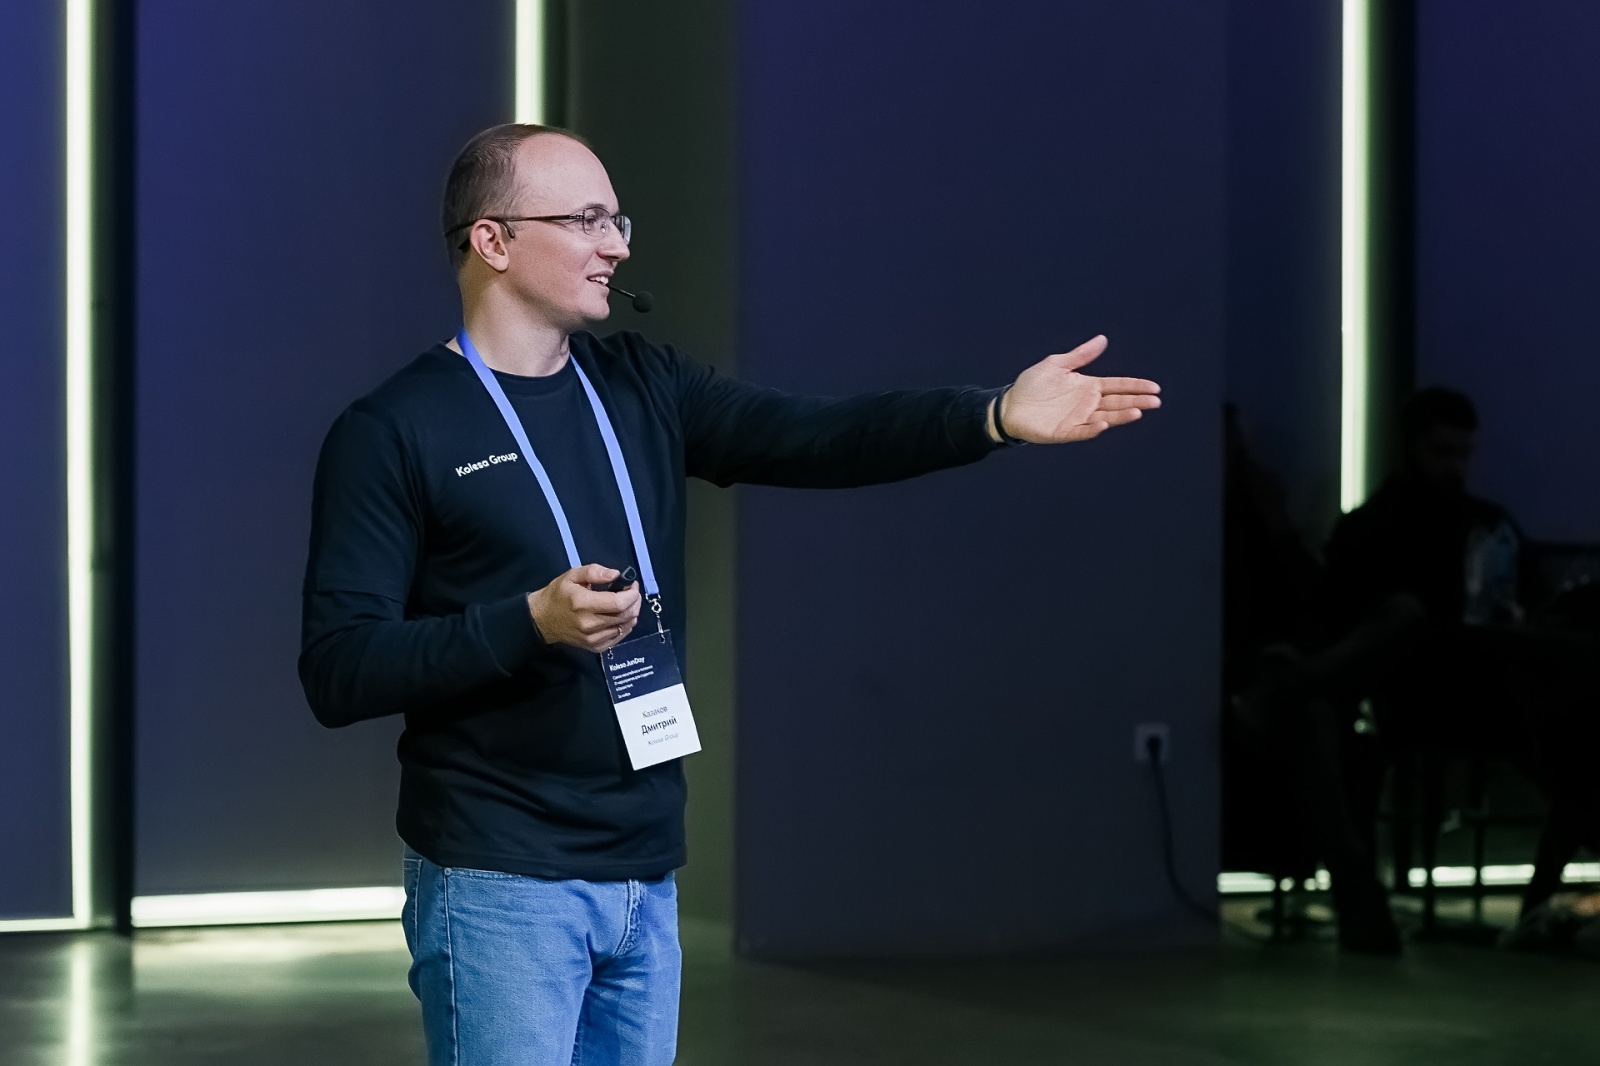
На фото: Дмитрий Казаков
Помните популярную фразу о том, что Big Data больше всего напоминает подростковый секс – все о нем говорят, но никто не знает, есть ли он на самом деле. То же самое можно было сказать и о рынке специалистов по работе с данными (в Казахстане) – хайп есть, а кто за ним стоит (и есть ли там вообще хоть кто-то), не было до конца понятно – ни эйчарам, ни менеджерам, ни самим дата-сайентистам.
Мы провели исследование, в рамках которого опросили более 300 специалистов об их зарплатах, функциях, скиллах, инструментах и много еще о чем.
Спойлер: да, они точно существуют, но все не так однозначно.
Приятный инсайт. Во-первых, специалистов по работе с данными больше чем мы ожидали. Нам удалось опросить 300 человек, среди которых есть не только product-, marketing- и BI-аналитики, но и ML-, DWH-инженеры, что особенно порадовало. В самой большой группе оказались все те, кто называет себя дата-сайентистами – это 36% опрошенных. Покрывает это запрос рынка или нет, сказать сложно, потому что сам рынок только формируется. Читать полностью »
HighLoad++, Михаил Тюленев (MongoDB): Causal consistency: от теории к практике
2020-02-09 в 14:23, admin, рубрики: big data, clock synchronization, dependency tracking, Hybrid Clock, Lamport Clock, logical clocks, mongodb, Spanner TrueTime, system security, Vector Clock, Блог компании ua-hosting.company, конференцииСледующая конференция HighLoad++ пройдет 6 и 7 апреля 2020 года в Санкт-Петербурге.
Подробности и билеты по ссылке. HighLoad++ Siberia 2019. Зал «Красноярск». 25 июня, 12:00. Тезисы и презентация.
Бывает, что практические требования конфликтуют с теорией, где не учтены важные для коммерческого продукта аспекты. В этом докладе представлен процесс выбора и комбинирования различных подходов к созданию компонентов Causal consistency на основе академических исследований исходя из требований коммерческого продукта. Слушатели узнают о существующих теоретических подходах к logical clocks, dependency tracking, system security, clock synchronization, и почему MongoDB остановились на тех или иных решениях.Читать полностью »
Анализ рынка недвижимости на основе данных с msgr.ru
2020-02-08 в 15:35, admin, рубрики: big data, data mining, python, scrapy, аналитика, визуализация данных, Исследования и прогнозы в IT, недвижимость, недвижимость и ценыНедавно столкнулся с проблемой выбора квартиры и конечно первым делом решил узнать, что происходит на рынке недвижимости и, как это обычно бывает, половина экспертов с youtube.com говорят, что недвижимость будет расти, другая утверждает, что наоборот цена будет падать. В итоге решил разобраться сам, и вот, что из этого вышло.
HighLoad++, Анастасия Цымбалюк, Станислав Целовальников (Сбербанк): как мы стали MDA
2020-02-08 в 12:17, admin, рубрики: big data, SberData, Блог компании ua-hosting.companyСледующая конференция HighLoad++ пройдет 6 и 7 апреля 2020 года в Санкт-Петербурге
Подробности и билеты по ссылке. HighLoad++ Siberia 2019. Зал «Красноярск». 25 июня, 14:00. Тезисы и презентация.
Разработать промышленную систему управления и распространения данных с нуля — нелегкая задача. Тем более, когда полный бэклог, времени на работу — квартал, а требования к продукту — вечная турбулентность.
Мы расскажем на примере построения системы управления метаданными, как за короткий промежуток времени выстроить промышленную масштабируемую систему, которая включает в себя хранение и распространение данных.
Наш подход использует все преимущества метаданных, динамического кода SQL и кодогенерации на основе Swagger codegen и handlebars. Это решение сокращает время разработки и переконфигурации системы, а добавление новых объектов управления не требует ни единой строки нового кода.
Мы расскажем, как это работает в нашей команде: каких правил придерживаемся, какие инструменты используем, с какими трудностями столкнулись и как их героически преодолели.Читать полностью »
Delta: Платформа синхронизации данных и обогащения
2020-02-07 в 15:41, admin, рубрики: big data, Change Data Capture, data engineering, Data Synchronization, Event Driven Systems, stream processing, Блог компании OTUS. Онлайн-образованиеВ преддверии запуска нового потока по курсу «Data Engineer» подготовили перевод интересного материала.
Обзор
Мы поговорим о достаточно популярном паттерне, с помощью которого приложения используют несколько хранилищ данных, где каждое хранилище используется под свои цели, например, для хранения канонической формы данных (MySQL и т.д.), обеспечения расширенных возможностей поиска (ElasticSearch и т.д.), кэширования (Memcached и т.д.) и других. Обычно при использовании нескольких хранилищ данных одно из них работает как основное хранилище, а другие как производные хранилища. Единственная проблема заключается в том, как синхронизировать эти хранилища данных.
Мы рассмотрели ряд различных паттернов, которые пытались решить проблему синхронизации нескольких хранилищ, таких как двойная запись, распределенные транзакции и т.д. Однако эти подходы имеют существенные ограничения в плане использования в реальной жизни, надежности и технического обслуживания. Помимо синхронизации данных, некоторым приложениям также необходимо обогащать данные, вызывая внешние сервисы.Читать полностью »
Обучение и оценка модели с Keras
2020-02-04 в 11:42, admin, рубрики: big data, python, TensorFlow, искусственный интеллект, машинное обучение, обучение модели
Это руководство охватывает обучение, оценку и прогнозирование (выводы) моделей в TensorFlow 2.0 в двух общих ситуациях:
- При использовании встроенных API для обучения и валидации (таких как
model.fit(),model.evaluate(),model.predict()). Этому посвящен раздел «Использование встроенных циклов обучения и оценки» - При написании кастомных циклов с нуля с использованием eager execution и объекта
GradientTape. Эти вопросы рассматриваются в разделе «Написание собственных циклов обучения и оценки с нуля».
В целом, независимо от того, используете ли вы встроенные циклы или пишете свои собственные, обучение и оценка моделей работает строго одинаково для всех видов моделей Keras: Sequential моделей, созданных с помощью Functional API, и написанных с нуля с использованием субклассирования.
Читать полностью »
Ищем цепочку событий в потоке данных с помощью FlinkCEP
2020-02-01 в 19:42, admin, рубрики: Apache, big data, BigData, CEP, Flink, FlinkCep, java, pattern, scalaВ данной статье речь пойдет об использовании открытой платформы Apache Flink для обнаружения цепочки последовательности событий. Статья подойдет как для начинающих разработчиков в области обработки потоковых данных, так и для тех, кто желает познакомиться с Apache Flink.
Ни для кого не секрет, что на данный момент существуют различные подходы к обработке, хранению, фильтрации и анализу больших данных. В отдельный класс можно выделить системы, построенные на событийной архитектуре (Event-Driven Architecture). Данные системы призваны решать различные задачи, в том числе в режимах близких к реальному времени. Одной из таких задач является обнаружение (детектирование, идентификация) сложных цепочек связанных событий на больших входных потоках данных (FlinkCEP — Pattern Detection). Обычно, данная задача, решается системами комплексной обработки событий (CEP), которые должны обрабатывать сотни, а порой и тысячи определенных пользователем шаблонов на входном потоке данных в поисках определенного события, аномалий, системах мошенничества и даже предсказании будущего на основе текущих событий. В статье речь пойдет о библиотеке FlinkCep Apache Flink, которая позволяет решать подобные проблемы.
Читать полностью »
[кейс Locomizer] Какие знания можно на самом деле извлечь из анонимизированного датасета с координатами пользователей
2020-01-25 в 20:11, admin, рубрики: assisted gps, big data, data engineering, gis, gps, location based services, POI, point of interest, Алгоритмы, бизнес-кейс, большой брат следит за тобой, Геоинформационные сервисы, Глобальные системы позиционирования, информационная безопасность, кейс по проекту, ликбез, приватность это миф, эвристические алгоритмыДанная статья является частью серии «Кейс Locomizer», см. также
• Как мы за два года ускорили расчёт тепловой карты в 20000 раз (послезавтра)
• Открываем One Ring — инструментарий для гибкой конфигурации сложных процессов обработки данных на Spark в облаке (скоро)
Здравствуйте.
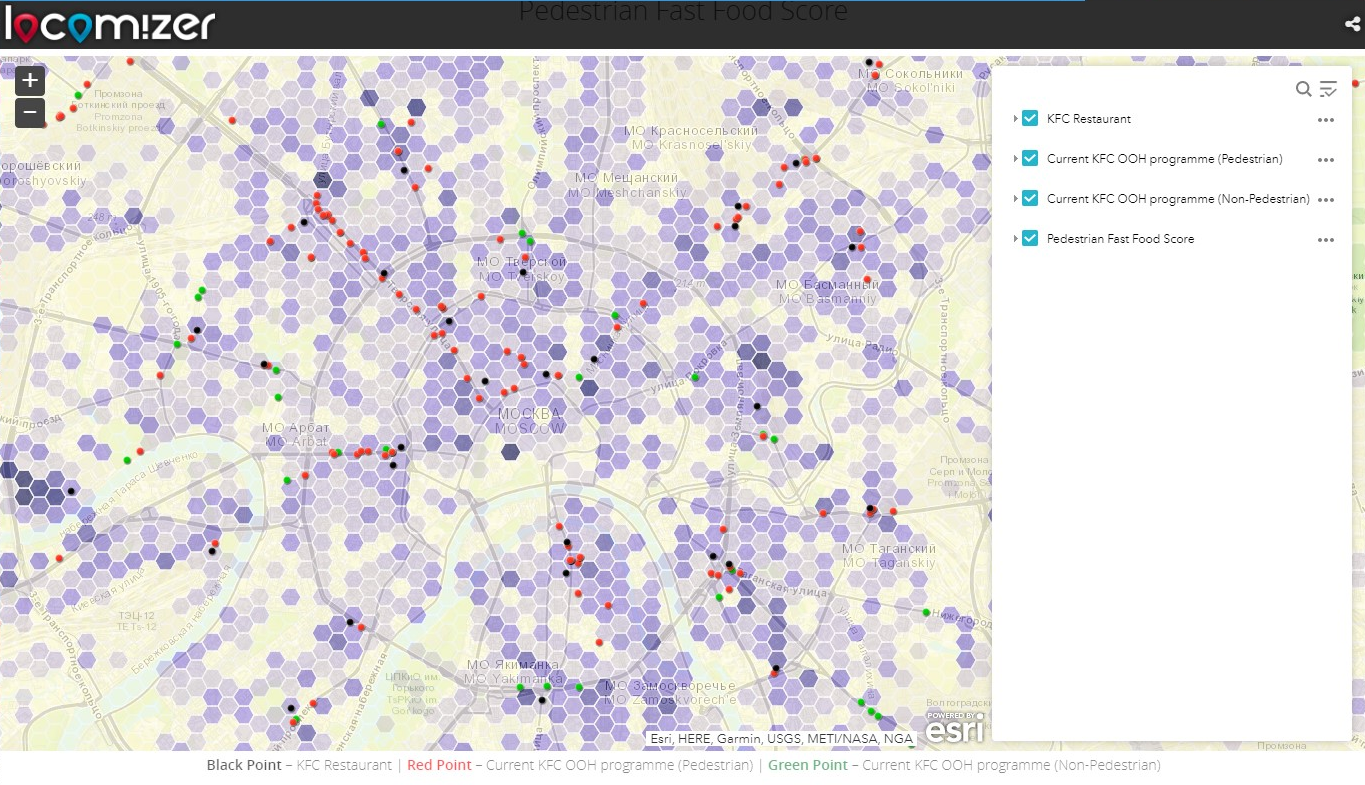
Недавно издание The New York Times опубликовало претендующую на сенсационность статью о том, как отследить пользователей по коммерчески доступным анонимизированным датасетам с координатами их перемещений, и здесь, на Хабре её вольный перевод с дополнениями от неизвестного корпоративного копирайтера собрал большое количество комментариев разной степени обеспокоенности.
Так получилось, что я последние два с половиной года являюсь техническим лидом на геоинформационном проекте, который занимается задачей непосредственного извлечения знаний именно из таких коммерческих датасетов. Но мои комментарии с просьбой отставить панику собрали большое количество минусов. Что ж. В поговорке про отсутствие паранойи и не факт, что за вами не следят, есть некая доля истины.
Но есть и доля истины по ту сторону чёрного зеркала, возможно, куда большая. Или интересная.
Читать полностью »