Рубрика «big data» - 18

В 2021 году школьники начнут проходить искусственный интеллект, узнали СМИ из проекта дорожной карты развития ИИ в России. К 2024 году он будет включен в программы в половине школ. С 2021 года ежегодно будет проводиться всероссийская олимпиада по ИИ, дающая преференции победителям при поступлении в вузы.

Карту разработали Сбербанк и РФПИ (Российский фонд прямых инвестиций). Она также предусматриваетЧитать полностью »

29 февраля в «Цифровом деловом пространстве» (ЦДП, Москва, улица Покровка 47) состоится конференция X5 Retail Hero, посвященная Data Science и разработке в сфере ритейла. Участие бесплатное, необходима предварительная регистрация.

Конференция приурочена к финалу одноименного соревнования X5 Retail Group. Между выступлениями экспертов организаторы объявят победителей, представивших лучшие решения для цифровизации розничной торговли.

29 февраля в ЦДП состоится X5 RetailHero: как попасть на первую конференцию Х5 по Data Science и разработке - 1
Читать полностью »

Здравствуйте.

Сегодня мы предлагаем вашему вниманию перевод статьи из блога MemSQL, которая исходно является рекламной (посвящена достоинствам MemSQL, обновлена по состоянию на начало января 2020 года). Но мы решили все-таки перевести ее в сокращенном виде, поскольку она подробно объясняет, почему мы пока так и не собрались издавать ничего ни по MongoDB, ни по Cassandra, ни по прочим нереляционным базам данных. Может быть, мы были правы, ограничившись весьма успешной книгой "MySQL по максимуму".
Читать полностью »

«Яндекс», «Ростелеком» и Mail.ru выступили против законопроекта Минкомсвязи о регулировании Big Data в РФ - 1

Вчера стало известно о том, что Российская Ассоциация больших данных не согласилась с положениями законопроекта Минкомсвязи о регулировании больших данных. Документ был предложен ведомством в феврале этого года. Представители Ассоциации утверждают, что новый законопроект противоречит Конституции, а именно — нарушает прописанные в ней свободы экономической деятельности и распространения информации.

Кроме того, участники рынка считают, что этот документ повлечет за собой снижение темпов развития технологий ИИ в стране.
Читать полностью »

В части первой описывалось, что данная публикация сделана на основе датасета результатов кадастровой оценки объектов недвижимости в Ханты-Мансийском АО.

Практическая часть представлена в виде шагов. Проводилась вся очистка в Excel, так как самый распространенный инструмент и описанные операции может повторить большинство специалистов знающих Excel. И достаточно неплохо подходит для работы в «рукопашную».

Нулевым этапом поставлю работы по запуску, сохранению файла, так как он размером 100 мб, то при количестве этих операций десятки и сотни на них уходит существенное время.
Открытие, в среднем, — 30 сек.
Сохранение – 22 сек.

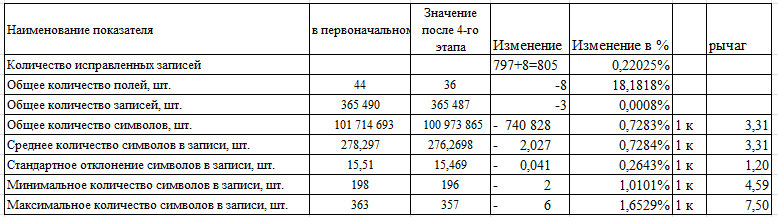
Первый этап начинается с определения статистических показателей датасета.

Таблица 1. Статпоказатели датасета
Очистка данных, как игра «Камень, Ножницы, Бумага». Это игра с финишем или без? Часть 2. Практическая - 1
Читать полностью »

Коллектив из бывших инженеров АНБ США и Amazon создает «GitHub для данных» - 1

Около полугода назад у нескольких инженеров и разработчиков с опытом работы в Агентстве национальной безопасности США, Google и Amazon Web Services появилась любопытная идея.

Для создания новых функций и изобретения чего-то нового разработчикам и инженерам нужны данные. Но эти данные часто конфиденциальны и недоступны — из-за бюрократии и разного рода нормативных требований, — и чтобы получить одобрение на их использование, может понадобиться несколько недель. Поэтому недавно был запущен проект Gretel — стартап, цель которого — помочь разработчикам безопасно обмениваться конфиденциальными данными и совместно взаимодействовать с ними в режиме реального времени.

Алекс Уотсон, один из сооснователей проекта, говорит о предназначении новой платформы так: «Это не такая нишевая задача, как может показаться. Разработчики любой компании могут столкнуться с этой проблемой». Зачастую разработчикам нужен не полный доступ к банку пользовательских данных, а лишь фрагмент или выборка для работы. Во многих случаях достаточно будет данных, которые просто выглядят как реальные пользовательские данные.

Читать полностью »

Создать мощный курс Machine Learning: миссия выполнена - 1


У нас было 2 неудачных запуска, 169 студентов, 8 сердитых отзывов, 3 смены названий, слишком много теории и мало реальной практики. Не то чтобы это было полным провалом, но если начал обучать Data Science, надо сделать это идеально. Сегодня вы услышите историю о том, как мы развивали в OTUS направление анализа данных и какие на этом пути допустили, а потом исправили ошибки.


Читать полностью »

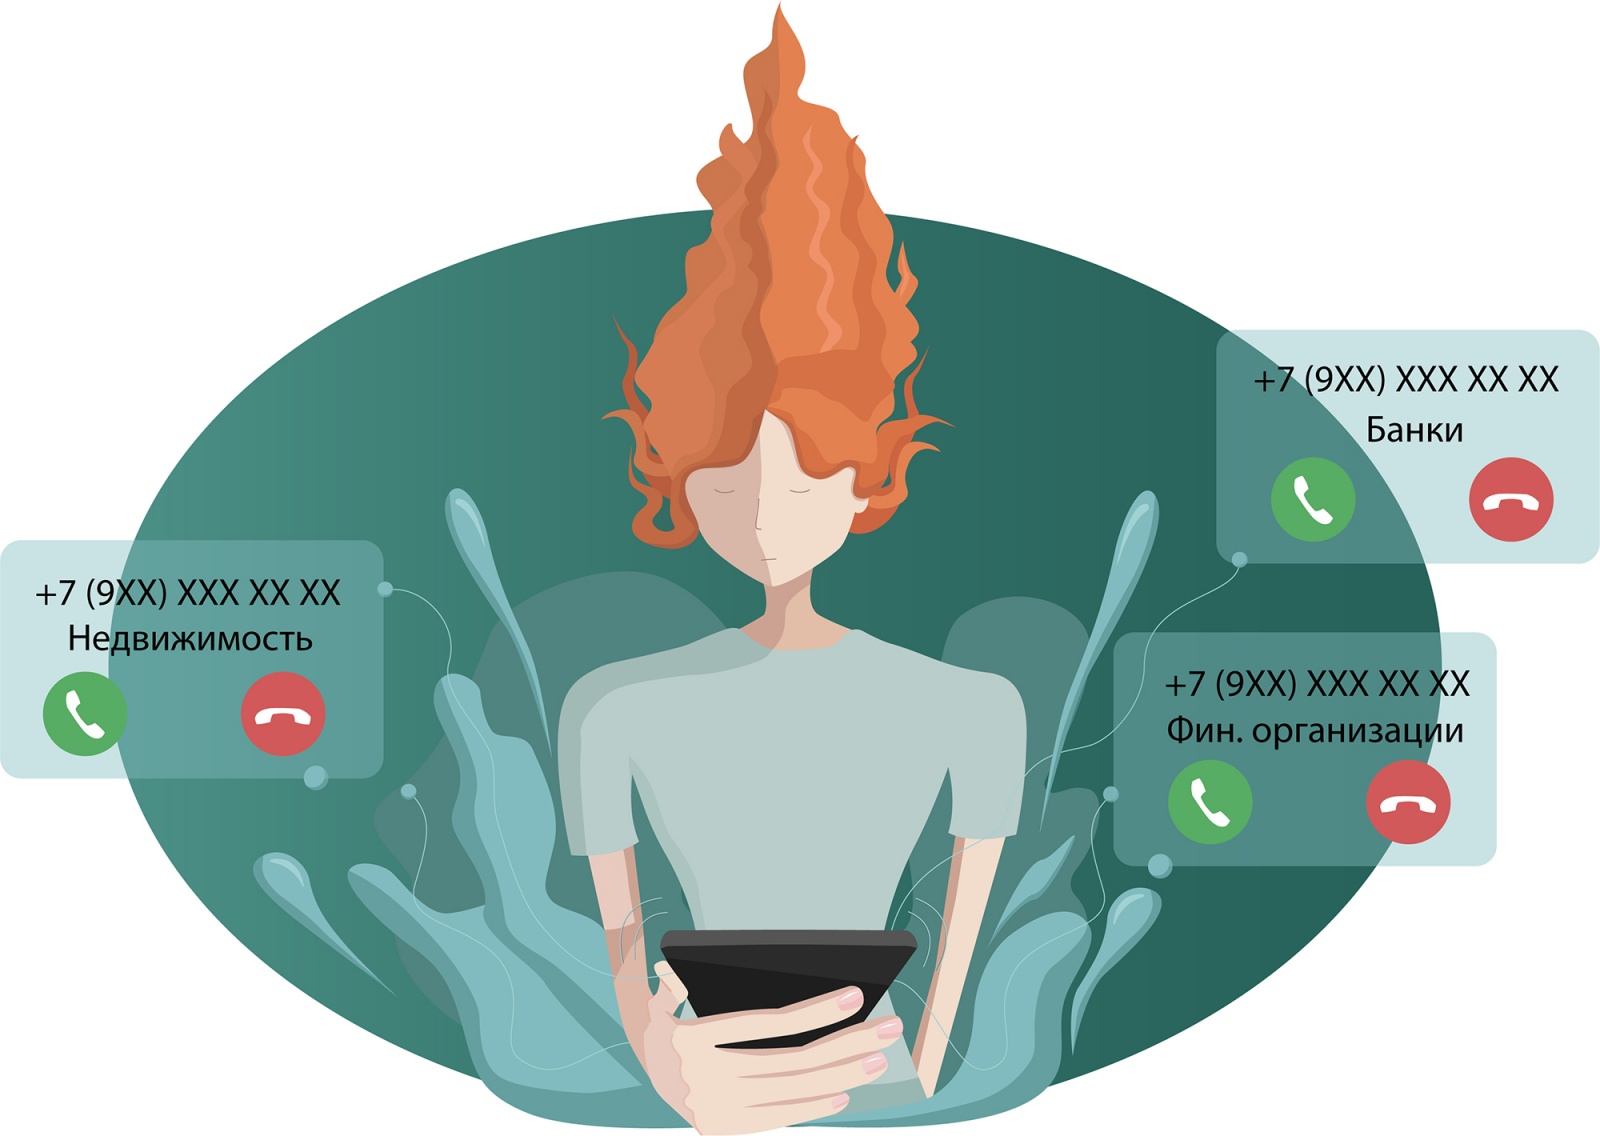
Каждый активный абонент в среднем получает более четырех нежелательных звонков в неделю — это реклама, предложения банков, иногда просто мошенничество. Большинство клиентов негативно реагируют на такого рода звонки. Для решения этой проблемы мы разработали услугу “Блокировка спам-звонков”, подключив которую, пользователь перестает получать нежелательные звонки, а в конце каждого дня система оповещает абонента о вызовах, которые были заблокированы. В этой статье data scientist’ы МТС Анна Рожкова (@RogotulkA) и Ольга Герасимова(@ynonaolga) расскажут как разработали алгоритм, отличающий номера спамеров от остальной абонентской базы.

Спам, спам, спам… - 1

Читать полностью »

Мифы о больших данных и цифровая культура - 1

Мы продолжаем публиковать самые интересные доклады RAIF, ежегодного форума по искусственному интеллекту, организованному «Инфосистемы Джет». Сегодня хотим поделиться рассказом доктора физико-математических наук, профессора департамента информатики НИУ ВШЭ Бориса Асеновича Новикова.
Читать полностью »

Следующая конференция HighLoad++ пройдет 6 и 7 апреля 2020 года в Санкт-Петербурге. Подробности и билеты по ссылке. HighLoad++ Moscow 2018. Зал «Дели + Калькутта». 8 ноября, 14:00. Тезисы и презентация.

HighLoad++, Михаил Райченко (ManyChat): почти без магии, или как просто раздать терабит видеопотока - 1

Я работаю в команде «ВКонтакте» и занимаюсь разработкой системы видеотрансляций.
В докладе поделюсь особенностями разработки бэкенда, тем, как эволюционировала наша система, и техническими решениями, к которым мы пришли:


  • как мы делали бэкенд видеотрансляций, и процесс эволюции как он есть;
  • влияние бизнес-требований и требований эксплуатации на архитектуру;
  • «подождать» и «попробовать ещё раз» не получится;
  • как самые простые задачи усложняются количеством пользователей;
  • как уменьшить задержку без UDP;
  • проводим стресс-тесты 2 раза в день, или в чем нам помог «Клевер».

Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js