Рубрика «deep learning» - 7

Когда еще один плодотворный год подходит к концу, хочется оглянуться назад, подвести итоги и показать, что мы смогли сделать за это время. Библиотеке #DeepPavlov, на минуточку, уже два года, и мы рады, что наше сообщество с каждым днем растет.

За год работы над библиотекой мы достигли:

  • Скачивания библиотеки возросли на треть по сравнению с прошлым годом. Сейчас у DeepPavlov более 100 тысяч установок и более 10 тысяч установок контейнеров.
  • Увеличилось количество коммерческих решений за счет state-of-art технологий, реализованных в DeepPavlov, в разных отраслях от ритейла до промышленности.
  • Вышел первый релиз DeepPavlov Agent.
  • Количество активных участников сообщества возросло в 5 раз.
  • Наша команда студентов и аспирантов была отобрана для участия в Alexa Prize Socialbot Grand Challenge 3.
  • Библиотека стала призером конкурса от компании Google «Powered by TensorFlow Challenge».

Что же помогло достичь таких результатов и почему DeepPavlov — это лучший открытый источник для построения разговорного AI? Расскажем в нашей статье.
Прорывы #DeepPavlov в 2019 году: обзор и итоги года - 1
Читать полностью »

Всем привет. С некоторым запозданием я решил опубликовать эту статью. Каждый год я стараюсь подвести итоги произошедшего в области обработки естественного языка (natural language processing). Не стал исключением и этот год.

BERTs, BERTs are everywhere

Начнем по порядку. Если вы не уехали в глухую Сибирскую тайгу или отпуск на Гоа на последние полтора года, то вы наверняка слышали слово BERT. Появившись в самом конце 2018-ого за прошедшее время эта модель завоевала такую популярность, что в самый раз будет вот такая картинка:

Natural Language Processing. Итоги 2019 и тренды на 2020 - 1
Читать полностью »

image

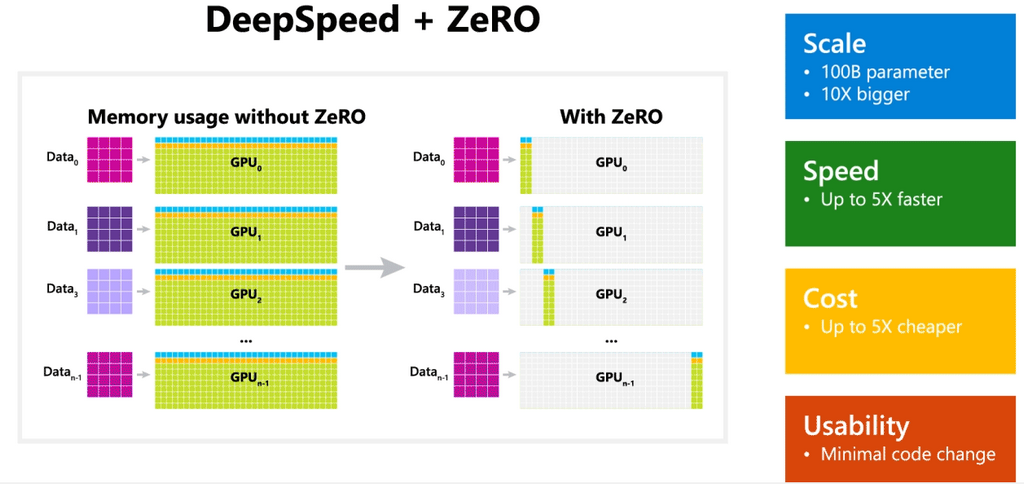
Microsoft выпускает библиотеку с открытым исходным кодом под названием DeepSpeed, которая значительно расширяет возможности обучения для больших моделей естественного языка. Она дает возможность обучения нейросетей на моделях со 100 млрд параметров и более. DeepSpeed ​​совместима с PyTorch. Читать полностью »

Всем привет!

Вступление

Меня зовут Алексей Клоков, я хочу рассказать о запуске классного курса по обработке естественного языка (Natural Language Processing), который очередной раз запускают физтехи из проекта DeepPavlov – открытой библиотеки для разговорного искусственного интеллекта, которую разрабатывают в лаборатории нейронных систем и глубокого обучения МФТИ. Благодарю их и Moryshka за разрешение осветить эту тему на Хабре в нашем ods-блоге. Итак, поехали!

Читать полностью »

Предыдущий выпуск

Экзоскелеты; бионические протезы; промышленные роботы; исследование автоматических рекоммендаций Ютуба; создание моделей машинного обучения в браузере с помощью MediaPipe; виртуальная клавиатура для смартфонов; 5G; еще раз о сильном и слабом ИИ.

Читать полностью »

Если вы интересуетесь машинным обучением, то наверняка слышали про BERT и трансформеры.

BERT — это языковая модель от Google, показавшая state-of-the-art результаты с большим отрывом на целом ряде задач. BERT, и вообще трансформеры, стали совершенно новым шагом развития алгоритмов обработки естественного языка (NLP). Статью о них и «турнирную таблицу» по разным бенчмаркам можно найти на сайте Papers With Code.

С BERT есть одна проблема: её проблематично использовать в промышленных системах. BERT-base содержит 110М параметров, BERT-large — 340М. Из-за такого большого числа параметров эту модель сложно загружать на устройства с ограниченными ресурсами, например, мобильные телефоны. К тому же, большое время инференса делает эту модель непригодной там, где скорость ответа критична. Поэтому поиск путей ускорения BERT является очень горячей темой.

Нам в Авито часто приходится решать задачи текстовой классификации. Это типичная задача прикладного машинного обучения, которая хорошо изучена. Но всегда есть соблазн попробовать что-то новое. Эта статья родилась из попытки применить BERT в повседневных задачах машинного обучения. В ней я покажу, как можно значительно улучшить качество существующей модели с помощью BERT, не добавляя новых данных и не усложняя модель.

Простое руководство по дистилляции BERT - 1

Читать полностью »

NeurIPS (Neural Information Processing Systems) – самая большая конференция в мире по машинному обучению и искусственному интеллекту и главное событие в мире deep learning.

Будем ли мы, DS-инженеры, в новом десятилетии осваивать еще и биологию, лингвистику, психологию? Расскажем в нашем обзоре.

NeurIPS 2019: тренды ML, которые будут с нами следующее десятилетие - 1
Читать полностью »

Предыдущий выпуск

Новости ML, новые технологии, идеи по применению и гипотезы.

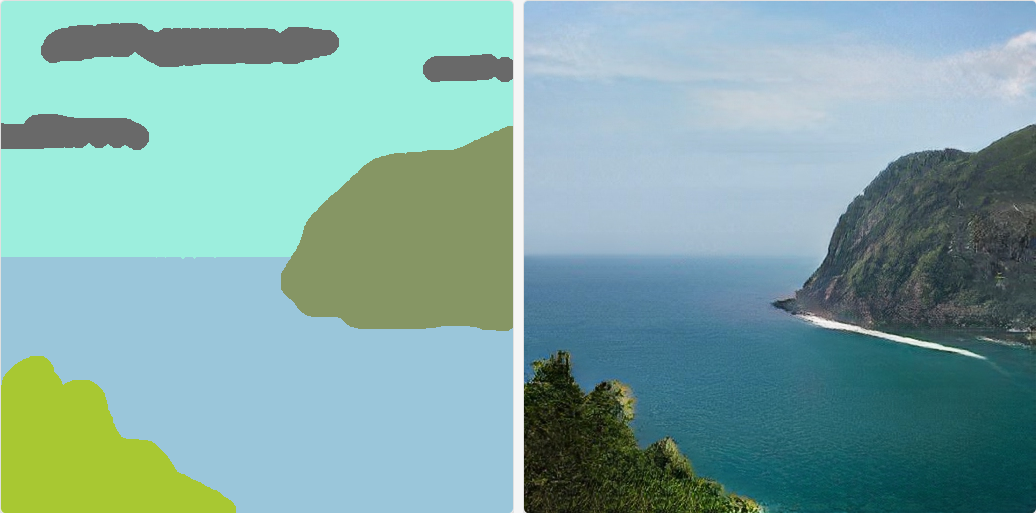
Nvidia GauGan

Изображение сделано в Nvidia GauGan. Видео, статья и исходный код.

Читать полностью »

Всем привет! Новогодние праздники подошли к концу, а это значит, что мы вновь готовы делиться с вами полезным материалом. Перевод данной статьи подготовлен в преддверии запуска нового потока по курсу «Алгоритмы для разработчиков».

Поехали!


Метод обратного распространения ошибки – вероятно самая фундаментальная составляющая нейронной сети. Впервые он был описан в 1960-е и почти 30 лет спустя его популяризировали Румельхарт, Хинтон и Уильямс в статье под названием «Learning representations by back-propagating errors».Читать полностью »

Сегодня я расскажу, как я применил алгоритмы глубинного обучения с подкреплением для управления роботом. Вкратце, поведаю о том, как создать «чёрный ящик с нейросетями», который на входе принимает архитектуру робота, а на выходе выдаёт алгоритм, способный им управлять.

Основой решения является алгоритм Advantage Actor Critic (A2C) с оценкой Advantage через Generalized Advantage Estimation (GAE).

Под катом математика, реализация на TensorFlow и множество демок того, к каким способам ходьбы сошлись алгоритмы.

Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js