Рубрика «python» - 235

За последние десятилетия с помощью машинного обучения создали самоуправляемые автомобили, системы распознавание речи и эффективный поиск. Сейчас это одна из самых быстроразвивающихся и перспективных сфер на стыке компьютерных наук и статистики, которая активно используется в искусственном интеллекте и data science. Методы машинного обучения используются в науке, технике, медицине, ритейле, рекламе, генерации мультимедиа и других областях.

Команда Университета ИТМО собрала десять курсов по машинному обучению, которые можно успеть пройти до конца лета. Одним они помогут войти в профессию, а другим — углубиться в нее.

image
Читать полностью »

Привет! Мы обожаем квизы, посвященные языкам программирования. В нашем блоге мы разместили уже целых три: первый — по Python, PHP, Golang, DevOps, второй — полностью по Go, третий — только по PHP. Сегодняшний квиз посвящен исключительно Python.

Предлагаем вам размяться в честь конца ещё одной летней недели и в преддверии PyCon Russia 2018. (Кстати, кто едет? Мы там будем).

Под катом — семь вопросов, советы от друга, Чапаев, отрывки из ABBA (что? да!) и крутой мерч.

Разминка для тех, кто умеет в Python - 1

Читать полностью »

Аннотация

Итак, мои коллеги-ученые, не спрашивайте, что вы можете сделать для воспроизводимости — спросите, что воспроизводимость может сделать для вас!

Здесь я перечислю пять причин, по которым возможность воспроизводимости данных окупается в долгосрочной перспективе и представляет личный интерес для каждого амбициозного, ориентированного на карьеру ученого.


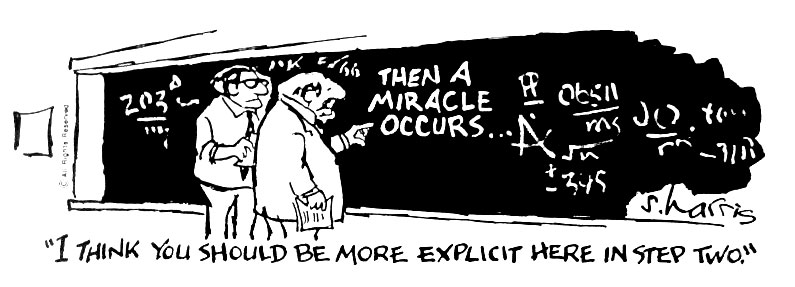
Сложное уравнение в левой половине черной доски, еще более сложное уравнение — в правой. Краткое предложение связывает два уравнения: «Здесь происходит чудо». Два математика, в глубоких раздумьях. «Я думаю, Вы должны быть более конкретны на втором шаге», — говорит один другому.
image

Примерно так выглядит ситуация, когда вы пытаетесь понять, как автор перешел от большого и сложного набора данных к плотной статье с множеством сложных графиков. Без доступа к данным и аналитическому коду такой переход можно объяснить разве что чудом. А в науке не должно быть чудес.

Читать полностью »

Завтра в отпуск

Мы в отделе аналитики онлайн-кинотеатра Okko (Мама, привет, я теперь работаю на Rambler) любим как можно сильнее автоматизировать подсчёты сборов фильмов Александра Невского, а в освободившееся время учиться новому и реализовывать классные штуки, которые почему-то обычно выливаются в ботов для Телеграма. К примеру, перед началом чемпионата мира по футболу 2018 мы выкатили в рабочий чат бота, который собирал ставки на распределение итоговых мест, а после финала подсчитал результаты по заранее придуманной метрике и определил победителей. Хорватию в четвёрку не поставил никто.

Недавнее же свободное от составления ТОП-10 российских комедий время мы посвятили созданию бота, который находит знаменитость, на которую пользователь больше всего похож лицом. В рабочем чате идею все настолько оценили, что мы решили сделать бота общедоступным. В этой статье мы кратко вспомним теорию, расскажем о создании нашего бота и о том, как сделать такого самому.

Читать полностью »

На просторах интернета представлены различные реализации, но, на мой взгляд, все они достаточно простые. Хочу представить свой вариант голосового справочника под астериск.

Примечание: я не являюсь профессиональным программистом, и, возможно, некоторые решения могут показаться вам дикими. Некоторые приемы могут быть устаревшими. Я готов принять критику и исправить систему к лучшему.

Краткое описание возможностей:

Пользователь попадает в IVR, произносит свой запрос и, в большинстве случаев, попадает туда, куда ему надо. К системе также прикручена статистика с записью в таблицу mysql.
Коротко о компании и сети, в которой развернута данная система:
~1000 телефонов, около 50 отделов

Читать полностью »

Два с половиной года назад я купил набор Lego Mindstorms EV3, чтобы сделать свои первые шаги в робототехнике. Вкатив на контроллер сборку ev3dev и наигравшись с управлением двигателями и сенсорами по SSH, я на два года охладел к покупке. Причина состояла в том, что мне не хватало фантазии по части того, что бы такое можно было собрать: после нескольких собранных моделей из Lego Technics (как коробочных, так и самодельных) я уже привык к чудесам наподобие дистанционно управляемых игрушек, а простые роботы наподобие представленных на Краковской выставке моделей из Lego у меня как у человека, работавшего в своё время над системой телемеханики, уже не вызывали достаточного вдохновения. Повторять чужой опыт тоже не особо хотелось.

В конце концов, меня осенило: моделью, достаточно сложной, интересной, практичной и при этом не слишком заезженной могли стать часы с кукушкой. Вдохновлённый этой идеей, я взялся за дело.
Читать полностью »

Предисловие

На просторах интернета имеется множество туториалов объясняющих принцип работы LDA(Latent Dirichlet Allocation — Латентное размещение Дирихле) и то, как применять его на практике. Примеры обучения LDA часто демонстрируются на "образцовых" датасетах, например "20 newsgroups dataset", который есть в sklearn.

Особенностью обучения на примере "образцовых" датасетов является то, что данные там всегда в порядке и удобно сложены в одном месте. При обучении продакшн моделей, на данных, полученных прямиком из реальных источников все обычно наоборот:

  • Много выбросов.
  • Неправильная разметка(если она есть).
  • Очень сильные дисбалансы классов и 'некрасивые' распределения каких-либо параметров датасета.
  • Для текстов, это: грамматические ошибки, огромное кол-во редких и уникальных слов, многоязычность.
  • Неудобный способ харнения данных(разные или редкие форматы, необходимость парсинга)

Исторически, я стараюсь учиться на примерах, максимально приближенных к реалиям продакшн-действительности потому, что именно таким образом можно наиболее полно прочувстовать проблемные места конкретного типа задач. Так было и с LDA и в этой статье я хочу поделиться своим опытом — как запускать LDA с нуля, на совершенно сырых данных. Некоторая часть статьи будет посвящена получению этих самых данных, для того, чтобы пример обрел вид полноценного 'инженерного кейса'.

Читать полностью »

Теперь, когда PEP 5721 готов, я хочу чтобы это был последний PEP за который мне пришлось так очаянно сражаться сталкиваясь с таким количеством людей презирающих моё мнение.

Читать полностью »

Я, как всегда, никуда не собиралась, когда в новостной ленте «ВКонтакте» вдруг увидела сообщение, что завтра последний день подачи заявок на Django Girls в Санкт-Петербурге — мастер-класс по программированию на Python для женщин. Обычно я читаю такие сообщения, когда регистрация на мероприятие уже закрыта. У меня особое везение на такие дела — узнать о событии на следующий день после его завершения. Поэтому, когда я поняла, что появилась реальная возможность попасть на бесплатный тренинг по Python, то быстро заполнила заявку, на всякий случай забронировала отель и стала ждать.

Мне кажется, я сразу знала, что меня примут, иначе как объяснить, что я проморгала аналогичное событие в Москве месяцем раньше и попала именно в Санкт-Петербурге! Можно ли придумать лучшее время для поездки: лето и белые ночи, чемпионат мира с возможностью посетить фан-зону на Конюшенной площади, знакомство с IT-сообществом Django Girls и офисом Wargaming, и под занавес праздник «Алые паруса»!
Читать полностью »

Сломал много копий в поисках решения для быстрого получения длинных историй цен для большого количества активов в Python. Ещё имел смелость желать работать с ценами в numpy-массивах, а лучше сразу в pandas.

Стандартные подходы в лоб работали разочаровывающе, что приводило к выполнению запроса к БД в течение 30 секунд и более. Не желая мириться, я нашёл несколько решений, которые полностью меня удовлетворили.
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js