
На страницах нашего блога мы рассказываем о сотрудничестве с самыми разными компаниями и организациями – от локальных интернет-магазинов до университетов с мировым именем. Увы, большинство подобных кейсов описывают работу с зарубежными партнерами, но иногда попадаются интересные примеры и в России. Сегодня именно такой случай. Герой нашей новой истории – компания CineLAB, которая занимается прокатом киносъемочного оборудования, обработкой пленки, цифровым постпродакшеном, спутниковой доставкой видеоконтента и многими другими интересными задачами в «киношном» мире.
Рубрика «big data» - 117
Решения Dell PowerEdge для кинотеатрального контент-провайдера
2015-03-03 в 11:12, admin, рубрики: big data, cinelab, dell, poweredge, Блог компании Dell, ит-инфраструктура, хранение данных
Лицензирование доступа к Big Data как средство монетизации Twitter
2015-03-02 в 20:24, admin, рубрики: big data, twitter, использование данных, Исследования и прогнозы в IT, Монетизация IT-систем, Монетизация веб-сервисов 
Социальная сеть Twitter до сих пор не приносит прибыли, несмотря на все усилия компании. Ранее руководство компании предпринимало несколько попыток монетизировать сервис: это и платные посты, и демонстрация пользователю рекламы, и другие схожие методы.
На самом деле, надежный способ монетизации Twitter может быть вовсе не с самим текстом, сообщениями, а поведенческими факторами пользователей. Эти факторы можно анализировать, изучать, ранжировать в зависимости от потребностей партнеров, и — продавать. При этом продаваемая информация не является личной. Это усредненные и обобщенные данные.
Читать полностью »
Wargaming и «Яндекс» сотрудничают в области Big Data
2015-03-02 в 15:52, admin, рубрики: big data, wargaming, анализ, монетизация игр, статистика, Управление сообществом, яндексRoem.ru со ссылкой на официальный пресс релиз от Yandex Data Factory (Big Data подразделения поисковика) сообщает о начавшемся сотрудничестве с компанией Wargaming. Последняя занимается разработкой и поддержкой популярной онлайн-игры «World of Tanks».
Yandex Data Factory сконцентрируется на статистике оттока аудитории из игры: сколько человек и в какой момент прекратит играть в World of Tanks.
Читать полностью »
Яндекс научил Wargaming избегать оттока игроков
2015-03-02 в 14:18, admin, рубрики: big data, wargaming, world of tanks, Yandex Data Factory, аналитика, Белоруссия, Игроделы, кейсы, статистика, Текучка, яндекс, метки: big data, wargaming, world of tanks, Yandex Data Factory, аналитика, Белоруссия, Игроделы, кейсы, статистика, Текучка, яндексYandex Data Factory — бигдата-проект «Яндекса» — совместно с Wargaming объявили о сотрудничестве. YDF поможет Wargaming научиться более точно предсказывать периоды оттока аудитории — сколько человек и когда прекратит играть в World of Tanks (WoT), сообщается в совместном отчете компаний.
Yandex Data Factory (Читать полностью »
Обзор наиболее интересных материалов по анализу данных и машинному обучению №37 (23 февраля — 1 марта 2015)
2015-03-01 в 16:07, admin, рубрики: big data, data mining, data science, data science digest, high scalability, machine learning, машинное обучение 
Представляю вашему вниманию очередной выпуск обзора наиболее интересных материалов, посвященных теме анализа данных и машинного обучения.
Читать полностью »
Анонс MongoDB 3
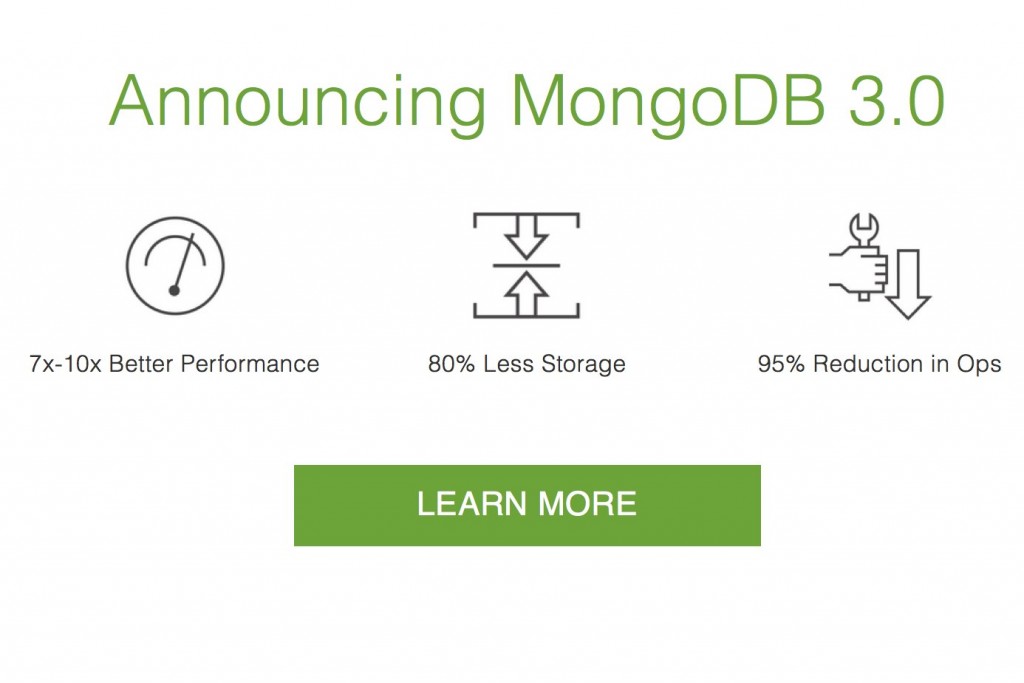
2015-02-28 в 0:28, admin, рубрики: Amazon Web Services, big data, mongodb, nosql, open source, базы данных Как-то незаметно прошел анонс новой версии MongoDB. Изменение номера версии с 2 на 3 указывает на значительные изменения внутри базы данных. Разработчики заявляют о значительном увеличении производительности и более лучшей маштабируемости. Немного подробнее под катом.
Читать полностью »
Как мы готовим будущих специалистов по большим данным
2015-02-27 в 12:11, admin, рубрики: big data, BigData, data mining, data science, Hadoop, machine learning, nosql, Блог компании New Professions Lab, машинное обучение, метки: hadoop, it образованиеВ эту субботу стартует наша программа “Специалист по большим данным”: она получилась такой насыщенной, что, кажется, в ближайшие три месяца у слушателей не останется никакого свободного времени. В этом посте я расскажу, как именно мы будем растить специалистов по Big Data, и как будет построен процесс обучения во время первого месяца.
Центральный кейс на этот период — создание DMP-системы. DMP (data management platform) анализирует интернет-логи пользователей и, исходя из их поведения в сети, присваивает этим людям различные свойства или причисляет к определенным классам. Например, правильно настроенная DMP-система может определить пол и возраст человека и узнать, является ли он гаджетоманом или, скажем, фанатом люксовых фешн-брендов. Этот кейс мы разрабатываем совместно с компанией Data-Centric Alliance, они используют большие данные для настройки рекламных кампаний.Читать полностью »
Обучение на больших данных: Spark MLlib
2015-02-26 в 13:53, admin, рубрики: Apache, big data, data mining, Hadoop, python, spark, анализ данных, Большие данные, машинное обучение, разработкаПривет!
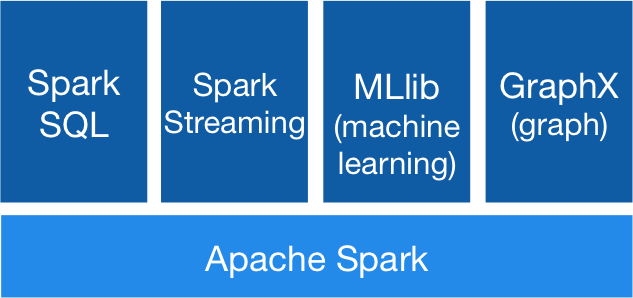
В прошлый раз мы познакомились с инструментом Apache Spark, который в последнее время становится чуть ли не самым популярным средством для обработки больших данных и в частности, Large Scale Machine Learning. Сегодня мы рассмотрим подробнее библиотеку MlLib, а именно — покажем, как решать задачи машинного обучения — классификации, регресии, кластеризации, а также коллаборативной фильтрации. Кроме этого покажем, как можно исследовать признаки с целью отбора и выделения новых (т.н. Feature Engineering, о котором мы говорили ранее, причем не один раз).
Читать полностью »
Apache Spark: что там под капотом?
2015-02-26 в 0:46, admin, рубрики: Apache, big data, big data analytics, data mining, Hadoop, mpp, spark, sparsql, параллельные вычисленияВступление
В последнее время проект Apache Spark привлекает к себе огромное внимание, про него написано большое количество маленьких практических статей, он стал частью Hadoop 2.0. Плюс он быстро оброс дополнительными фреймворками, такими, как Spark Streaming, SparkML, Spark SQL, GraphX, а кроме этих «официальных» фреймворков появилось море проектов — различные коннекторы, алгоритмы, библиотеки и так далее. Достаточно быстро и уверенно разобраться в этом зоопарке при отсутсвие серьезной документации, особенно учитывая факт того, что Spark содержит всякие базовые кусочки других проектов Беркли (например BlinkDB) — дело непростое. Поэтому решил написать эту статью, чтобы немножко облегчить жизнь занятым людям.
Небольшая предыстория:
Spark — проект лаборатории UC Berkeley, который зародился примерно в 2009г. Основатели Спарка — известные ученые из области баз данных, и по философии своей Spark в каком-то роде ответ на MapReduce. Сейчас Spark находится под «крышей» Apache, но идеологи и основные разработчики — те же люди.
Spoiler: Spark в 2-х словах
Spark можно описать одной фразой так — это внутренности движка массивно-параллельной СУБД. То есть Spark не продвигает свое хранилище, а живет сверх других (HDFS — распределенная файловая система Hadoop File System, HBase, JDBC, Cassandra,… ). Правда стоит сразу отметить проект IndexedRDD — key/value хранилище для Spark, которое наверное скоро будет интегрировано в проект.Также Spark не заботится о транзакциях, но в остальном это именно движок MPP DBMS.
RDD — основная концепция Spark
Ключ к пониманию Spark — это RDD: Resilient Distributed Dataset. По сути это надежная распределенная таблица (на самом деле RDD содержит произвольную коллекцию, но удобнее всего работать с кортежами, как в реляционной таблице). RDD может быть полностью виртуальной и просто знать, как она породилась, чтобы, например, в случае сбоя узла, восстановиться. А может быть и материализована — распределенно, в памяти или на диске (или в памяти с вытеснением на диск). Также, внутри, RDD разбита на партиции — это минимальный объем RDD, который будет обработан каждым рабочим узлом.
Международная выставка «EuroCIS-2015». Прямая twitter-трансляция
2015-02-24 в 7:01, admin, рубрики: big data, EuroCIS, IT-стандарты, Блог компании Кристалл Сервис, информационная безопасность, платежные системы, ритейл, торговля, метки: EuroCIS 
24–26 февраля в Дюссельдорфе проходит самое значимое событие ритейла — международная выставка EuroCIS 2015. В течении 3 дней выставка соберет вместе более 7 000 лучших специалистов из 23 стран.