Рубрика «big data» - 65

image
Осенью Физтех запустил цикл семинаров по искусственному интеллекту. В ходе обсуждений рассматриваются различные темы мира машинного обучения и технологического предпринимательства: как и почему интеллектуальные системы станут доминирующей частью нашей жизни и экономики в ближайшие годы, какие инициативы и проекты развиваются за рубежом, тренды рынка и как их создавать, что можно разрабатывать вместе с командами лабораторий МФТИ уже сейчас и как втянуться в союз и сотрудничество с «умными» машинами. Материалы курса доступны в Telegram-канале и группе AI@MIPT Вконтакте.

Третья встреча на тему: «Проект iPavlov. Как на Физтехе разрабатывают разговорный искусственный интеллект» состоится 13 ноября в 18:30 в 107 Биокорпуса МФТИ. Для очного участия в семинаре необходимо предварительно зарегистрироваться. Лекция также будет транслироваться онлайн на официальной странице Физтеха Вконтакте.
Читать полностью »
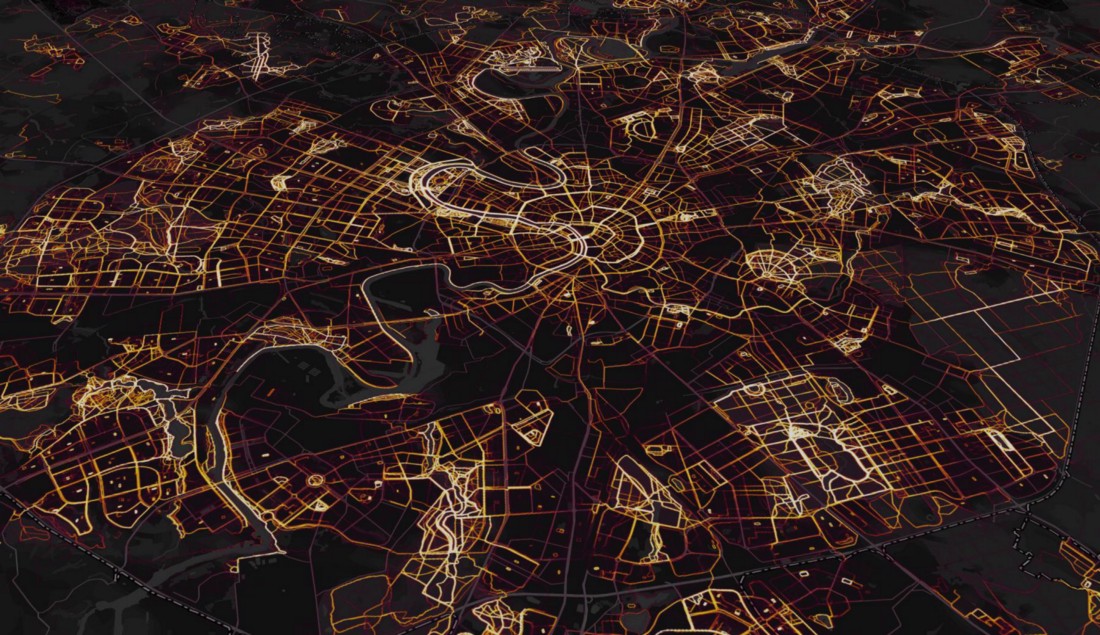
Рад объявить о первом крупном обновлении глобальной тепловой карты в Strava Labs c 2015 года. Это обновление включает в себя в шесть раз больше данных, чем раньше —  в сумме 1 миллиард активностей со всей базы Strava по сентябрь 2017 года.

Наша глобальная теплокарта — самая крупная и подробная, и это самый прекрасный в мире набор данных такого рода. Это прямая визуализация активностей глобальной сети атлетов Strava. Чтобы дать представление о масштабе, то новая теплокарта включает в себя:

  • 1 миллиард активностей
  • 3 триллиона точек долготы/широты
  • 13 триллионов пикселей после растрирования
  • 10 терабайт исходных данных
  • Общая дистанция маршрутов: 27 миллиардов километров
  • Запись общего времени активности: 200 тысяч лет
  • 5% земной суши покрыто тайлами

Глобальная теплокарта Strava: теперь в 6 раз горячее - 1
Тепловая карта Москвы демонстрирует функцию поворота/наклона в Mapbox GL
Читать полностью »

В эту субботу, 11 ноября, мы приглашаем читателей Хабра на однодневную конференцию по Data Science, Machine Learning и AI. Это мероприятие завершит Sberbank Data Science Journey, ежегодные соревнования по интеллектуальному анализу данных с применением передовых математических методов и алгоритмов. В этом году состязание проводилось на первом в своем роде русскоязычном наборе данных.

Мы наградим победителей и послушаем выступления от ведущих исследователей Nate Kushman (MIT, Microsoft Research UK), Дмитрий Ветров (ФКН ВШЭ, Bayes Group), Михаил Бурцев (МФТИ, iPavlov), Евгений Бурнаев (Сколтех, ADASE group) и Александр Тужилин (New York University, Сбербанк AI Lab). Кроме того, на специальной секции про бизнес в AI о пути своих компаний и перспективах монетизации AI расскажут основатели компаний Prisma, NTechLab, Rubbles и Vision Labs.

Подробная программа и ссылка на регистрацию — под катом.

Приглашаем на Sberbank Data Science Day 11 ноября - 1

Читать полностью »

О сборе данных. Как собирать данные, анализировать их и грабить корованы - 1
В предыдущей статье мы рассматривали вопросы качества данных («О качестве данных и распространенных ошибках при их сборе» на Хабре).
Сегодня я хочу продолжить разговор о качестве данных и обсудить их сбор: как правильно расставить приоритеты при выборе источника, как и какие данные собирать, оценка ценности данных для компании и другое.

Собирайте всё

Вы решили улучшить оформление и оплату товара на сайте?
Отлично, а как проходит процесс формирования корзины покупателем? В какой момент он делает окончательный выбор товаров: до добавления в корзину или перед оплатой покупки?
На каждом сайте может быть по разному, но как ведет себя клиент у вас?
При обладании данными об оформлении заказа их можно проанализировать и определиться с вектором обновления, который будет удобен не только вам, но и пользователям.
Читать полностью »

Является продолжением предыдущих публикаций. Основное назначение публикаций — демонстрация возможностей R по решению различных "рутинных" задач по обработке данных, возникающих в бизнесе. Основной акцент ставится на создание законченного решения для конечного пользователя, а не на принципиальное решение частной задачи набором команд в консоли. Схематический прототип и продукт с конвейера имеют больше различий чем сходства.

По тонкой механике R есть огромное количество специализированных блогов, книг, а также github. Но обращаются к ним обычно только после того, как видят, что решение задачи средствами R возможно и весьма элегантно.

Читать полностью »

Обучающиеся магистерских программ «Управление разработкой ПО» и «Разработка безопасных систем и сетей» Университета Иннополис помогли решить 16 задач ИТ-компаний. 

image
Читать полностью »

Меня часто спрашивают об основных отличиях DAX и MDX или в целом о различии табличной и многомерной модели.

С точки зрения выражения или языка запросов, одно из наиболее важных различий лежит во внутренней основе обоих подходов.

В кубе, для адресации ячейки в пространстве, у нас есть понятие кортежа. Ось в кортеже устанавливает координаты. Если у нас есть единственный кортеж, то результат — содержание соответствующей ячейки в кубе. Поскольку у атрибутов куба есть элемент All, который служит значением по умолчанию (в большинстве случаев), если атрибут не был включен в кортеж, то мы выполняем агрегацию также, как если бы он там был. Например, следующий кортеж возвращает (агрегированный) объем продаж за 2013 год

(Date.Calendar.[Calendar Year].&[2013], Measures.[Internet Sales Amount])

Читать полностью »

image

Всем привет! Мы долго готовились, искали крутых докладчиков и, наконец, анонсируем Moscow Spark #3, который состоится 16 ноября на Мансарде Rambler&Co! Предыдущий митап собрал почти 250 человек, и мы рассчитываем, что сможем собрать не меньше в этот раз. Ключевой темой этого мероприятия станет Spark Streaming, актуальная и очень интересная часть фреймворка Apache Spark.
Читать полностью »

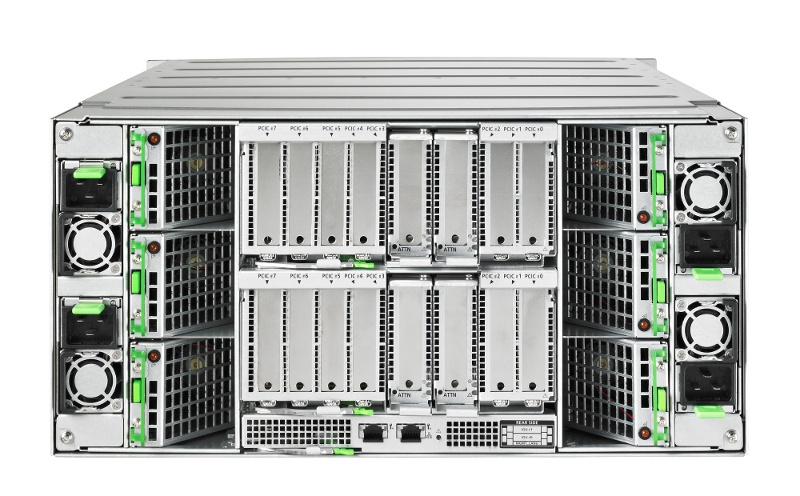
In-memory СУБД SAP HANA и использующие ее приложения пользуются все большей популярностью у компаний. И такой рост побуждает разработчиков инфраструктурных решений для SAP HANA предлагать максимально удобные и выгодные для заказчиков варианты решений. Сегодня мы расскажем о вариантах, предлагаемых Fujitsu.
Поддержка SAP HANA: новые возможности - 1
Fujitsu PRIMEQUEST 3800B
Читать полностью »

«5П»: О качестве данных и распространенных ошибках при их сборе - 1
Многие компании считают, что работают и принимают решения на основе данных, но часто это не так. Ведь для того чтобы управление велось на основе данных, их, эти самые данные, недостаточно только собрать и свести в статистику.

Намного важнее провести правильный анализ, а для этого они должны быть «чисты».
Разбираться в чистоте данных и в основных качественных параметрах я начну с этой статьи.
Для достоверной аналитики должны быть соблюдены все «П» данных: правильные, правильно собранные, собранные в правильной форме, в правильном месте и в правильное время.
Если один из параметров нарушен, это может сказаться на достоверности всей аналитики, а значит нужно понимать, на что важно обращать внимание при  работе с данными.
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js