Рубрика «data mining» - 68

Доллар - 1

Последние два года вся страна пристально следит за курсом доллара. Новостные выпуски пестрят громкими репортажами о долларе. Все говорят о долларе. А что, если мы на фоне горячего интереса, разберемся с тем, как формируется цена доллара, посмотрим кто и как торгует валютой?! Все результаты, представленные в данной статье, получены на основе официальных торговых данных full orders log (полный журнал заявок), купленные на Московской Бирже. Мы покажем реальные торги изнутри. Параллельно, познакомимся со стандартными методами анализа рынка. Такая аналитика стоит не малых денег и её могут позволить ограниченное число «компаний».

Инструментом для анализа данных будет Java. Анализируемый биржевой инструмент — USDRUB_TOM. Наша задача вытащить любопытные детали из имеющихся данных и попробовать сделать определенные выводы.
Читать полностью »
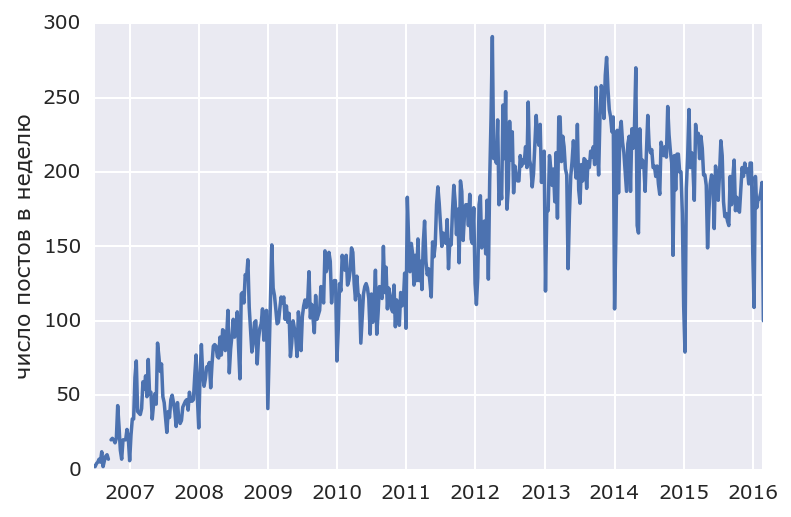
Я люблю писать тексты по мотивам проектов, которыми занимаюсь. За последний год я разместил на Хабре больше 20 постов. Меня постоянно удивляло, как мало толковых комментариев удаётся здесь получить. Просмотров много, а комментариев мало и большинство не по делу. Недавно я начал замечать, натыкаясь на старинные посты за 2012, 2013 годы, что в них обсуждение, как будто, более содержательное. Решил проверить это количественно. Скачал инфу по всем постам за все годы и построил несколько простых графиков. То что я увидел меня удивило и даже немного испугало. Решил разместить наблюдения здесь, чтобы проверить правильные ли я делаю выводы и всё ли учёл.

Для всех опубликованных на Хабре постов я собрал даты публикаций, число просмотров, число лайков и дислайков, число звёздочек и комментариев, список хабов и названия блогов компаний. В ходе прокачки узнал, что число плюсиков и минусиков может быть дробным и даже отрицательным, пост может быть опубликовал в блоги нескольких компаний и может не иметь автора. Если что, таблицу можно скачать из репозитория github.com/alexanderkuk/analyze-habr/blob/master/data/posts.csv
Хабр умирает? - 1

Первым делом я посмотрел как менялось общее число постов со временем. Оно перестало расти в 2013 и немного падает с 2014, что уже немного тревожно:
Хабр умирает? - 2

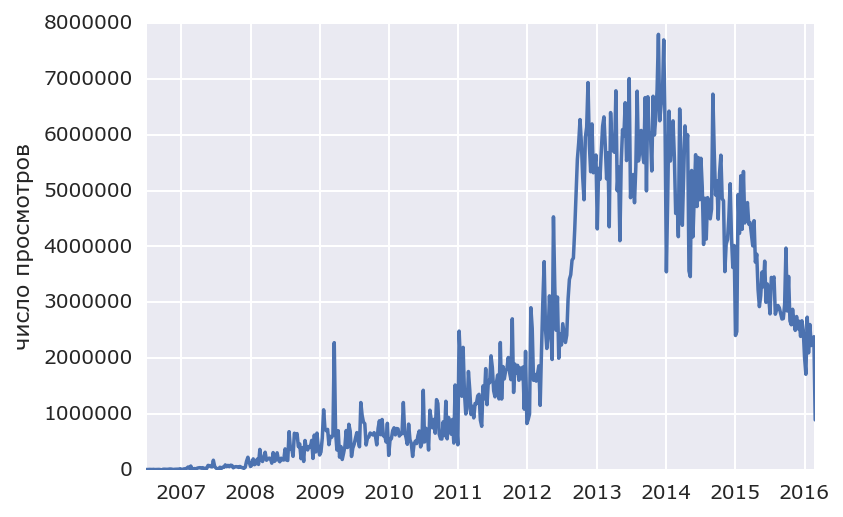
Потом я построил такой же график для суммарного числа просмотров и испугался. С 2014 оно упало в 3.5 раза:
Хабр умирает? - 3

Это серьёзное утверждение, поэтому я решил свериться с Similarweb.
Читать полностью »

Сегодня закончился «первый» хакатон по дата журналистике. Мы заняли на нём первое место. Проделали огромный объём работы за одни сутки. Я хотел бы рассказать как всё было.

Темой хакатона были финансы российских СМИ. Ежегодно государство поддерживает СМИ, поднимающие в своих материалах социально важные темы. Для этого проводится специальный конкурс. Главным критерием отбора получателей субсидий является «социальная значимость» проекта. Мы решили понять, что скрывается за формулировкой «социальная значимость» и какие темы оказались самыми популярными и «дорогими» в 2015 году.

Забегая вперёд, скажу, что ответ такой:

  • По опросам очень много россиян считают себя патриотами, но государство всё равно даёт больше всего денег на проекты про патриотизм.
  • 2015 год был годом литературы и на него пришлось 70 лет победы, поэтому «год литературы» и «историческая память в топе».
  • Субсидии, по идее, должны даваться на социально значимые проекты, «развитие Крыма», например, не очень в тему.
  • В целом складывается ощущение, что чаще пишут и читают об исторической памяти, чаще вспоминают достижения прошлых лет, в то время как на материалы об инновациях и новых технологиях государство выделяет меньше.

Как мы участвовали в хакатоне по дата журналистике. Социально значимое: Государству виднее - 1

А теперь как мы пришли к этим выводам.
Читать полностью »

Приглашаем на Data Fest 5 и 6 марта - 1

5 и 6 марта в московском офисе компании Mail.Ru Group состоится Data Fest2 — двухдневная серия митапов российских Data Science-сообществ Moscow Data Fest и Moscow Data Science. Data Fest2 — это конференция, на которой участникам представится возможность познакомиться с разными направлениями в современном анализе данных: от сугубо практических вопросов внедрения результатов исследований до самых последних теоретических разработок в анализе текстов и глубоком обучении.

В рамках конференции также пройдут два мероприятия, где все участники смогут проявить себя: хакатон для желающих посоревноваться друг с другом в предсказании исхода турнира по Dota 2 и питч-постер сессия для исследователей, где можно будет представить результаты своих исследований и разработок.
Читать полностью »

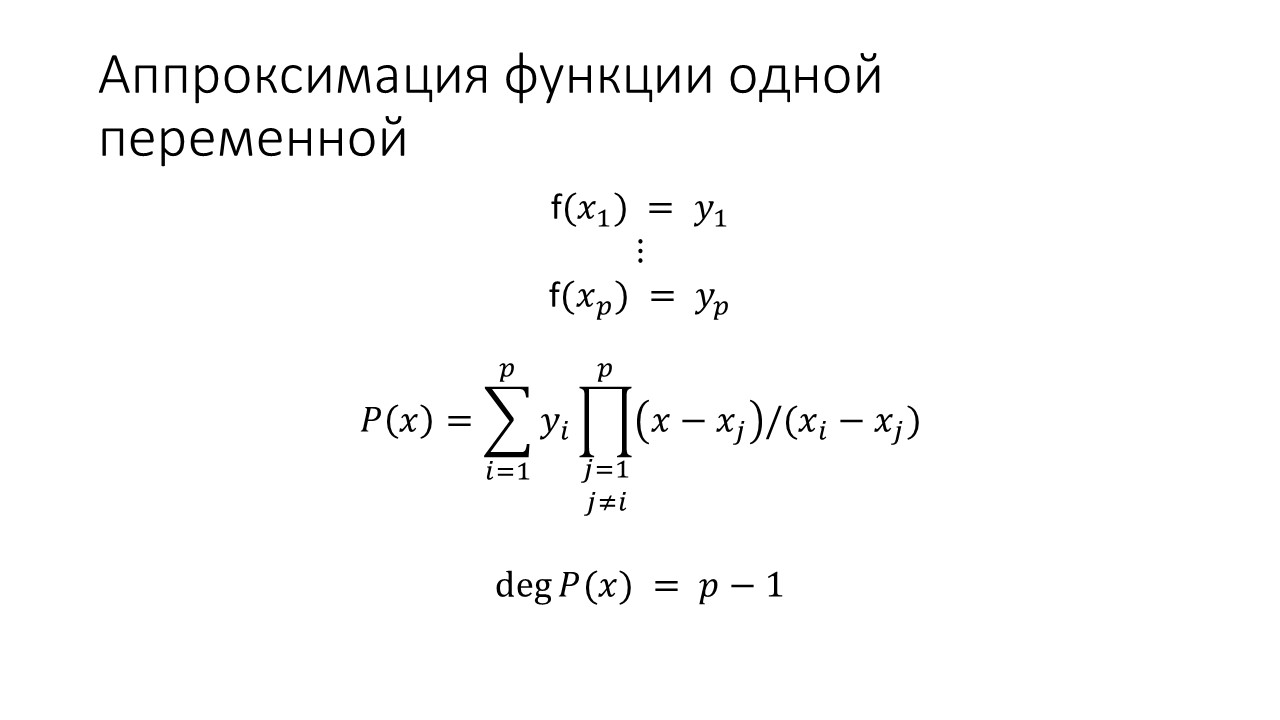
В задачах интерполяции функций по заданным значениям функции для заданного набора аргументов широко применяется формула аппроксимации функции полиномом, совпадающего в заданных точках со значениями исследуемой функции.
image
Обобщим эту формулу на случай функции нескольких переменных
Читать полностью »

О пользе технологий больших данных в повседневной жизни - 1

Среди многих исследователей и разработчиков бытует мнение, что инструменты обработки больших данных в области машинного обучения часто избыточны – всегда можно сделать сэмпл, загнать в память и использовать любимые R, Python и Matlab. Но на практике встречаются задачи, когда даже относительно небольшой объем данных, размером в пару гигабайт, обработать в таком стиле затруднительно – и тут-то и могут помочь те самые технологии «больших данных».

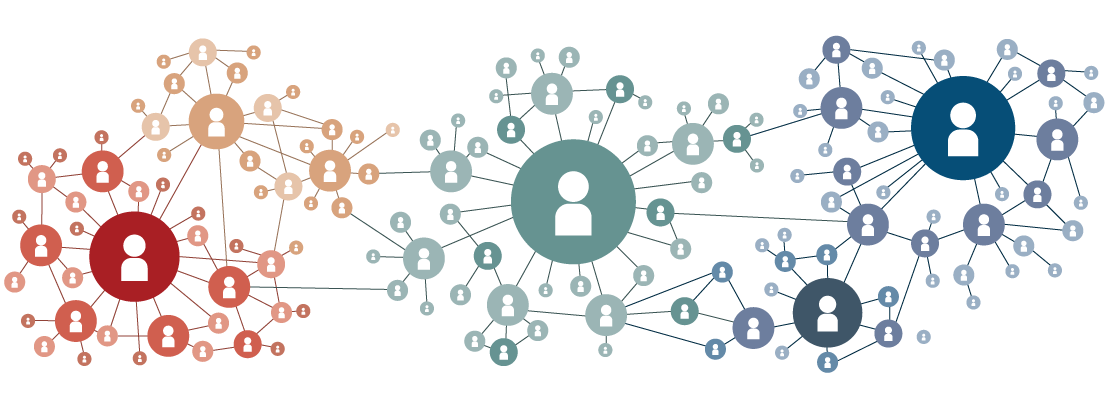
Хорошим наглядным примером такой задачи является задача нашего конкурса SNA Hakathon 2016: дан социальный граф одного миллиона пользователей и их демография. Задача — найти скрытые связи в этом графе. Размер предоставленного графа всего два гигабайта в GZip и, казалось бы, применение технологий больших данных здесь не оправданно, но это только на первый взгляд.

Одной из самых важных «фич» в задаче поиска скрытых связей в социальном графе является количество общих друзей. И в расчетном плане это очень тяжелая «фича» — количество узлов, между которыми существуют пути длины 2, на несколько порядков больше, чем количество прямых связей в графе. В результате при расчете граф «взрывается» и из разрежённой матрицы на два гигабайта превращается в плотную терабайтную матрицу.

Казалось бы, для решение этой задачи впору поднимать небольшой кластер, но спешить не стоит: взяв на вооружение принципы обработки больших данных и соответствующие технологии, задачу можно решить и на обычном ноутбуке. Из принципов мы возьмем «разделяй и властвуй» и «руби хвосты сразу», а в качестве инструмента — Apache Spark.
Читать полностью »

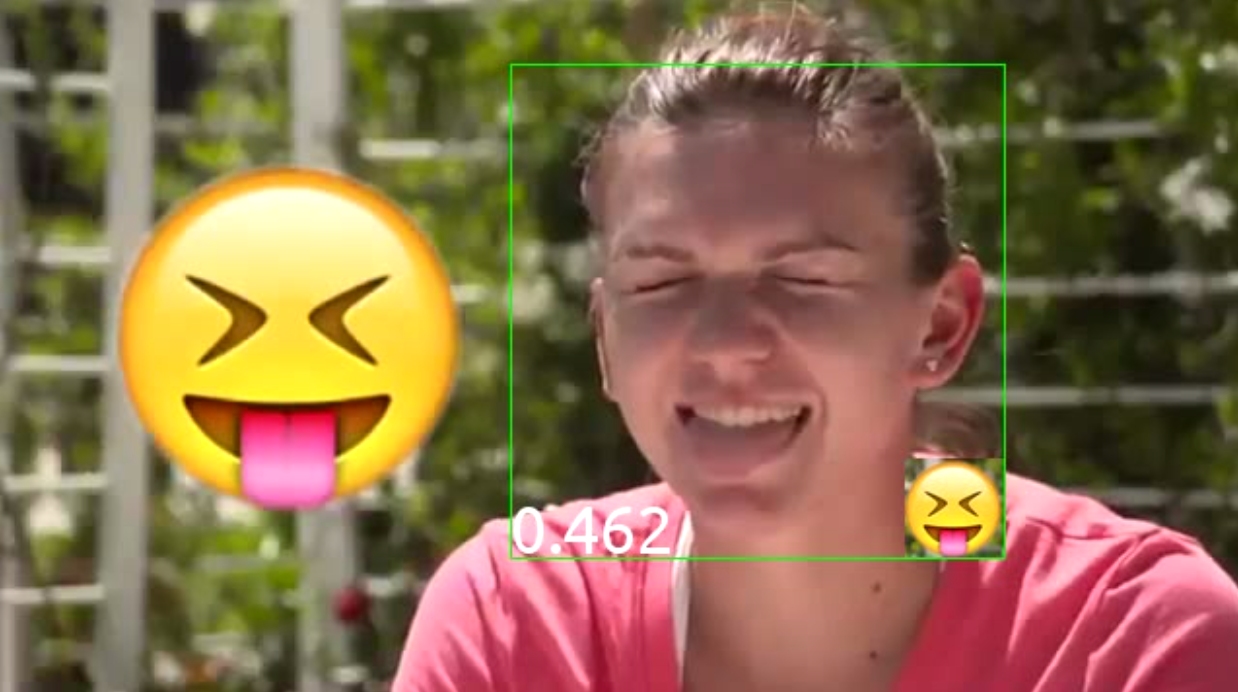
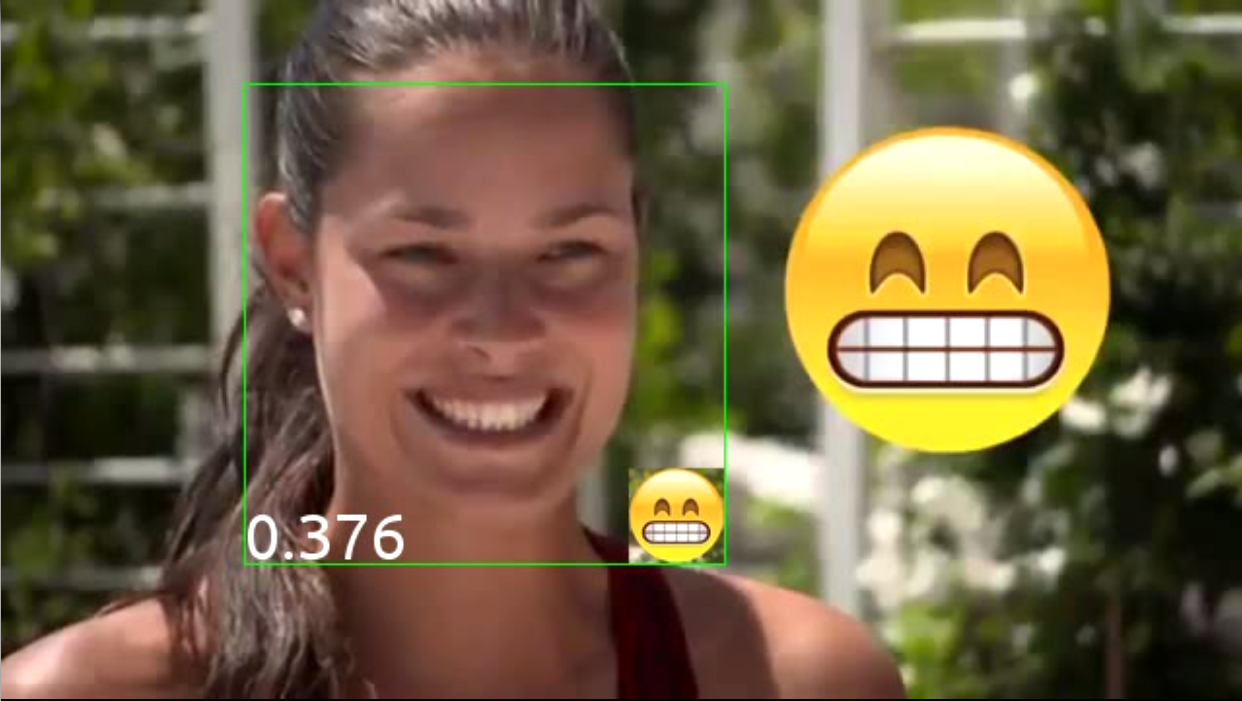
Пример работы системы
Это третья статья из серии про определение смайла по выражению лица.

Глубокое обучение в гараже — Братство данных
Глубокое обучение в гараже — Две сети
Глубокое обучение в гараже — Возвращение смайлов

Так что же со смайлами?

Фух, ну наконец, детекция лиц работает, можно учить сеть распознавания смайла. Только вот на чем учить? Открытых наборов данных нет. А из того, как долго в предыдущей части я добирался до, собственно, обучения моделей вы уже должны были понять, что в глубоком обучении данные решают все. И их нужно много.
Читать полностью »

Сервис «Kimono» закрывается - 1
После двух лет активной разработки и бурного роста пользовательской базы (свыше 125 тыс. клиентов) команда облачного сервиса Kimono радостно сообщает о своём присоединении к Palantir — частной американской компании-разработчику программного обеспечения анализа данных для организаций. Событие это радостное, но не во всём.Читать полностью »

Пример работы системы
Это вторая статья из серии про определение смайла по выражению лица.

Глубокое обучение в гараже — Братство данных
Глубокое обучение в гараже — Две сети

Калибрация

Итак, с классификатором, разобрались, но вы наверняка уже заметили, что заоблачные 99% как-то не очень впечатляюще выглядят во время боевого теста на детекцию. Вот и я заметил. Дополнительно видно, что в последних двух примерах очень мелкий шаг движения окон, так в жизни работать не будет. В настоящем, реальном запуске шаг ожидается больше похожим на картинку для первой сети, а там хорошо видно неприятный факт: как бы хорошо сеть не искала лица, окна будут плохо выровнены к лицам. И уменьшение шага — явно не подходящее решение этой проблемы для продакшена.
Читать полностью »

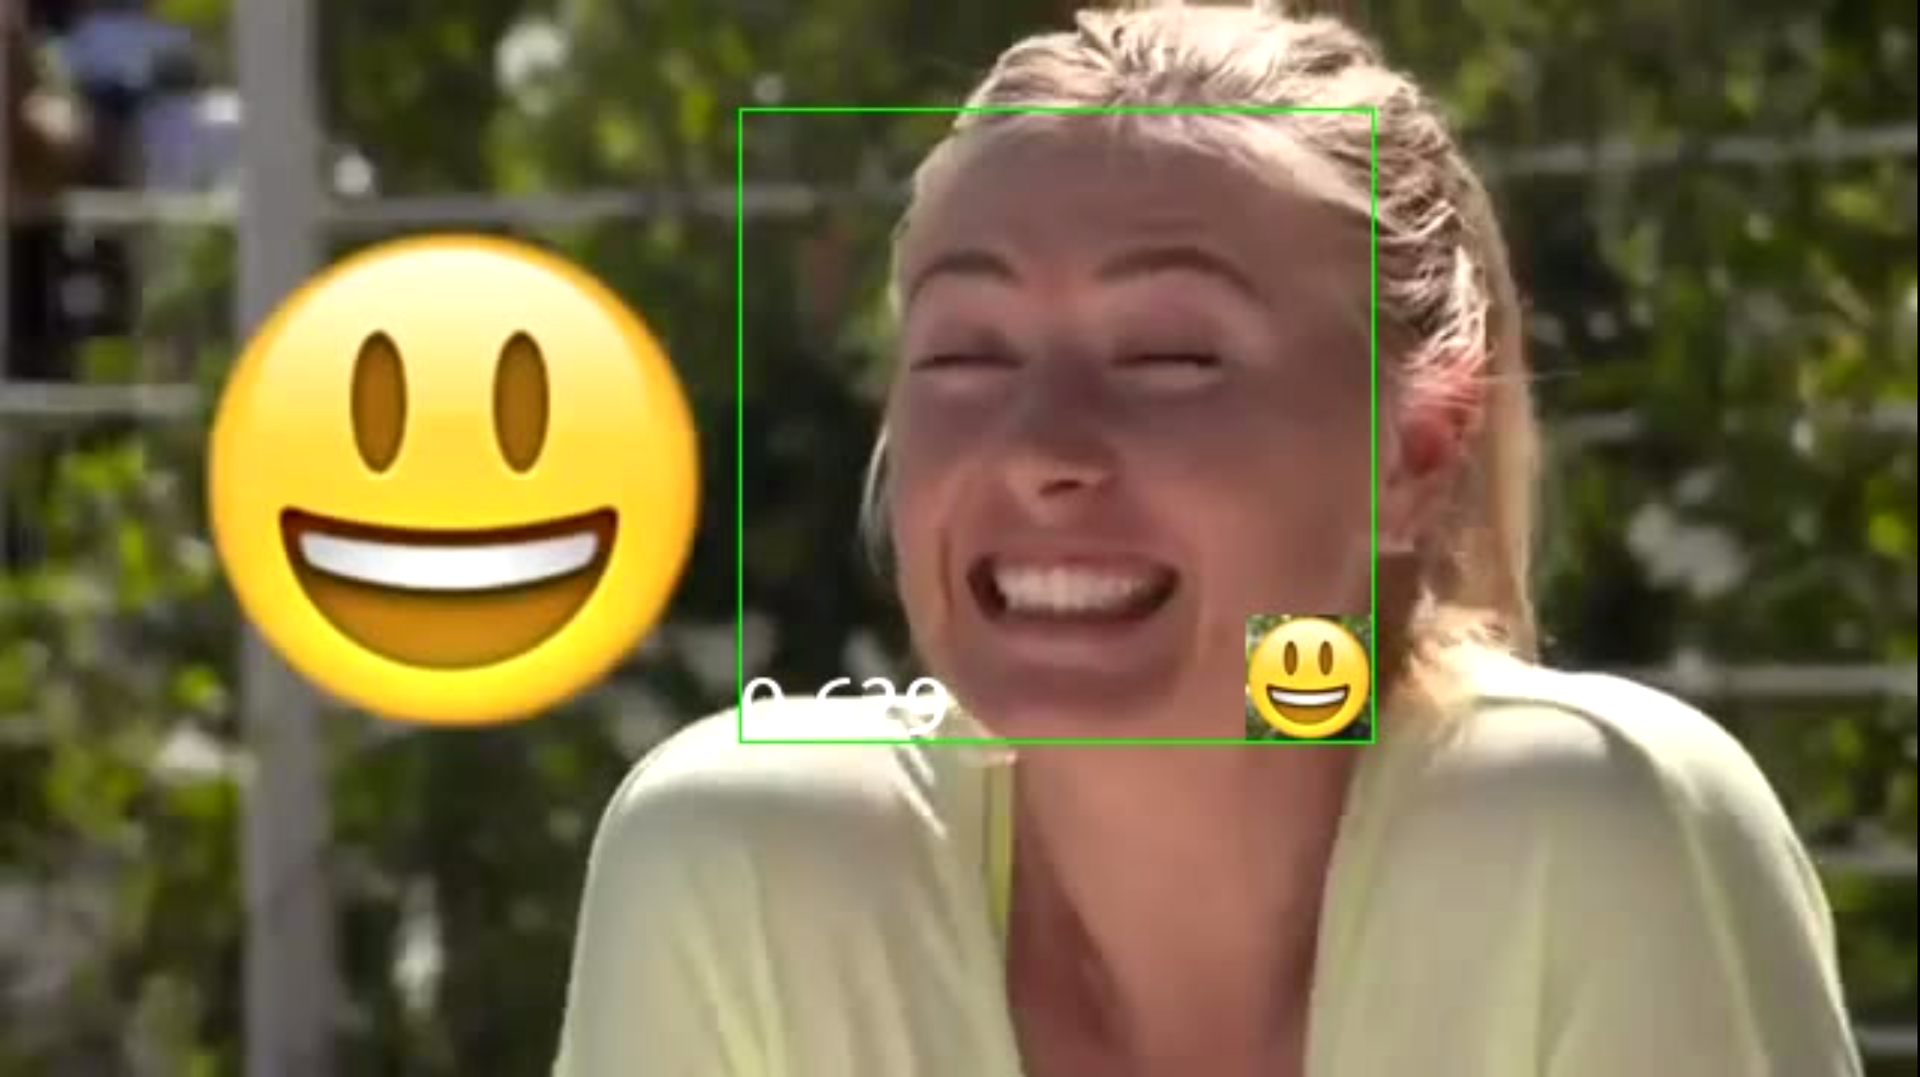
Пример работы системы
Вы тоже находите смайлы презабавнейшим феноменом?
В доисторические времена, когда я еще был школьником и только начинал постигать прелести интернета, с первых же добавленных в ICQ контактов смайлы ежедневно меня веселили: ну действительно, представьте, что ваш собеседник корчит рожу, которую шлет вам смайлом!

С тех пор утекло много воды, а я так и не повзрослел: все продолжаю иногда улыбаться присланным мне смайлам, представляя отправителя с глазами разного размера или дурацкой улыбкой на все лицо. Но не все так плохо, ведь с другой стороны я стал разработчиком и специалистом в анализе данных и машинном обучении! И вот, в прошлом году, мое внимание привлекла относительно новая, но интересная и будоражащая воображение технология глубокого обучения. Сотни умнейших ученых и крутейших инженеров планеты годами работали над его проблемами, и вот, наконец, обучать глубокие нейронные сети стало не сложнее "классических" методов, вроде обычных регрессий и деревянных ансамблей. И тут я вспомнил про смайлы!

Представьте, что чтобы отправить смайл, вы и вправду могли бы скорчить рожу, как бы было круто? Это отличное упражнение по глубокому обучению, решил я, и взялся за работу.
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js