Рубрика «java» - 87

В один прекрасный момент, в ходе разработки игры, я столкнулся с вопросом производительности на современных ПК. У нашего моделлера достаточно мощный современный компьютер красной сборки. Но у него наш проект жутко тормозил, загружая одно ядро процессора.

Причина проста — в новых процессорах много ядер, но по факту они менее производительны в однопоточных приложениях. На тот момент, у меня был рендер в один поток. Но на самом деле причины была не столько в этом. И в процессе поиска проблемы, я решил посчитать сколько полигонов присутствует в сцене:

[] Оптимизация графики. Интересный Concave Hull - 1

На средней игровой карте, при максимальном отдалении и при большом скоплении пальм — 15 824 756 треугольников! Почти 16 миллионов! Огромная цифра.
Читать полностью »

Существует популярное заблуждение о том, что если не нравится garbage collection, то надо писать не на Java, а на C/C++. Последние три года я занимался написанием low latency кода на Java для торговли валютой, и мне приходилось всячески избегать создания лишних объектов. В итоге я сформулировал для себя несколько простых правил, как свести аллокации в Java если не до нуля, то до некого разумного минимума, не прибегая к ручному управлению памятью. Возможно, кому-то из сообщества это тоже будет полезно.

Читать полностью »

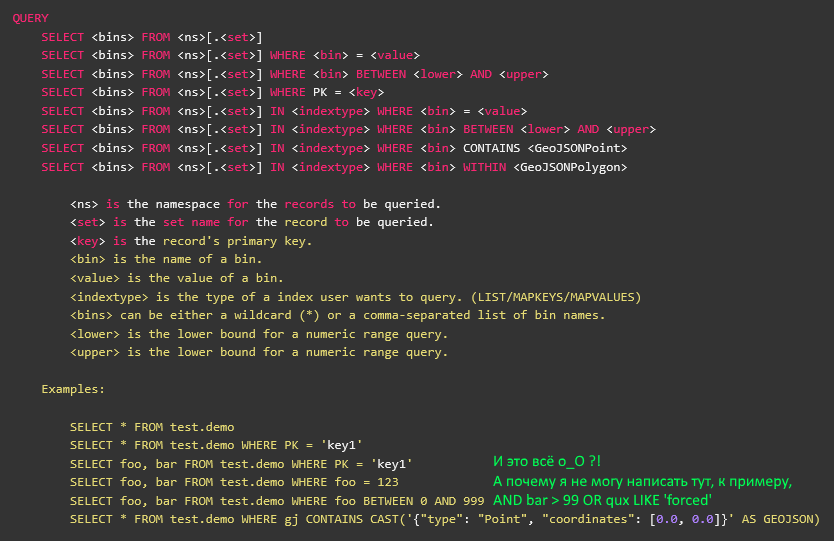
TL;DR: GitHub://PastorGL/AQLSelectEx.

Aerospike AQL SELECT

Однажды, ещё не в студёную, но уже зимнюю пору, а конкретно пару месяцев назад, для проекта, над которым я работаю (нечто Geospatial на основе Big Data), потребовалось быстрое NoSQL / Key-Value хранилище.

Терабайты исходников мы вполне успешно прожёвываем при помощи Apache Spark, но схлопнутый до смешного объёма (всего лишь миллионы записей) конечный результат расчётов надо где-то хранить. И очень желательно хранить таким образом, чтобы его можно было по ассоциированным с каждой строкой результата (это одна цифра) метаданным (а вот их довольно много) быстро найти и отдать наружу.

Читать полностью »

Давным-давно в одной далёкой-далёкой... проекте, понадобилось мне сделать обработку http-запросов на Netty. К сожалению, стандартных удобных механизмов для маппинга http-запросов в Netty не нашлось (да и этот фреймвёрк совсем не для того), поэтому, было решено реализовать собственный механизм.

Читать полностью »

Открыта регистрация на GraphQL Meetup в Питере - 1

Приглашаем вас на Piter GraphQL Meetup, который пройдет 24 января в питерском офисе Wrike. Ждем разработчиков любого уровня: как уже использующих GraphQL, так и присматривающихся к перспективной технологии.
Читать полностью »

В ближайшем будущем в языке Java появятся новые фичи, над которыми сейчас идет работа в рамках проектов Valhalla, Panama и Loom. Расширение языка — дело непростое, тем более — языка, в котором акцент делается на обратную совместимость; поэтому для того, чтобы их интеграция в Java прошла органично, архитекторам языка приходится решать накопившиеся фундаментальные вопросы.

Вчера (8 января) Брайан Гетц, работающий в Oracle на должности Java Language Architect, опубликовал в рассылке Project Amber письмо «Нам нужно больше ключевых слов, капитан!», в котором предложил способ решения проблемы добавления в язык новых ключевых слов. Вследствие чего в языке могут появиться такие ключевые слова, как non-null, non-final, eventually-final и this-return (полный список ждет вас под катом в конце поста).

Поскольку в прошлом эта проблема возникала в языке нечасто, обычно над ней особо не задумывались и «старались как можно быстрее свалить с шеи»; из-за недостатков уже существующих подходов в будущем их применение будет проблематичным, и в связи с этим было решено сработать на упреждение. Предлагаемое решение: попытаться расширить набор лексических форм, которые можно использовать в качестве ключевых слов: разрешить ключевые слова, разделенные дефисом, в составе которых будет использоваться одно (или более) уже существующее ключевое слово или зарезервированный идентификатор.

Важное замечание: Брайн отмечает, что новые ключевые слова приведены исключительно в качестве иллюстративного примера, и что заострять на них свое внимание не стоит. Однако, очевидно, что перед нами продуманная демонстрация того, как синтаксис языка может измениться в будущем — в письме автор упоминает, что эта идея поможет добавить в Java многие желаемые недостающие языковые конструкции.
Читать полностью »

Обзор фреймврока Axonframework

Axonframework это фреймфорк реализующий несколько принципов и паттернов проектирования такие как:

CQRS – разделяет обработку запросов на чтение и запись данных
Event Sourcing – это когда состояние приложения хранится как цепочка событий
DDD Aggregate – доменный объект (domain object) который хранит состояние

Один из недостатков хранения конечного состояния приложения в виде цепочки событий – это количество хранимых и обрабатываемых событий. К счастью, Axonframework позволяет создавать снимок событий (snapshot event), который содержит в себе результат нескольких событий (domain event).
Читать полностью »

Spock предоставляет 3 мощных (но разных по сути) инструмента, упрощающих написание тестов: Mock, Stub и Spy.

Моки, стабы и шпионы в Spock Framework - 1

Довольно часто коду, который нужно протестировать, требуется взаимодействовать с внешними модулями, называющимися зависимостями (в оригинальной статье используется термин collaborators, который не очень распространён в русскоязычной среде).

Модульные тесты чаще всего разрабатываются для тестирования одного изолированного класса при помощи различных вариантов моков: Mock, Stub и Spy. Так тесты будут надёжнее и будут реже ломаться по мере того, как код зависимостей эволюционирует.

Такие изолированные тесты менее подвержены проблемам при изменении внутренних деталей реализации зависимостей.

От переводчика: каждый раз, когда я использую Spock Framework для написания тестов, я чувствую, что могу ошибиться при выборе способа подмены зависимостей. В этой статье есть максимально краткая шпаргалка по выбору механизма для создания моков.

Читать полностью »

Привет! Меня зовут Андрей Неведомский и я главный инженер в СберТехе. Я работаю в команде, которая занимается разработкой одного из системных сервисов ЕФС (Единой Фронтальной Системы). В своей работе мы активно используем Spring Framework, в частности его DI, и время от времени сталкиваемся с тем, что резолвинг зависимостей в спринге оказывается недостаточно «умным» для нас. Эта статья – результат моих попыток сделать его умнее и в целом разобраться с тем, как он работает. Надеюсь, и вы сможете узнать из неё что-то новое об устройстве спринга.

Кастомизация резолвинга зависимостей в Spring - 1
Читать полностью »

Введение в Spring Boot: создание простого REST API на Java - 1

Из-за громоздкой конфигурации зависимостей настройка Spring для корпоративных приложений превратилась в весьма утомительное и подверженное ошибкам занятие. Особенно это относится к приложениям, которые используют также несколько сторонних библиотек

Каждый раз, создавая очередное корпоративное Java-приложение на основе Spring, вам необходимо повторять одни и те же рутинные шаги по его настройке:

  • В зависимости от типа создаваемого приложения (Spring MVC, Spring JDBC, Spring ORM и т.д.) импортировать необходимые Spring-модули
  • Импортировать библиотеку web-контейнеров (в случае web-приложений)
  • Импортировать необходимые сторонние библиотеки (например, Hibernate, Jackson), при этом вы должны искать версии, совместимые с указанной версией Spring
  • Конфигурировать компоненты DAO, такие, как: источники данных, управление транзакциями и т.д.
  • Конфигурировать компоненты web-слоя, такие, как: диспетчер ресурсов, view resolver
  • Определить класс, который загрузит все необходимые конфигурации

Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js