Рубрика «machine learning» - 18

Всем привет!

Huawei Russian Research Institute (Huawei RRI) в рамках программы взаимодействия с ведущими российскими университетами (МФТИ, МГУ, МГТУ им. Н. Э. Баумана) представляет открытый курс “Natural Language Processing” или “Обработка естественного языка”, который пройдет на площадке московского корпуса Физтеха.

Курс Natural Language Processing (обработка естественного языка) - 1Читать полностью »

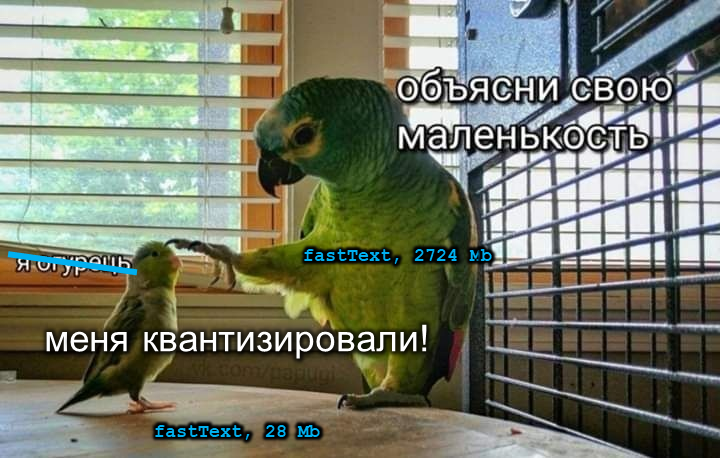
Модель fastText — одно из самых эффективных векторных представлений слов для русского языка. Однако её прикладная польза страдает из-за внушительных (несколько гигабайт) размеров модели. В этой статье мы показываем, как можно уменьшить модель fastText с 2.7 гигабайт до 28 мегабайт, не слишком потеряв в её качестве (3-4%). Спойлер: квантизация и отбор признаков работают хорошо, а матричные разложения — не очень. Также мы публикуем пакет на Python для этого сжатия и пример компактной модели для русских слов.
Как сжать модель fastText в 100 раз - 1

Читать полностью »

Создать мощный курс Machine Learning: миссия выполнена - 1


У нас было 2 неудачных запуска, 169 студентов, 8 сердитых отзывов, 3 смены названий, слишком много теории и мало реальной практики. Не то чтобы это было полным провалом, но если начал обучать Data Science, надо сделать это идеально. Сегодня вы услышите историю о том, как мы развивали в OTUS направление анализа данных и какие на этом пути допустили, а потом исправили ошибки.


Читать полностью »

Люди не всегда точно формулируют свои запросы, поэтому поисковые системы должны помогать им в этом. Меня зовут Сергей Юдин, я руковожу группой аналитики функциональности поиска в Яндексе. Мы каждый день улучшаем что-то с помощью машинного обучения. Последний год мы разрабатываем технологию, которая предугадывает интересы человека.

Со специалистом из моей команды Анастасией Гайдашенко avgaydashenko я расскажу читателям Хабра, как работает эта технология, опишу архитектуру и применяемые алгоритмы. А ещё вы узнаете, чем предсказание следующего запроса отличается от предсказания будущих интересов человека.

Как мы предсказываем будущее с помощью машинного обучения: discovery-запросы в поиске Яндекса - 1
Читать полностью »

Google Colab — это бесплатный облачный сервис на основе Jupyter Notebook. Google Colab предоставляет всё необходимое для машинного обучения прямо в браузере, даёт бесплатный доступ к невероятно быстрым GPU и TPU. Заранее предупрежу, что у него есть некоторые ограничения, поэтому вы не сможете использовать его для production.

С помощью Google Colab вы можете легко обучить свою модель за считанные секунды. Он поддерживает Python (2/3) из коробки, так что всё должно быть хорошо, верно?

Молчание вентиляторов. Google Colab, Javascript и TensorflowJS - 1

Читать полностью »

В прошлой статье мы описали эксперимент по определению минимального объема вручную размеченных срезов для обучения нейронной сети на данных сейсморазведки. Сегодня мы продолжаем эту тему, выбирая наиболее подходящую функцию потерь.

Рассмотрены 2 базовых класса функций – Binary cross entropy и Intersection over Union – в 6-ти вариантах с подбором параметров, а также комбинации функций разных классов. Дополнительно рассмотрена регуляризация функции потерь.

Спойлер: удалось существенно улучшить качество прогноза сети.

Настройка функции потерь для нейронной сети на данных сейсморазведки - 1
Читать полностью »

Существующее определение Null в Data Science сильно ограничено. Приложив немножко усилий? мы значительно улучшим обработку данных, ранее попадаемых в Null.

Читать полностью »

Мы строили-строили, и наконец построили: расписание Moscow Python Conf++ собрано, проверено, перепроверено и опубликовано. Не то чтобы работа Программного комитета на этом заканчивалась (за два-то месяца до конференции, ну-ну), но 10 месяцев явно потрачено не зря, и я с нетерпением жду результата, заложив все возможное для общения разработчиков друг с другом.

Сейчас расскажу, какой получилась программа конференции, и выбора у нас просто не останется. На площадке в центре Москвы будет: 3 потока докладов, поток воркшопов и митапов, 4 Core-разработчика (я до сих пор не знаю, считать ли Python Core-разработчиком заведующего разработкой Pytest и Hypothesis), 6 зарубежных спикеров с нетривиальным опытом, доклады от Microsoft, Wargaming, JetBrains, Parallels, EPAM, Booking.com, Tinkoff и других не менее интересных компаний. Ни одной проходной темы, я проверил. Каждый докладчик по-своему интересен, и каждая тема точно найдет тех, кому есть что обсудить со спикером. В этой статье я максимально кратко расскажу обо всех наших гостях: акцент на спикерах, по темам вы и сами сориентируетесь.

На Moscow Python Conf++ приходите поговорить с разработчиками языка - 1
Читать полностью »

Всем привет. С некоторым запозданием я решил опубликовать эту статью. Каждый год я стараюсь подвести итоги произошедшего в области обработки естественного языка (natural language processing). Не стал исключением и этот год.

BERTs, BERTs are everywhere

Начнем по порядку. Если вы не уехали в глухую Сибирскую тайгу или отпуск на Гоа на последние полтора года, то вы наверняка слышали слово BERT. Появившись в самом конце 2018-ого за прошедшее время эта модель завоевала такую популярность, что в самый раз будет вот такая картинка:

Natural Language Processing. Итоги 2019 и тренды на 2020 - 1
Читать полностью »

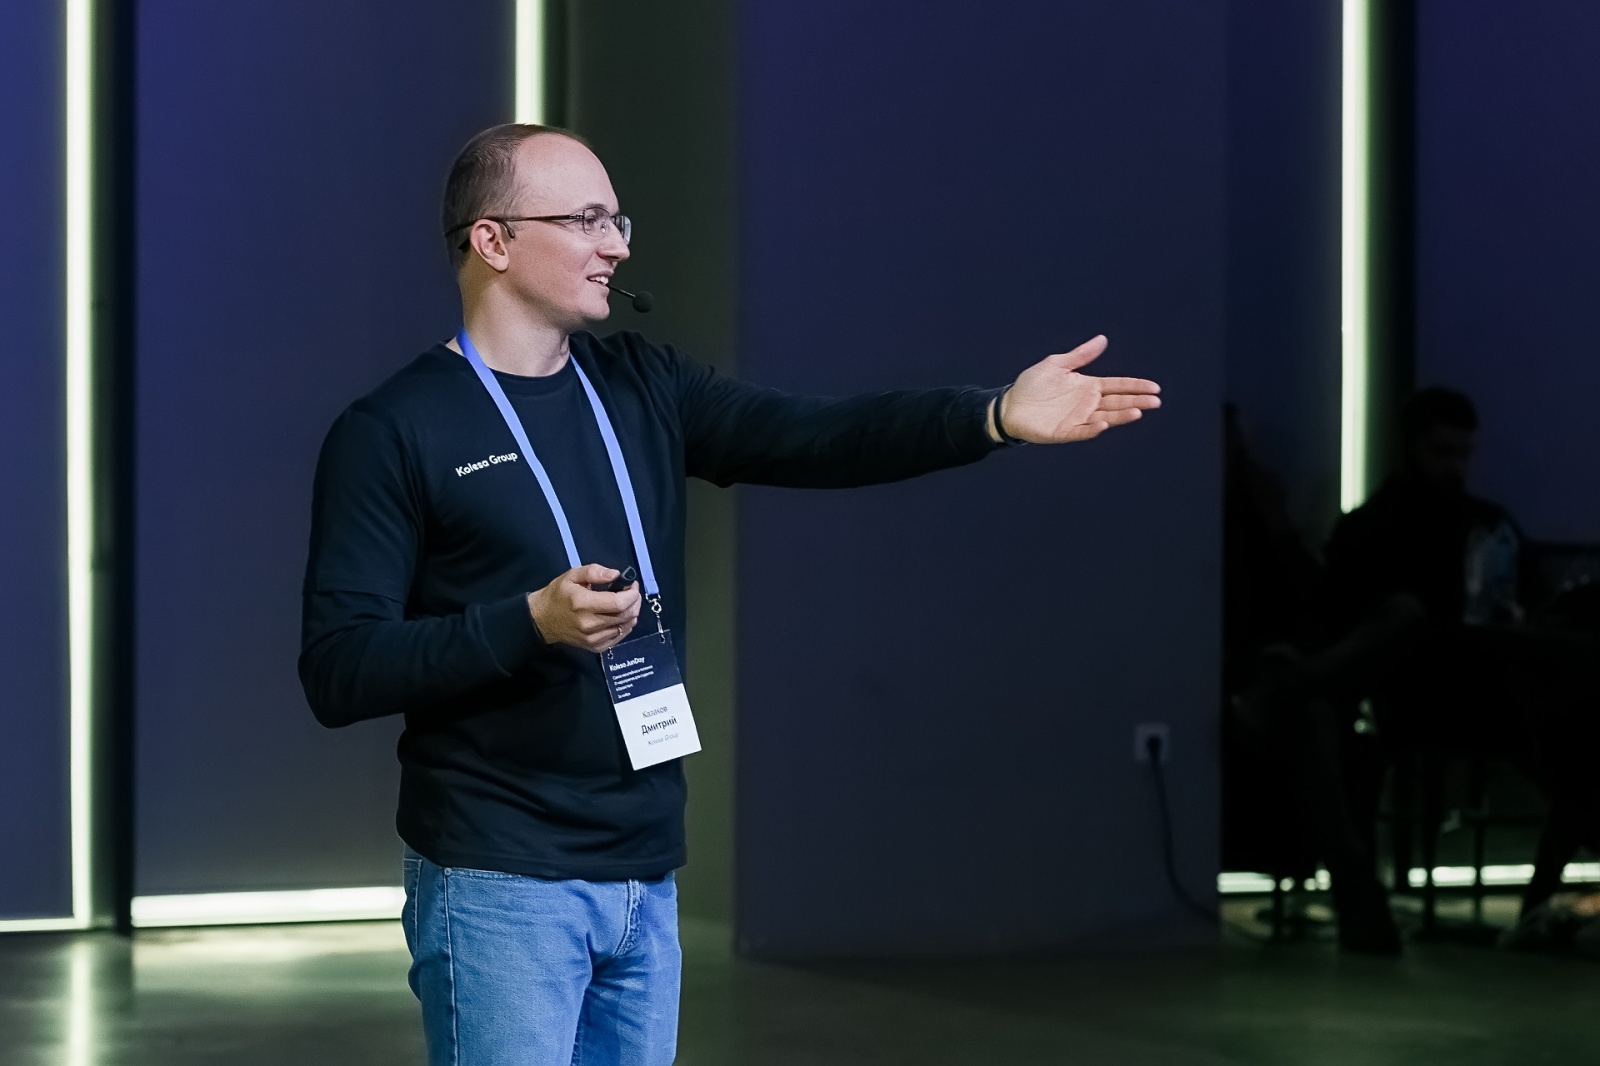
Дмитрий Казаков, Data Analytics Team Lead в Kolesa Group, делится инсайтами из первого казахстанского опроса специалистов по работе с данными.
«Да, они существуют!» Чем занимаются и сколько зарабатывают Data Science-специалисты в Казахстане? - 1
На фото: Дмитрий Казаков

Помните популярную фразу о том, что Big Data больше всего напоминает подростковый секс – все о нем говорят, но никто не знает, есть ли он на самом деле. То же самое можно было сказать и о рынке специалистов по работе с данными (в Казахстане) – хайп есть, а кто за ним стоит (и есть ли там вообще хоть кто-то), не было до конца понятно – ни эйчарам, ни менеджерам, ни самим дата-сайентистам.

Мы провели исследование, в рамках которого опросили более 300 специалистов об их зарплатах, функциях, скиллах, инструментах и много еще о чем.

Спойлер: да, они точно существуют, но все не так однозначно.

Приятный инсайт. Во-первых, специалистов по работе с данными больше чем мы ожидали. Нам удалось опросить 300 человек, среди которых есть не только product-, marketing- и BI-аналитики, но и ML-, DWH-инженеры, что особенно порадовало. В самой большой группе оказались все те, кто называет себя дата-сайентистами – это 36% опрошенных. Покрывает это запрос рынка или нет, сказать сложно, потому что сам рынок только формируется. Читать полностью »

https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js