Меня зовут Митя, и я член программного комитета PiterPy. Это классная европейская конференция по Python в северной столице.
Хотите, расскажу вам о ней?
Читать полностью »
Меня зовут Митя, и я член программного комитета PiterPy. Это классная европейская конференция по Python в северной столице.
Хотите, расскажу вам о ней?
Читать полностью »
В прошлой статье мы уже обсудили с вами причины, по которой Python нельзя назвать идеальным языком для новичков, хотя на том же Хабре бытует мнение, что Python – это выбор номер один и вообще топчик.
В этой статье мы с вами обсудим тот перечень направлений Питона, который я выделяю наиболее перспективными для приложения своих сил и времени для молодых специалистов. Данный вывод делается на основе моего анализа – изучение областей и инструментов питона и сравнивать их эффективность с аналогами на других платформах.
 Читать полностью »
На этой неделе заканчивается формирование программы третьей международной конференции Linux Piter, проходящей при поддержке Dell EMC.
Это два полных дня, 3 и 4 ноября, пятница и суббота в Питере, заполненные не всякой шелухой, а полноценными докладами про сеть, системные ресурсы, контейнеры и внутренности ядра Linux. Сугубо техническая тематика интересна всем тем, кто каждый день использует open source продукты и топовые технологии вокруг Linux в своей работе и в своих проектах.

Если кратко, то у нас 3 доклада про сетку, 5 про контейнеры, 4 про ядро, пара про производительность и еще много разного. Чтобы был понятен уровень выступлений: среди спикеров из Штатов, Германии, Швеции, Австрии и конечно же России к нам приедут Lennart Poettering (мантейнер systemd) и Christoph Hellwig (мантейнер XFS и NVM Express драйвера) – это реально круто. Будут доклады инженеров, работающих в Redhat, Intel, Microsoft (!), Ericsson, Docker и Canonical. Будут два параллельных потока с десяти утра до вечера: язык выступлений первого потока — английский (с синхронным переводом на русский для тех, кто не успевает), второго — русский (с синхронном на английский для наших иностранных гостей).
Ниже несколько анонсов выступлений в разных разделах конференции.
Приятная особенность Linux Piter #3 в том, что параллельно на этой же площадке будет проходить ещё одна наша техническая конференция — Piter Py #4, и участники смогут свободно посещать доклады любой из этих двух конференций.
Читать полностью »
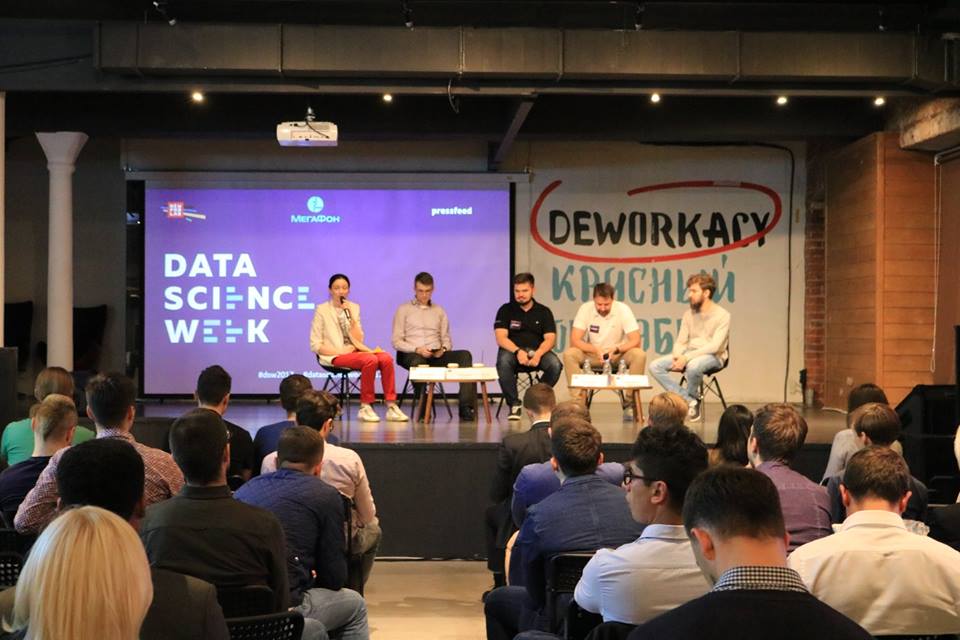
Привет! Публикуем заключительную часть обзора Data Science Week 2017, прошедшем в Москве 12-14 сентября. Сегодня расскажем о панельной дискуссии по теме “Подбор команд по работе с данными и оценка их эффективности”. Модератором выступила Ольга Филатова, вице-президент по персоналу и образовательным проектам Mail.ru Group, а участниками были Виктор Кантор (Яндекс), Андрей Уваров (МегаФон), Павел Клеменков (Rambler&Co) и Александр Ерофеев (Сбербанк).
Мы часто слышим такие словесные конструкции, как «машинное обучение», «нейронные сети». Эти выражения уже плотно вошли в общественное сознание и чаще всего ассоциируются с распознаванием образов и речи, с генерацией человекоподобного текста. На самом деле алгоритмы машинного обучения могут решать множество различных типов задач, в том числе помогать малому бизнесу, интернет-изданию, да чему угодно. В этой статье я расскажу как создать нейросеть, которая способна решить реальную бизнес-задачу по созданию скоринговой модели. Мы рассмотрим все этапы: от подготовки данных до создания модели и оценки ее качества.
Вопросы, которые разобраны в статье:
• Как собрать и подготовить данные для построения модели?
• Что такое нейронная сеть и как она устроена?
• Как написать свою нейронную сеть с нуля?
• Как правильно обучить нейронную сеть на имеющихся данных?
• Как интерпретировать модель и ее результаты?
• Как корректно оценить качество модели?
Читать полностью »
Beautiful Capi — это инструмент облегчающий создание динамических библиотек на языке С++ с внешним интерфейсом на языке Си. Данный инструмент генерирует также С++ обертки для этого Си интерфейса. Beautiful Capi написан на языке Python 3.
Основная головная боль разработчиков библиотек на С++ в отсутствии единого стандарта ABI. Различные компиляторы имеют разный ABI, соглашения о именовании, схемах перехвата исключений и т.д. Поэтому программистам на С++ приходится каждый раз брать исходники библиотеки и собирать ее при помощи нужного компилятора.
Это хорошо, если библиотека популярная, и для нее добрый дядя уже выложил бинарные файлы для большинства компиляторов С++. Опять таки, для большинства компиляторов. Компиляторов С++ достаточно много, и, если учитывать разные версии одного и того же компилятора, имеющими несовместимый ABI, то вероятность того, что уже собранная библиотека вам не подойдет — достаточно высока. Плюс, добавим к этому различные настройки компиляторов, влияющие на двоичную совместимость.
Несмотря на множество замечательных материалов по Data Science например, от Open Data Science, я продолжаю собирать объедки с пиршества разума и продолжаю делится с вами, своим опытом по освоению навыков машинного обучения и анализа данных с нуля.
В последних статьях мы рассмотрели пару задачек по классификации, в процессе потом и кровью добывая себе данные, теперь пришло время регрессии. Поскольку ничего светотехнического в этот раз под рукой не оказалось, я решил поскрести по другим сусекам.
Помнится, в одной из статей я агитировал читателей посмотреть в сторону отечественных открытых данных. Но поскольку я не барышня из рекламы «кефирчика для пищеварения» или шампуня с лошадиной силой, совесть не позволяла советовать что-либо, не испытав на себе.
С чего начать? Конечно с открытых данных правительства РФ, там же ведь целое министерство есть. Мое знакомство с открытыми данными правительства РФ, было примерно, такое же как на иллюстрации к этой статье. Нет ну не то чтобы мне совсем не был интересен реестр Кинозалов города Новый Уренгой или перечень прокатного оборудования катка в Туле, просто для задачи регрессии они не очень подходят.
Если порыться думаю и на сайте ОД правительства РФ можно найти, что-то путное, просто не очень легко.
Данные Минфина я тоже решил оставить, на потом.
Пожалуй, больше всего мне понравились открытые данные правительства Москвы, там я присмотрел пару потенциальных задачек и выбрал в итоге Сведения о регистрации актов гражданского состояния в Москве по годам
Что вышло из применения минимальных навыков в области линейной регрессии можно в краткой форме посмотреть на GitHub, ну и конечно же заглянув под кат.
Здравствуйте, сегодня я хотел бы вам рассказать о том, как сделать модель, которая хранит в себе обычные страницы, а не отдельные записи в базе данных (для ListView, TemplateView и тд). Речь пойдёт о том, как расширить и дополнить существующие в Django flatpages. Но хотелось бы рассказать о проблеме, с которой я столкнулся и почему решил поделиться данным функционалом. Часто возникает ситуация, когда в админке для администратора сайта нужно реализовать функционал самой обычной страницы (одна запись в БД – это одна страница, где прописывается url, контент и доп. инфа для конкретной страницы). Тем самым можно создавать прямо из админки новые страницы с любым url и контентом.
Читать полностью »
Данная статья написана для тех, кто только начал изучать Python. В ней я пошагово опишу создание простого счетчика слов из txt-файлов, применяя Tkinter. Исходный код написан под Python 2.7, в конце статьи я добавлю несколько комментариев относительно того, как перенести его под 3.6
Никаких незаурядных лестниц в программе не будет, так что рекомендую писать в IDLE; конечно же, без проблем можно писать и в PyCharm'е, и в Эклипсе.
Читать полностью »
Показан процесс анализа информации в сфере прикладной психологии. Если быть более точным, то я поделюсь своим опытом поиска различий между двумя группами людей. Будет показан один из самых популярных сценариев решения подобной задачи, а также приведены примеры исходного кода на языках программирования R и Python. Важно понимать, что вся изложенная информация является моим личным субъективным мнением.