

Добрый день, хаброжители. Прошло много времени с выпуска 4 версии книги по PostgreSQL — успела выйти версия 9.5 и 9.6 этой замечательной базы данных. Материалов по практическому использованию этой БД также накопилось немало, поэтому я решил выпустить обновление по книге. Итак, встречайте:«Работа с PostgreSQL: настройка и масштабирование», 5-е издание.
Рубрика «sql» - 52
Работа с PostgreSQL: настройка и масштабирование. 5-е издание
2017-03-20 в 9:03, admin, рубрики: devops, postgresql, sql, Администрирование баз данных, базы данных, книга, книга на гитхабе, книга на русском, масштабирование, настройка, хранение данных, хранилища данныхПилим каталог товаров не притрагиваясь к реляционной алгебре
2017-03-15 в 12:07, admin, рубрики: orientdb, sql, Анализ и проектирование систем, проектирование баз данных, метки: orientdbЗдравствуйте, меня зовут Дмитрий Карловский и я… давно не занимался бэкендом, но на днях вдруг наткнулся на мучения SbWereWolf по натягиванию ужа на ежа и не смог удержаться от соблазна сдуть пыль со своего мульти-инструмента OrientDB да оттяпать им чего-нибудь этакого.
Итак, мастерить мы сегодня будем базу данных для интернет-магазина с поиском товаров по параметрам, полнотекстовым поиском, локализацией, автоматическим формированием рубрикатора и мастера добавления товара.
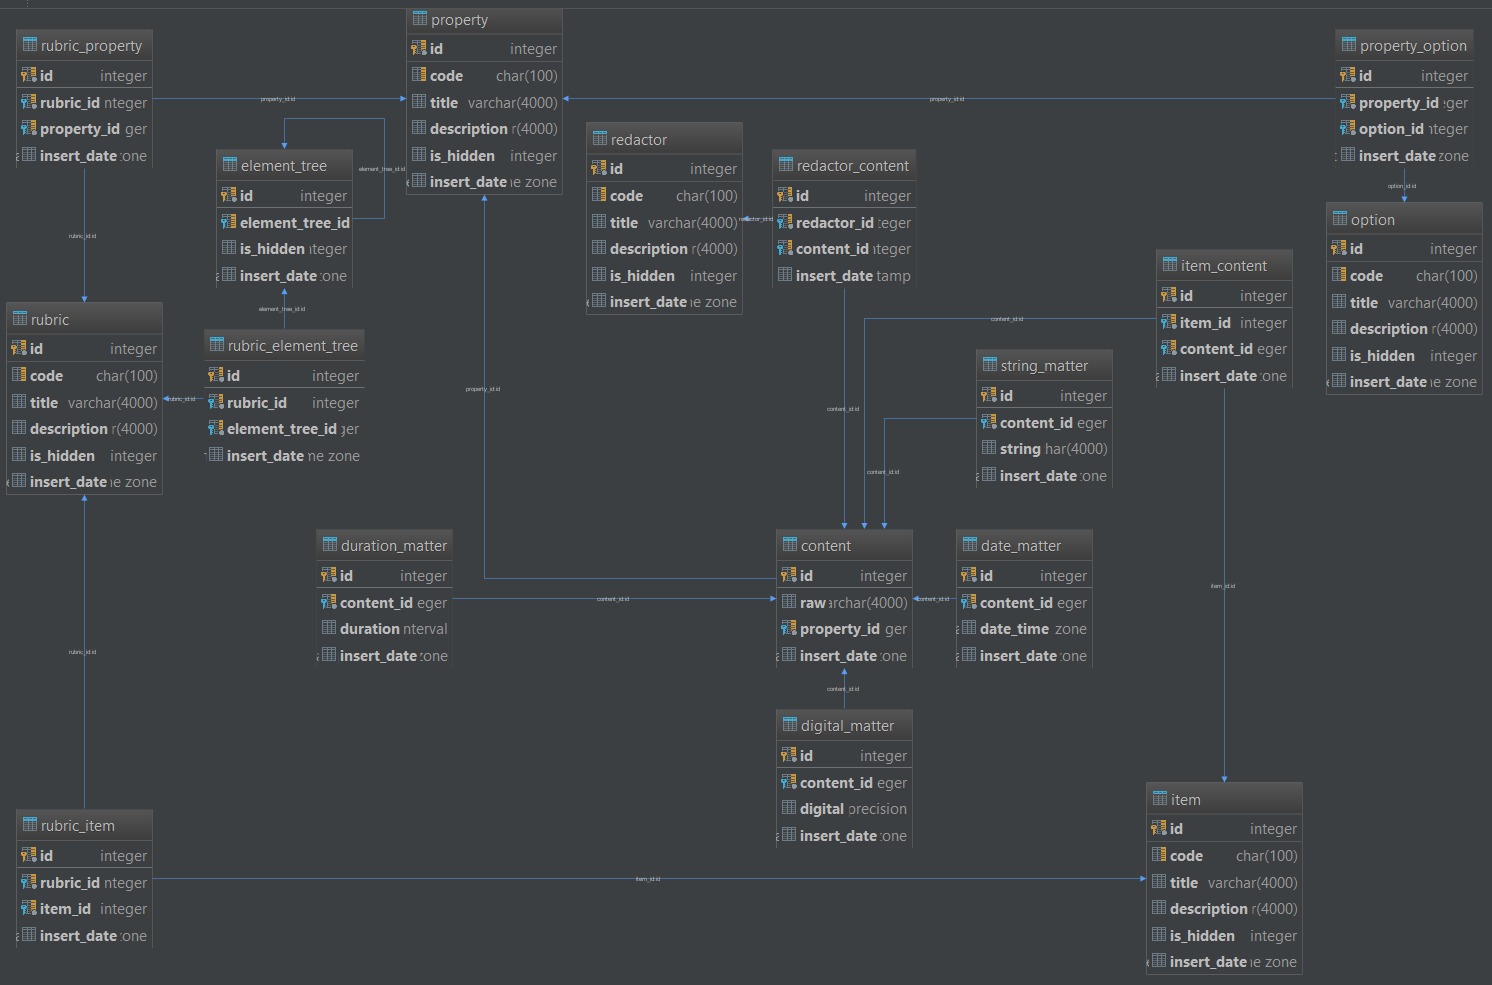
Разбирать мы будем вот этот вот реляционный звездолёт:
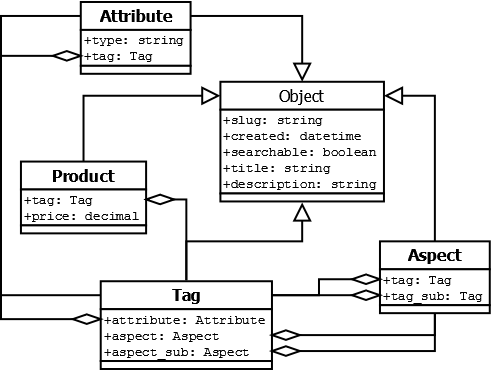
А собирать вот такой вот графовый скворечник:
Аудит изменения данных PostgreSQL
2017-03-10 в 9:00, admin, рубрики: logger, plpgsql, postgres, postgresql, sql
Возникла необходимость вести аудит изменения данных в существующей системе.
Требования:
- Простота подключения/отключения логгирования отдельных таблиц.
- Сократить до минимума изменения в уже существующих функциях БД.
- Минимизировать деградацию производительности.
Uber — причины перехода с Postgres на MySQL
2017-03-07 в 7:41, admin, рубрики: database, mysql, mysql migration, open source, postgres, postgresql, sql, uber, uber data, Блог компании centos-admin.ru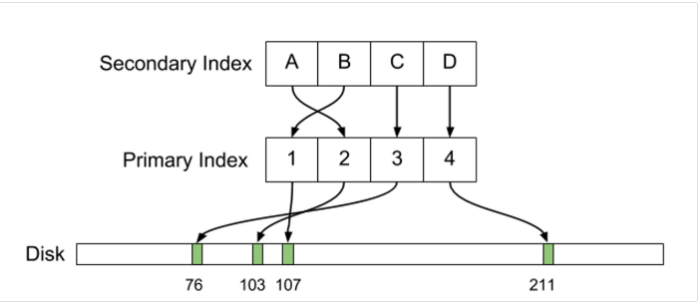
В конце июля 2016 года в корпоративном блоге Uber появилась поистине историческая статья о причинах перехода компании с PostgreSQL на MySQL. С тех пор в жарких обсуждениях этого материала было сломано немало копий, аргументы Uber были тщательно препарированы, компанию обвинили в предвзятости, технической неграмотности, неспособности эффективно взаимодействовать с сообществом и других смертных грехах, при этом по горячим следам в Postgres было внесено несколько изменений, призванных решить некоторые из описанных проблем. Список последствий на этом не заканчивается, и его можно продолжать еще очень долго.
Наверное, не будет преувеличением сказать, что за последние несколько лет это было одно из самых громких и резонансных событий, связанных с СУБД PostgreSQL, которую мы, к слову сказать, очень любим и широко используем. Эта ситуация наверняка пошла на пользу не только упомянутым системам, но и движению Free and Open Source в целом. При этом, к сожалению, русского перевода статьи так и не появилось. Ввиду значимости события, а также подробного и интересного с технической точки зрения изложения материала, в котором в стиле Postgres vs MySQL идет сравнение физической структуры данных на диске, организации первичных и вторичных индексов, репликации, MVCC, обновлений и поддержки большого количества соединений, мы решили восполнить этот пробел и сделать перевод оригинальной статьи. Результат вы можете найти под катом.
Страх и ненависть в распределённых системах
2017-02-28 в 15:48, admin, рубрики: jepsen, sql, Анализ и проектирование систем, высокая производительность, нагрузочное тестирование, отказоустойчивость, проектирование систем, распределенные системы, метки: проектирование систем, распределённые системы
Роман Гребенников объясняет сложность построения распределённых систем. Это — доклад Highload++ 2016.
Всем привет, меня зовут Гребенников Роман. Я работаю в компании Findify. Мы делаем поиск для онлайн-магазинов. Но разговор не об этом. В компании Findify я занимаюсь распределенными системами.
Что же такое распределённые системы?
Читать полностью »
ClickHouse: очень быстро и очень удобно
2017-02-27 в 17:01, admin, рубрики: clickhouse, olap, sql, Анализ и проектирование систем, высокая производительность, СУБД
Виктор Тарнавский показывает, что оно работает. Перед вами расшифровка доклада Highload++ 2016.
Здравствуйте. Меня зовут Виктор Тарнавский. Я работаю в «Яндексе». Расскажу про очень быструю, очень отказоустойчивую и супермасштабируемую базу данных ClickHouse для аналитических задач, которую мы разработали.
Пару слов обо мне. Я Виктор, работаю в «Яндексе» и руковожу отделом, который занимается разработкой аналитических продуктов, таких как «Яндекс.Метрика» и «Яндекс.AppMetrica». Я думаю, многие из вас пользовались этими продуктами и знают их. Ну, и в прошлом, и по-прежнему пишу много кода, а раньше еще занимался разработкой железа.
Читать полностью »
Переезд на Yandex ClickHouse
2017-02-26 в 16:40, admin, рубрики: clickhouse, lifestreet, open source, sql, Yandex, СУБД
Александр Зайцев отвечает на вопросы относительно переезда на Yandex ClickHouse. Это — расшифровка доклада Highload++ 2016.
Всем здравствуйте! За эти два дня на конференции было два двухчасовых митапа, сегодня даже почти трёхчасовой митап по ClickHouse. После этого Виктор с Алексеем сделали замечательный доклад, казалось бы — больше уже ничего не расскажешь. На самом деле это не так.
Я вам расскажу, как на ClickHouse переезжать, если у вас уже что-то есть. Обычно если ничего нет, то всё очень просто. Берёте и строите на новой системе. А вот если что-то есть, то это гораздо сложнее. Сейчас у вас всё хорошо. Вы поняли, что ClickHouse замечательная система. Виктор с Алексеем ответят на все вопросы, я не сомневаюсь, чтобы ещё больше уверить вас в том, что это правильное решение.
На самом деле, не всё так хорошо, как они рассказывают если вы собираетесь переезжать. Потому что ClickHouse достаточно сильно отличается от всего с чем вы имели дело в прошлом.
Всё это совершенно новый достаточно специфический опыт, он требует большой работы для того чтобы всё получилось хорошо. Какие-то простые вещи работают сразу, например, логи загрузить. А какие-то не очень простые вещи работают совсем не сразу. В конце концов, я убеждён что у всех всё получится, потому что у нас получилось. Мы прорвались через все препятствия.
Читать полностью »
Реализация ООП-наследования в классах, работающих с SQL и MS Entity Framework
2017-02-26 в 10:00, admin, рубрики: .net, C#, entity framework, sql, наследование, оопЭта статья посвящена созданию модели данных, которая красиво ложилась бы на SQL и содержала в себе «правильное» ООП наследование. Надо сказать, что эта задача возникала у меня в разное время на разных проектах, и решалась она там тоже по-разному. Названия подходов взяты из сложившейся на соответствующих проектах терминологии.
Читать полностью »
Google запустила бета-версию Cloud Spanner — СУБД поколения NewSQL
2017-02-15 в 10:01, admin, рубрики: Cloud Spanner, Google Spanner, NewSQL, nosql, sql, TrueTime API, Администрирование баз данных, Облачные вычисления, СУБД, хранилища данных, метки: Cloud Spanner, Google Spanner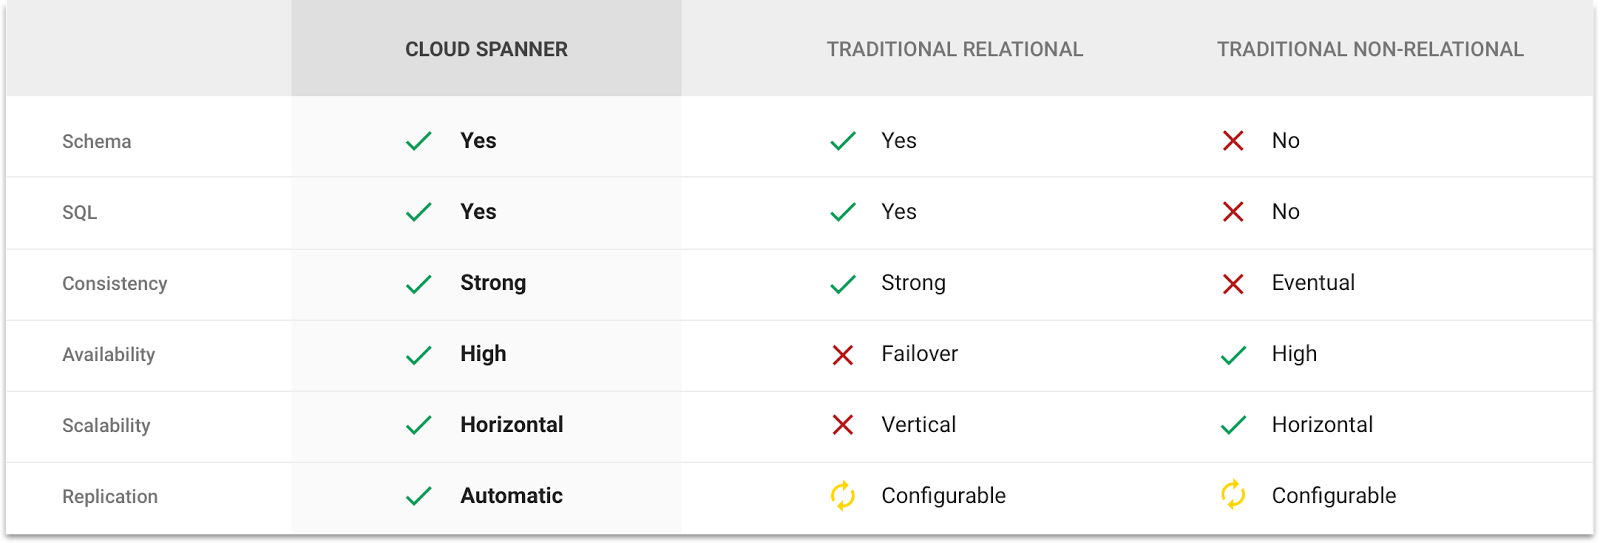
Google открыла для всех бета-версию сервиса Cloud Spanner, глобально распределённой высокомасштабируемой мультиверсионной NewSQL БД с поддержкой распределённых транзакций.
Несколько лет Google использовала этот сервис исключительно для внутренних нужд. На нём работают ключевые системы Google, в том числе AdWords и Google Play. Spanner — эволюционное развитие NoSQL-предшественника Google Bigtable. Сам же c Spanner относят к семейству NewSQL-решений, то есть оно сочетает в себе преимущества реляционных и нереляционных СУБД. Это ACID-транзакции и SQL-синтаксис традиционных СУБД без ущерба для горизонтального масштабирования и высокой доступности, присущих NoSQL.
Исходя из опыта работы системы внутри компании, Google предлагает клиентам аптайм 99,9999% (шесть девяток, то есть максимум 31,5 секунды простоя в год), клиентские библиотеки с поддержкой Java, Go, Python, Node.js и др.
Читать полностью »
Python: Работа с базой данных, часть 1-2: Используем DB-API
2017-02-14 в 20:23, admin, рубрики: db, db-api, python, sql, sqlite, ПрограммированиеPython DB-API – это не конкретная библиотека, а набор правил, которым подчиняются отдельные модули, реализующие работу с конкретными базами данных. Отдельные нюансы реализации для разных баз могут отличаться, но общие принципы позволяют использовать один и тот же подход при работе с разными базами данных.
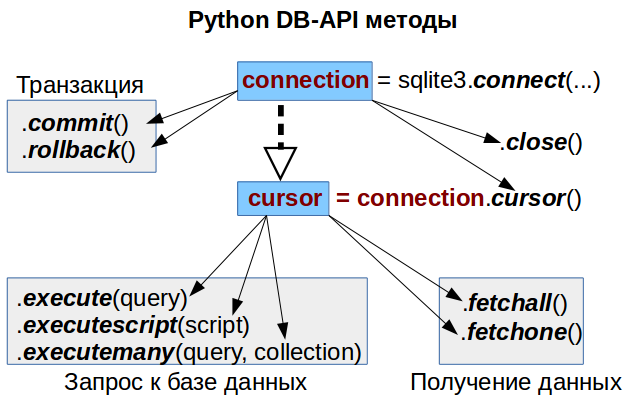
В статье рассмотрены основные методы DB-API, позволяющие полноценно работать с базой данных. Полный список можете найти по ссылкам в конец статьи.
Требуемый уровень подготовки: базовое понимание синтаксиса SQL и Python.
Читать полностью »