
Всем привет.
4 января вышла новая версия Apache Spark 1.6 с bug fix новыми возможностями обработки больших данных. На Хабре написано немало статей по использованию этого инструмента от введения до опыта использования в проектах. Spark работает на большинстве операционных систем и его можно запускать в локальном режиме даже на обычном ноутбуке. Используя простоту настройки Spark в этом случае грех не воспользоваться основными функциям. В этой статье мы посмотрим как на ноутбуке быстро настроить обработку большого файла (больше оперативной памяти компьютера) с помощью обычных SQL-запросов. Это позволит делать запросы даже неподготовленному пользователю. Дополнительное подключение iPython (Jupyter) notebook позволит составлять полноценные отчеты. В статье разобран простой пример обработки файла, другие примеры на Python есть тут.
Читать полностью »
Рубрика «big data» - 108
Spark local mode: обработка больших файлов на обычном ноутбуке
2016-01-08 в 17:20, admin, рубрики: Apache Spark, api, big data, sqlНегодяев, управляющий портфелем ФРИИ: Азбука трендов для тех, кто хочет выжить на рынке
2016-01-05 в 10:08, admin, рубрики: B2B, big data, e-commerce, O2O, авто, аналитика, венчурные фонды, инвестиции, Интернет вещей, итоги года, кейсы, колонка, маркетплейс, мобильные приложения, Нам пишут, Сергей Негодяев, советы, Стратегия, фрии, эффективность бизнесаБизнес — это не два человека с горящими глазами. Это вполне себе рутинно устроенная «машина для извлечения денег», куда в качестве топлива заливают те же деньги. О том, какие «машины» интересны инвесторам, рассказывает Сергей Негодяев, управляющий инвестиционным портфелем ФРИИ.
А — автономия
К концу 2015-го венчурный рынок стал более консервативным. Не секрет,Читать полностью »
AI, BigData & HPC Digest #3
2015-12-30 в 12:33, admin, рубрики: AI, big data, BigData, data mining, FlyElephant, high performance computing, HPC, R, анализ данных, Блог компании FlyElephant, Большие данные, видео, высокая производительность, дайджест, искусственный интеллект, Мероприятия, Новости, подкасты, статьи 
Привет!
Наша команда FlyElephant хочет поздравить всех с наступающим Новым Годом, пожелать всего самого лучшего и успешной реализации всех задуманных проектов в предстоящем году, а чтобы на выходных было что почитать, публикуем свежий номер дайджеста. Сегодня в выпуске традиционная подборка интересных ссылок на новости и материалы по направлениям: искусственный интеллект, большие данные и высокопроизводительные вычисления.
14-го января мы проведем вебинар на тему "Введение в машинное обучение", на котором поговорим об истории и основных понятиях машинного обучения. Рассмотрим популярные задачи/алгоритмы машинного обучения, а также запустим их примеры при помощи платформы FlyElephant и узнаем как возможно использовать данную платформу для решения задач искусственного интеллекта. Зарегистрироваться на вебинар можно здесь.
Читать полностью »
Numpy и многопроцессорность
2015-12-30 в 10:20, admin, рубрики: atlas, big data, BLAS, data mining, LAPACK, numpy, OpenBLAS, python Сейчас уже многие используют библиотеку numpy в своих python-программах, поскольку она заметно ускоряет работу с данными и выполнение математических операций. Однако во многих случаях numpy работает в разы медленнее, чем она может… потому что использует только один процессор, хотя могла бы использовать все, что у вас есть.
Читать полностью »
Фестиваль Данных в музее Москвы, как это было
2015-12-29 в 11:19, admin, рубрики: big data, data mining, kaggle, R, sna, Алгоритмы, алгоритмы обработки данных, анализ данных, анализ социальных сетей, Блог компании ВымпелКом (Билайн), машинное обучение, рекомендательные системы, школа данных 
Привет Хабр,
Итак, мы провели Фестиваль Данных на выставке новых технологий SMIT в Музее Москвы, о котором писали здесь.
Это первое мероприятие из серии, в которой мы собираем экспертов из разных областей бизнеса, науки и государственного управления и рассказываем про аналитику данных.
Хранение и анализ данных, которые были прерогативой узкого круга компаний и людей теперь начинают затрагивать жизнь практически всех. По этой причине мы и начали данную серию мероприятий, где мы широкой аудитории рассказываем про данные и их аналитику.
Читать полностью »
Полуавтоматическая классификация сайтов
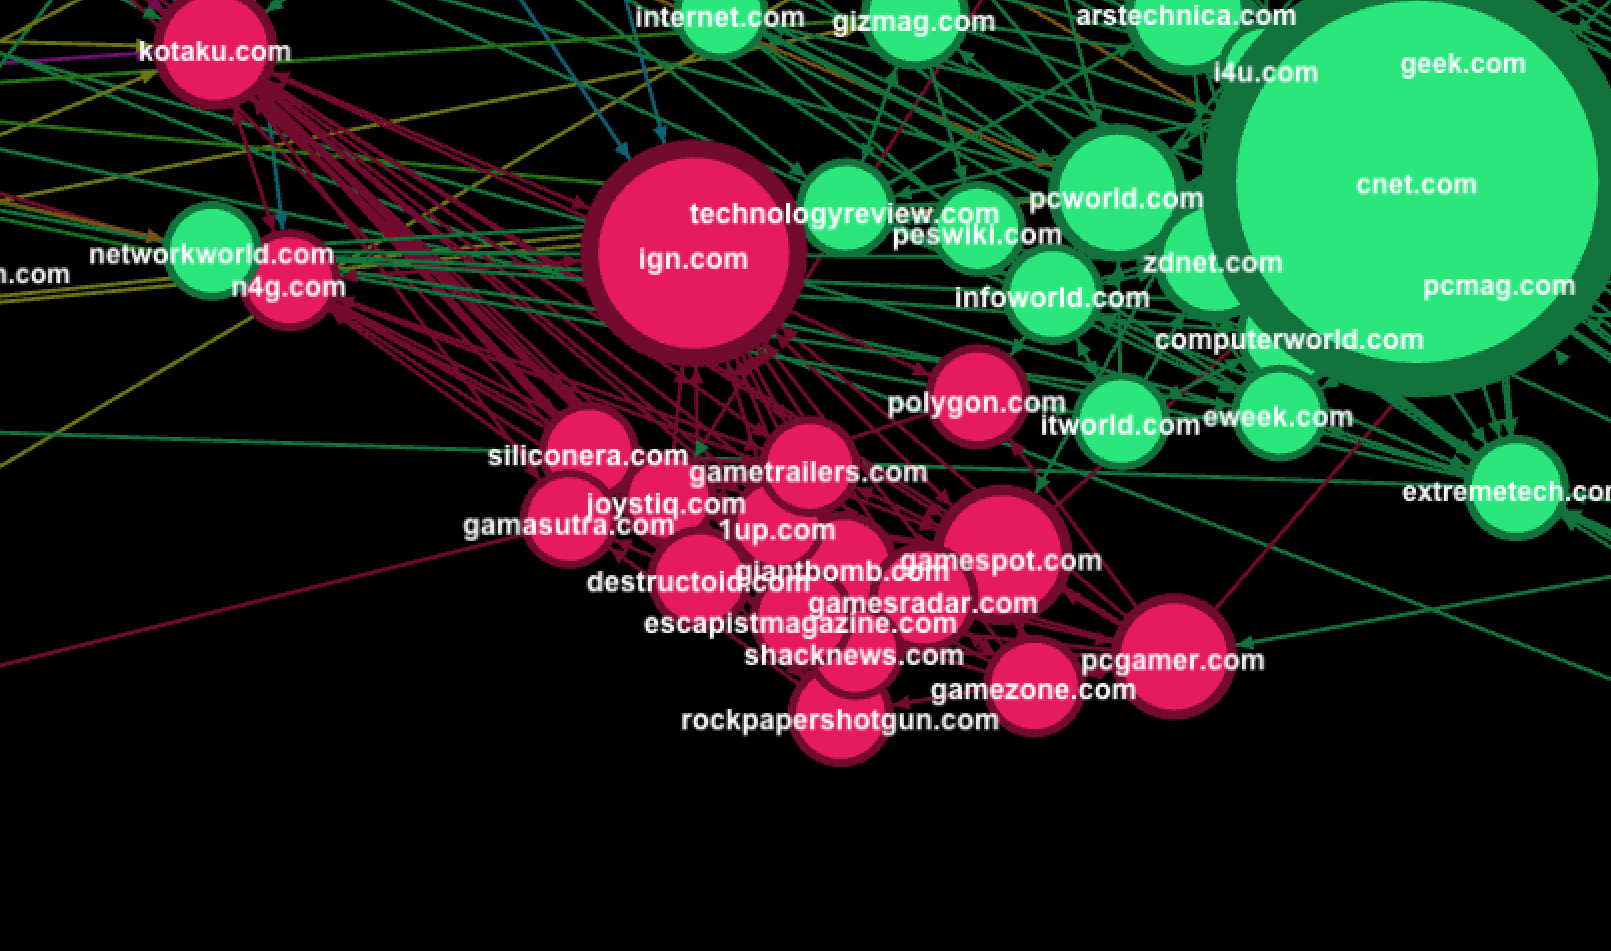
2015-12-28 в 0:07, admin, рубрики: big data, data mining, ipython notebook, визуализация данных, графы, классификация, кластеризация, сайты Рассмотрим такую задачу: есть 1000 новостных сайтов, например: engadget.com, huffingtonpost.com, sbnation.com. Их нужно распределить по классам про игры, про бизнес и финансы, про IT, про кино и музыку, например. Как это сделать? Можно просто брать один сайт за другим и назначать ему класс, но чтобы обработать таким образом 1000 сайтов нужно иметь крепкую психику и уйму времени. Можно сделать более технично: взять граф похожих сайтов, выделить интересующий подграф на 1000 вершин и кластеризовать его. Про граф похожих сайтов было написано несколько месяцев назад мной и ребятами из DCA. Граф про новостные сайты будет выглядеть примерно так:
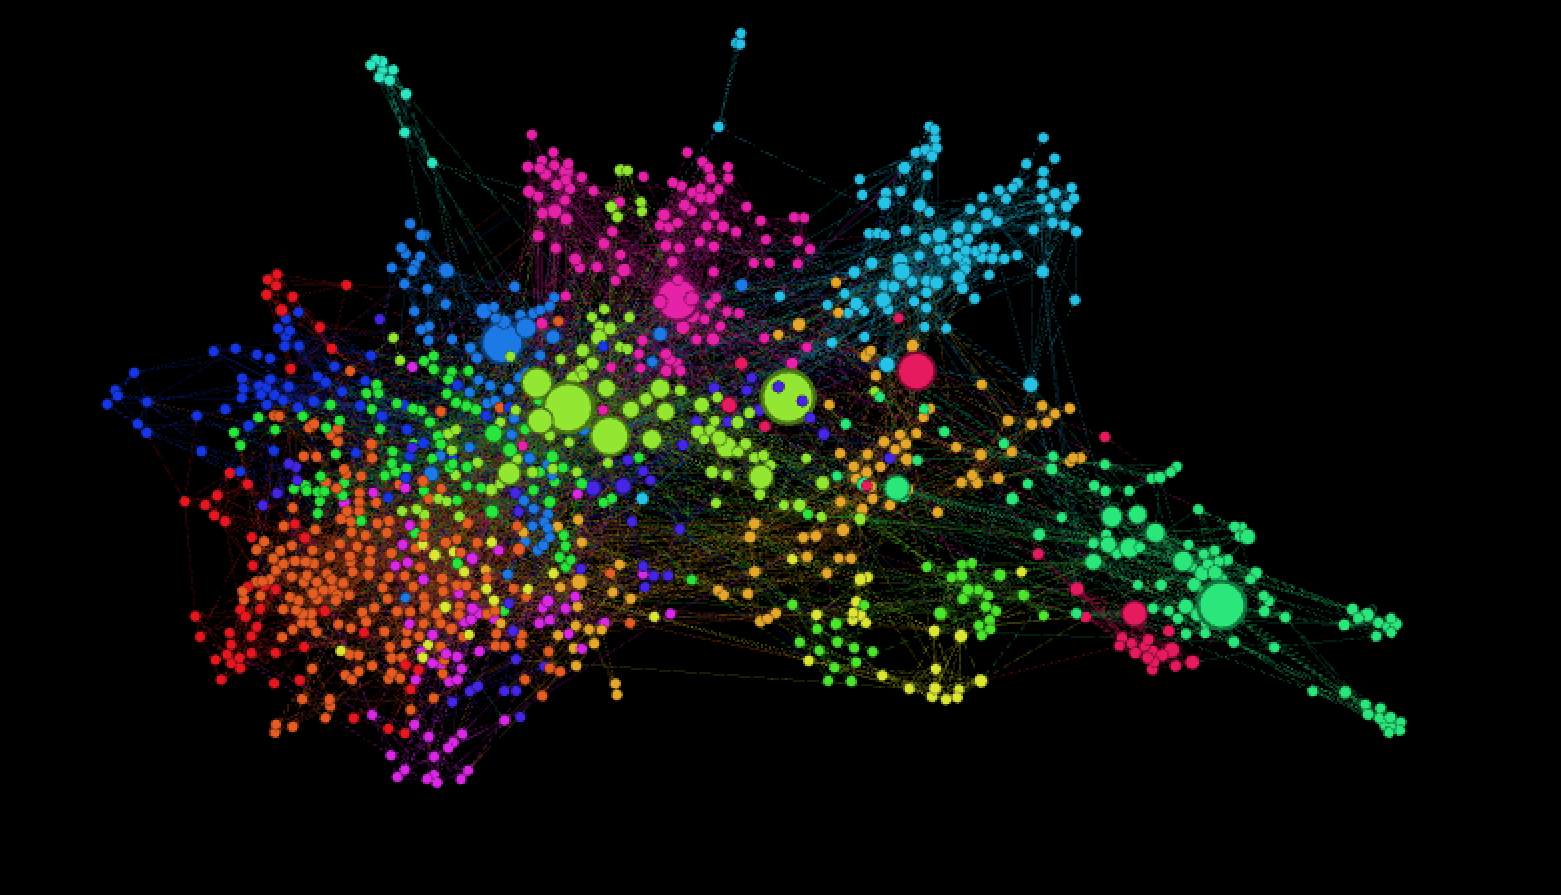
Действительно, некоторые классы получается выделить автоматически, например «игры» и «технологии»:
Читать полностью »
Интерактивная карта клиентов — Apache Spark Streaming и Яндекс.Карты
2015-12-25 в 13:41, admin, рубрики: big data, BigData, bitrix, spark streaming, битрикс, Блог компании 1С-Битрикс, Яндекс API, метки: spark streamingБигдата напирает. Бизнесу уже недостаточно уметь обрабатывать ночью накопленные за день данные и принимать решение с задержкой в сутки. Хотят, чтобы система анализировала данные в режиме онлайн и реагировала быстро на:
- изменение котировок
- действия пользователей в онлайн-игре
- отображала агрегированную информацию из соцсетей в различных проекциях
и т.д. Если вы так не умеете, то смузи уже не нальют.
Читать полностью »
Про участие в хакатоне от Билайна
2015-12-23 в 14:51, admin, рубрики: big data, data mining, абоненты, графы, смски, Хакатоны, метки: абоненты, смскиВ прошлые выходные в Музее Москвы проходила выставка, в рамках которой Билайн проводил хакатон. Я, на всякий случай, решил сходить. Была предложена интересная задача: дан граф, в вершинах абоненты, в рёбрах записано число звонков одного абонента другому, их продолжительность и число смсок. Данные выглядели вот так:
A,B,x_A,x_B,c_AB,d_AB,c_BA,d_BA,s_AB,s_BA
941235,666804,0,1,1,20,1,22,0,0
604328,367223,1,0,0,0,5,1364,0,0
932768,977234,0,0,1,168,0,0,0,0
395101,677107,0,1,1,160,0,0,0,0
250712,102647,0,0,0,0,3,456,0,0
510653,896558,0,0,139,50954,22,2990,0,0
...
Hub AI&BigData meetup #1
2015-12-23 в 12:18, admin, рубрики: AI, big data, BigData, FlyElephant, high performance computing, HPC, Hub IT School, Алгоритмы, анализ данных, Блог компании FlyElephant, Большие данные, высокая производительность, искусственный интеллект, машинное обучение, Мероприятия 
26 декабря наша команда FlyElephant примет участие во встречи Hub AI&BigData meetup, посвященной большим данным и искусственному интеллекту. Мероприятие будет проходить в Одессе и начнется в 11.00. Для всех, кто не сможет прийти, будет организована онлайн-трансляция.
Читать полностью »
Scalding: повод перейти с Java на Scala
2015-12-21 в 12:58, admin, рубрики: big data, cascading, Hadoop, java, scala, scalding 
В этой статье я расскажу о Twitter Scalding – фреймворке для описания процесса обработки данных в Apache Hadoop. Я начну издалека, с истории фреймворков поверх Hadoop. Потом дам обзор возможностей Scalding. В завершение покажу примеры кода, доступные для понимания тем, кто знает Java, но почти не знаком со Scala.
Интересно? Поехали!
Читать полностью »