
Сообщество Database & Data warehouse приглашает на свой митап, который состоится 26 сентября в офисе Райффайзенбанка в Нагатино
Рубрика «big data» - 27
DB & DWH MeetUp #5 в Райффайзенбанке
2019-09-24 в 12:38, admin, рубрики: big data, dwh, Exadata, ods, oracle, raiffeisenIT, sas, sql, tableau, Блог компании Райффайзенбанк, конференции
Структура Data Science-проекта с высоты птичьего полета
2019-09-23 в 10:17, admin, рубрики: big data, data mining, data science, data scientist, аналитика данных, методологияКак узнать наверняка, что внутри у колобка?
Может, ты его проглотишь, а внутри него река? © Таня Задорожная
Что такое Data Science сегодня, кажется, знают уже не только дети, но и домашние животные. Спроси любого котика, и он скажет: статистика, Python, R, BigData, машинное обучение, визуализация и много других слов, в зависимости от квалификации. Но не все котики, а также те, кто хочет стать специалистом по Data Science, знают, как именно устроен Data Science-проект, из каких этапов он состоит и как каждый из них влияет на конечный результат, насколько ресурсоемким является каждый из этапов проекта. Для ответа на эти вопросы как правило служит методология. Однако бОльшая часть обучающих курсов, посвященных Data Science, ничего не говорит о методологии, а просто более или менее последовательно раскрывает суть упомянутых выше технологий, а уж со структурой проекта каждый начинающий Data Scientist знакомится на собственном опыте (и граблях). Но лично я люблю ходить в лес с картой и компасом и мне нравится заранее представлять план маршрута, которым двигаешься. После некоторых поисков неплохую методологию мне удалось найти у IBM — известного производителя гайдов и методик по управлению чем угодно.
Читать полностью »
Список полезных книг по анализу данных, математике, data science и machine learning
2019-09-23 в 7:42, admin, рубрики: big data, data mining, python, искусственный интеллект, машинное обучение, полезные книгиНаписал пост, который идет строго в закладки, он со списком полезнейших книг по анализу данных, математике, data science и machine learning. Они будут полезны как новичкам, так и профессионалам. Для удобства можете читать здесь или использовать удобный google docs, в нем книги разбиты по столбцам и категориям. Пользуйтесь и прокачивайте скиллы сами + делитесь с коллегами.
Конечно, весь список книг неполный. Поэтому добавляйте в комментарии свои полезные ссылки на крутые книги, самые топовые из них я добавлю в список.
Книги по анализу данных, математике, data science и machine learning:
Книга «Дизайн-мышление. От инсайта к новым продуктам и рынкам»
2019-09-19 в 12:40, admin, рубрики: big data, Блог компании Издательский дом «Питер», инсайт, книги, мышление, проекты, Профессиональная литература, управление проектамиПривет, Хаброжители! В последние годы произошел всплеск интереса к дизайн-мышлению. Мы живем в эпоху, когда банки отказываются от традиционных банковских операций и переходят на цифровые деньги. На наших глазах рождаются стартапы, которые создают новые рынки, используя дизайн-экосистемы. Современные компании осуществляют цифровую трансформацию, чтобы по максимуму использовать современные методы обработки данных и быть на шаг впереди конкурентов. Книгу-героиню нашего сегодняшнего поста следует рассматривать как настоящую рабочую тетрадь. Это не руководство в привычном смысле, где описываются процессы.
 Книга скорее дает вдохновляющий импульс для внедрения чего-то нового и реализации полного потенциала дизайн-мышления. Эта книга о том, как действовать, тестировать и размышлять. Авторы помогут вам: применить различные инструменты и методы дизайн-мышления в конкретных ситуациях; создать эффективную команду; ориентировать продукт на пользователя; ввести дизайн-мышление в организациях; научиться создавать цифровую продукцию; объединить дизайн-мышление с Big Data. В выбранном нами отрывке пойдёт речь об эффективном тестировании прототипа:
Читать полностью »
Must-have алгоритмы машинного обучения
2019-09-18 в 8:45, admin, рубрики: big data, data mining, python, Алгоритмы, искусственный интеллект, машинное обучение, наука о данныхХабр, привет.
Этот пост — краткий обзор общих алгоритмов машинного обучения. К каждому прилагается краткое описание, гайды и полезные ссылки.
Метод главных компонент (PCA)/SVD
Это один из основных алгоритмов машинного обучения. Позволяет уменьшить размерность данных, потеряв наименьшее количество информации. Применяется во многих областях, таких как распознавание объектов, компьютерное зрение, сжатие данных и т. п. Вычисление главных компонент сводится к вычислению собственных векторов и собственных значений ковариационной матрицы исходных данных или к сингулярному разложению матрицы данных.
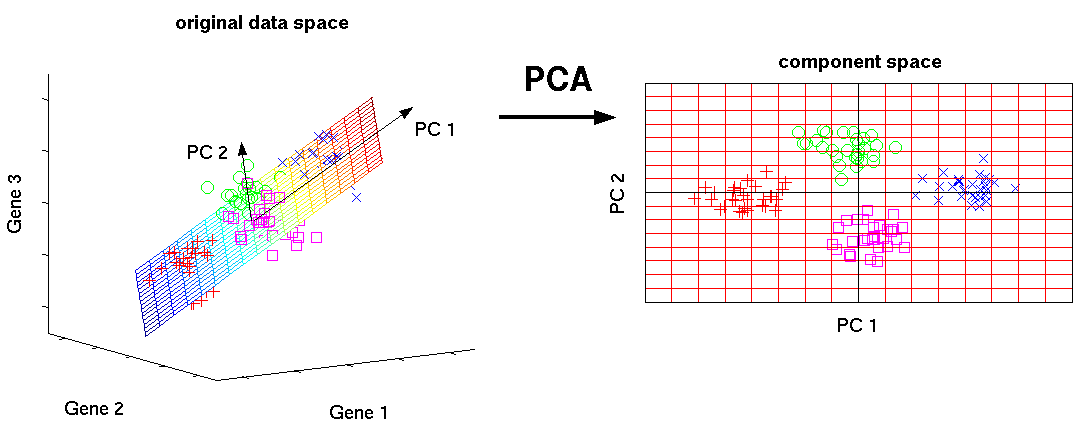
SVD — это способ вычисления упорядоченных компонентов.
Полезные ссылки:
Вводный гайд:
CQM — другой взгляд в глубоком обучении для оптимизации поиска на естественном языке
2019-09-15 в 15:22, admin, рубрики: big data, data mining, data scientis, machine learning algorithmsCQM — другой взгляд в глубоком обучении для оптимизации поиска на естественном языке
Краткое описание: Calibrated Quantum Mesh (CQM)— это следующий шаг от RNN / LSTM (Рекуррентные нейронные сети RNN (Recurrent Neural Networks) / Долгая краткосрочная память (Long short-term memory; LSTM) ). Появился новый алгоритм, называемый Calibrated Quantum Mesh (CQM), который обещает повысить точность поиска на естественном языке без использования размеченных данных обучения.
Читать полностью »
Умные алгоритмы обработки строк в ClickHouse
2019-09-12 в 9:32, admin, рубрики: big data, c++, clickhouse, open source, Алгоритмы, Блог компании Яндекс, Серверное администрирование, строкиВ ClickHouse постоянно возникают задачи, связанные с обработкой строк. Например, поиск, вычисление свойств UTF-8 строк или что-то более экзотическое, будь то поиск типа учёта регистра или поиск по сжатым данным.
Всё началось с того, что руководитель разработки ClickHouse Лёша Миловидов o6CuFl2Q пришёл к нам на факультет компьютерных наук в НИУ ВШЭ и предложил огромное количество тем для курсовых и дипломов. Когда я увидел «Умные алгоритмы обработки строк в ClickHouse» (я, человек, который увлекается разными алгоритмами, в том числе экспериментальными), сразу же настроил планов, как сделаю самый крутой диплом. Мою радость и выражение лица можно описать следующей картинкой:
Как мы промышленность и big data подружили
2019-09-12 в 7:00, admin, рубрики: BI, big data, scada, usability, Блог компании КРОК, интерфейсы, Промышленное программирование, промышленностьПриходит как-то на завод специалист по цифровизации. Здесь походил, там походил, лоб наморщил и говорит: «Я знаю, как у вас тут можно кое-что оптимизировать. Экономить конкретно будете! Дайте только мне доступ во-о-от к этим данным по производству». В ответ на заводе разводят руки. «Вот у нас по продажам аналитика. Вот по турбинам что-то есть — шибко умные турбины у Siemens. А по остальному оборудованию отродясь ничего не было».
Вы прочитали миниатюру о конфликте двух миров — промышленности и аналитики. Мы как раз из последнего, и вот как все выглядит для нас: с одной стороны — созданные для управления оборудованием и недоступные для простых смертных протоколы обмена данными с большим количеством цифр в названии. С другой — аналитические системы, красивая отчетность, удобные дэшборды и прочие приятности.
Не каждое производство дошло до технологического уровня Tesla или Foxconn. Но помогать нужно всем. На фото кадр из х/ф «Завод».
В этом посте мы расскажем, как стараемся вылепить производству человеческое (по меркам простого дата-сайентиста) лицо — дать возможность бизнес-аналитикам обрабатывать промышленные данные и пользоваться красивой BI-отчетностью.
Читать полностью »
Треугольник Паскаля vs цепочек типа «000…-111…» в бинарных рядах и нейронных сетях
2019-09-09 в 13:23, admin, рубрики: ata analysis, big data, binary Lyndon words, binomial coefficient, Binomial Theorem, boolean, data mining, machine learning, neural network, Pascal's Triangle, rules-based, tests of randomness, Алгоритмы, анализ данных, белый шум, бинарная последовательность, биномиальный коэффициент, вероятность ошибки, ГСПЧ, кластеризация данных, марковский процесс, математика, нейрон, нейронная сеть, открытые данные, ошибки первого и второго рода, Перцептрон, поиск закономерностей, последовательность, проверка гипотезы, распределение вероятностей, синапс, слова Линдона, случайный процесс, статистика, теорема Эрдёша-Реньи, треугольник Паскаля, фрактальные свойства, экспертные системыСерия «Белый шум рисует черный квадрат»
История цикла этих публикаций начинается с того, что в книге Г.Секей «Парадоксы в теории вероятностей и математической статистике» (стр.43), было обнаружено следующее утверждение:
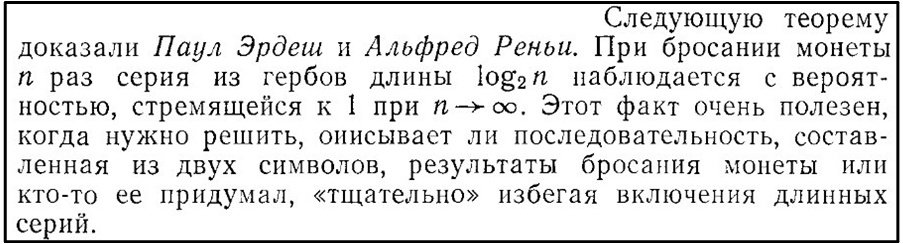
Рис. 1.
По анализу комментарий к первым публикациям (часть 1, часть 2) и последующими рассуждениями созрела идея представить эту теорему в более наглядном виде.
Большинству из участников сообщества знаком треугольник Паскаля, как следствие биноминального распределения вероятностей и многие сопутствующие законы. Для понимания механизма образования треугольника Паскаля развернем его детальнее, с развертыванием потоков его образования. В треугольнике Паскаля узлы формируются по соотношению 0 и 1, рисунок ниже.
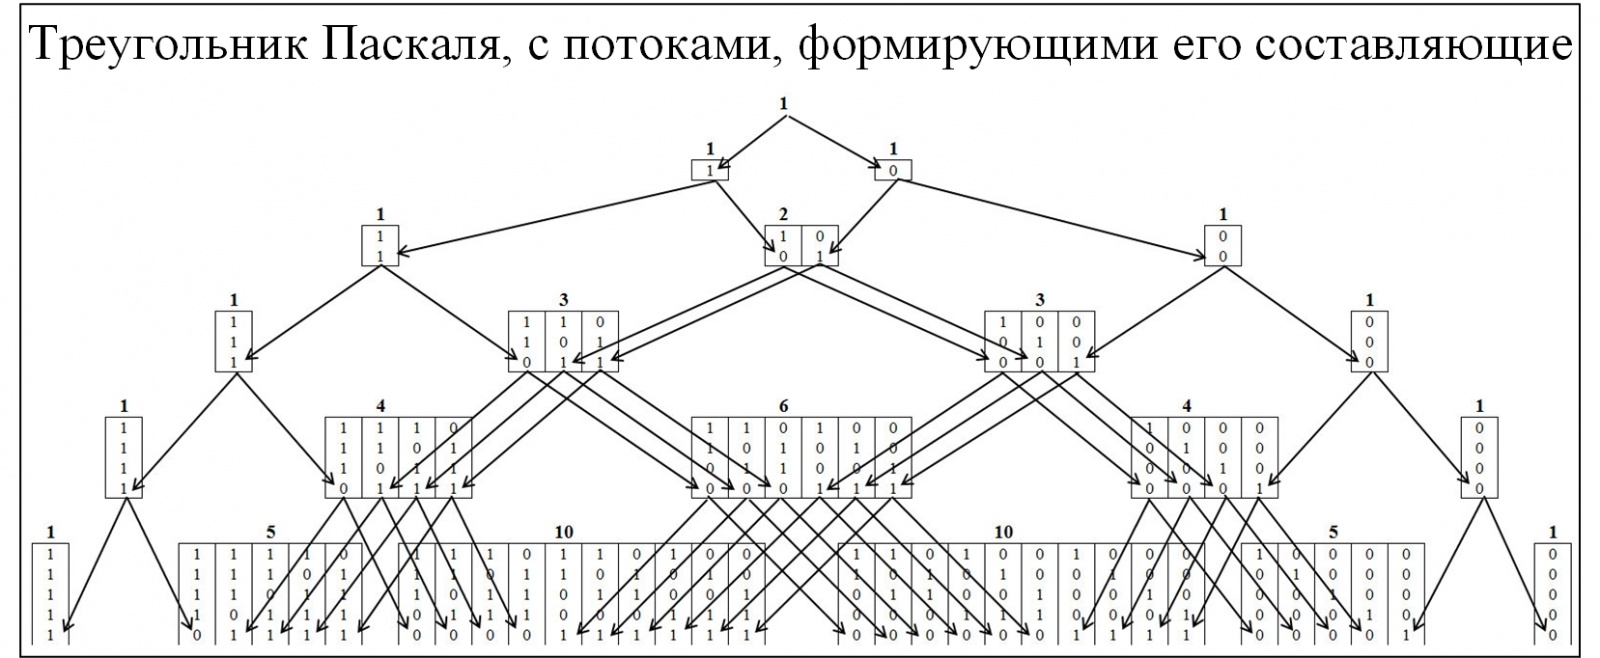
Рис. 2.
Для понимания теоремы Эрдёша-Реньи составим аналогичную модель, но узлы будут формироваться из значений, в которых присутствуют наибольшие цепочки, состоящие последовательно из одинаковых значений. Кластеризации будет проводиться по следующему правилу: цепочки 01/10, к кластеру «1»; цепочки 00/11, к кластеру «2»; цепочки 000/111, к кластеру «3» и т.д. При этом разобьём пирамиду на две симметричные составляющие рисунок 3.
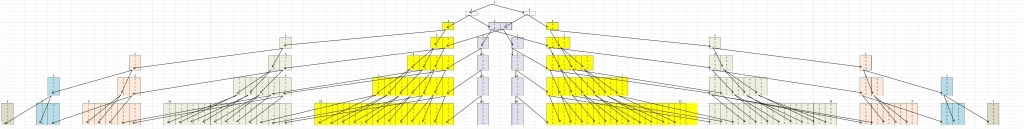
Рис. 3.
Первое что бросается в глаза это то, что все перемещения происходят из более низкого кластера в более высокий и наоборот быть не может. Это естественно, так как если цепочка размера j сложилась, то она уже не может исчезнуть.
Читать полностью »
Британская полиция привлекла ИИ для помощи в раскрытии преступлений
2019-09-06 в 10:18, admin, рубрики: big data, Законодательство в IT, искусственный интеллект, технологии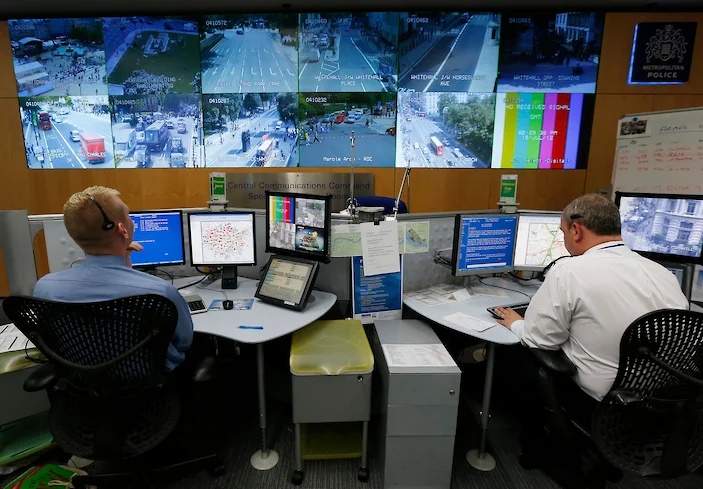
Полицейские Скотленд-Ярда применяют ИИ-технологии для расследования преступлений, когда за небольшой промежуток времени нужно обработать огромные массивы данных. Если раньше у человека или целой команды на это могло уйти несколько месяцев, то сейчас тратятся считанные часы. Правда, о повсеместном применении технологии речь пока не идет — ИИ помогает лишь одному специализированному подразделению.
Это hi-tech лаборатория, в которой полицейские работают с разнообразной техникой, пытаясь получить доступ к уликам. Здесь работает более 150 человек, каждый из которых ежедневно тратит большое количество времени на изучение текстовых материалов и мультимедиа-контента.
Читать полностью »