Рубрика «big data» - 32

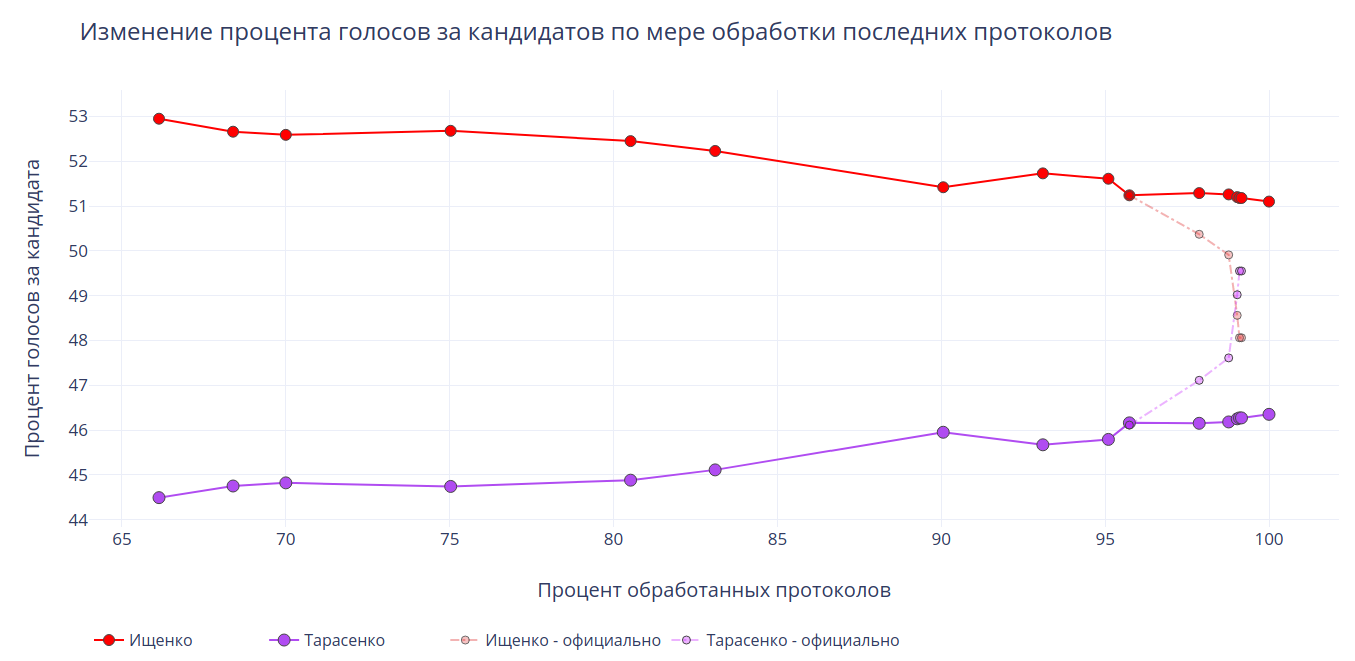
Во втором туре выборов губернатора Приморского края 16 сентября 2018 года встречались действующий и.о. губернатора Андрей Тарасенко и занявший второе место в первом туре коммунист Андрей Ищенко. В ходе подсчета голосов на сайте ЦИК РФ отображалась информационная панель с растущим числом обработанных протоколов и голосов за кандидатов.

Публикация подробных данных по участкам на официальном сайте ЦИК www.izbirkom.ru замерла после ввода 1484 (95.74%) протоколов и не возобновлялась до самого конца. Поэтому когда в трансляции лидер голосования вдруг поменялся с Ищенко на Тарасенко, было неясно, как именно это могло произойти. В СМИ просто писали «после обработки 99,03% протоколов лидер сменился».

Однако, располагая промежуточными суммарными данными из информационной панели, с помощью простой математики и программирования можно подробно установить, что именно происходило с протоколами в ночь после выборов. Используем Python, Colab от Google и Z3 theorem prover от Microsoft Research. Ну и добьём всё обычной дедукцией.
Математическое расследование, как подделывали выборы губернатора в Приморье 16 сентября 2018 года - 1
Читать полностью »

Не так давно я столкнулся с задачей по переходу на новую BI-систему для нашей компании. Поскольку мне пришлось погрузиться довольно глубоко и основательно в данный вопрос, я решил поделиться с уважаемым сообществом своими мыслями на этот счет.

image
На просторах интернета есть немало статей на эту тему, но, к моему большому удивлению, они не ответили на многие мои вопросы по выбору нужного инструмента и были несколько поверхностны. В рамках 3 недель тестирования мы опробовали 4 инструмента: Tableau, Looker, Periscope/Sisense, Mode analytics. Про эти инструменты в основном и пойдет речь в данной статье. Сразу оговорюсь, что предложенная статья — это личное мнение автора, отражающее потребности небольшой, но очень быстро растущей IT-компании :)

Несколько слов о рынке

Сейчас на рынке BI происходят довольно интересные изменения, идёт консолидация, крупные игроки облачных технологий пытаются укрепить свои позиции путем вертикальной интеграции всех аспектов работы с данными (хранение данных, обработка, визуализация). За последние несколько месяцев произошло 5 крупных поглощений: Google купил Looker, Salesforce купил Tableau, Sisense купил Periscope Data, Logi Analytics' купил Zoomdata, Alteryx купил ClearStory Data. Не будем дальше погружаться в корпоративный мир слияний и поглощений, стоит лишь отметить, что можно ожидать дальнейших изменений как в ценовой, так и в протекционистской политике новых обладателей BI-инструментов (как недавно нас обрадовал инструмент Alooma, вскоре после покупки их компанией Google, они перестают поддерживать все источники данных, кроме Google BigQuery :) ).

Читать полностью »

Отчет с PyDaCon meetup в Mail.ru Group, 22 июня - 1

В конце июня, в московском офисе прошел митап на котором собрали 2 секции: доклады по Python, состав которого был сформирован на основе общего списка докладов к PyCon Russia и PyData-трек от PyData Moscow meetup. Под катом собрали презентации, записи докладов и небольшие комментарии.
Читать полностью »

Привет, читатель.

По стопам моего первого поста подборки датасетов для машинного обучения — сделаю подборку относительно свежих датасетов с рабочими примерами по обработке данных. Ведь ни для кого не секрет, что обучение на хороших примерах проходит эффективнее и быстрее. Посмотрим, что интересного нам смогут показать одни из лучших примеров по обработке данных.

Схема работы с текущим постом унаследуется от моего поста про лучшие блокноты по ML и DS, а именно — сохранил в закладки → передал коллеге.

+ бонус в конце статьи — крутой курс от ФПМИ МФТИ.

image

Итак, давайте приступим.

Подборка датасетов с рабочими примерами обработки данных:

Suicide Rates Overview 1985 to 2016 — сравнение социально-экономической информации с показателями самоубийств по годам и странам.

Примеры обработки:

Читать полностью »

image

Так выглядит банк изнутри. Данная визуализация в три этапа основана на реальных клиентских операциях банка с отозванной лицензией.

В качестве источника данных — главная бухгалтерская книга банка. Используя теорию графов, выделяем всех его клиентов в качестве узлов, а операции по счёту используем как ребра. Сумма операции, в таком случае, будет являться весом ребра.
Читать полностью »

Хотите узнать о трех методах получения данных для своего следующего проекта по ML? Тогда читайте перевод статьи Rebecca Vickery, опубликованной в блоге Towards Data Science на сайте Medium! Она будет интересна начинающим специалистам.

Извлечение данных при машинном обучении - 1

Получение качественных данных — это первый и наиболее важный шаг в любом проекте по машинному обучению. Специалисты Data Science часто применяют различные методы получения датасетов. Они могут использовать общедоступные данные, а также данные, доступные по API или получаемые из различных баз данных, но чаще всего комбинируют перечисленные методы.

Цель этой статьи — представить краткий обзор трех разных методов извлечения данных с использованием языка Python. Я расскажу, как делать это с помощью Jupyter Notebook. В своей предыдущей статье я писала о применении некоторых команд, запускаемых в терминале.Читать полностью »

«Яндекс не использует и не планирует использовать запатентованную компанией технологию, которая может выявлять заработок пользователей мобильных устройств по профессиям и по тому, какими сервисами они пользуются», — заявила пресс-служба поисковика.

Ранее днём «Известия» сообщили, что поисковик в 2017-м подал заявку, Читать полностью »

Любой аналитик, в начале своей работы, проходит ненавистный этап определения идентификации параметров распределения. Потом, с наработкой опыта, для него согласование полученных остаточных разбросов означает, что какой-то этап, в анализе Big Data, пройден и можно двигаться дальше. Уже нет необходимости проверять сотни моделей на соответствие различным уравнениям регрессии, искать отрезки с переходными процессами, составлять композицию моделей. Терзать себя сомнениями: «Может есть, еще какая-нибудь модель, которая больше подходит?»
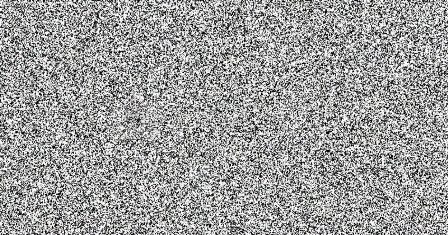
Подумал: «А что, если пойти от противного. Посмотреть, что может сделать белый шум. Может ли белый шум создать, что-то, что наше внимание сопоставит со значимым объектом из нашего опыта?»
Белый шум рисует черный квадрат - 1
Рис. Белый шум (файл взят из сети, размер 448х235).

По этому вопросу рассуждал так:
1. Какова вероятность, что появится горизонтальные и вертикальные линии, заметной длины?
2. Если они могут появиться, то какова вероятность, что они совпадут своим началом по одной из координат и составят прямоугольную фигуру?
Дальше по тексту, объясню, как эти задачи связались с анализом Big Data.
Читать полностью »

ok.tech: Data Толк #2 - 1

7 августа в московском офисе Одноклассников состоится ok.tech: Data Толк #2, в этот раз мероприятие будет посвящено образованию в Data Science. Ни для кого не секрет, что сейчас вокруг работы с данным такой хайп, что только ленивый не задумывался над получением образования в области датасаенса. Кто-то считает, что без университетского образования стать датасаентистом – невозмножно, есть сторонники мнения, что можно обучиться работе с данными с помощью курсов, другие придерживаются позиции что хороший датасаентист это – практика и разносторонний подход. Мы соберем на своей площадке представителей разных мнений и дадим им возможность подискутировать на эту тему. Мероприятие пройдет в формате дискусси между спикерами, в этот раз с нами будут Евгений Соколов (ВШЭ, Яндекс.Дзен), Дмитрий Бугайченко (OK.ru), Пётр Ермаков (Lamoda, DataGym), Дмитрий Коробченко (Nvidia, GeekBrains, SkillBox, Digital October) и Виктор Кантор (Mail.ru Group). Мы приглашаем всех, кому интересна тема образования в DataScience присоединиться к мероприятию и высказать свою точку зрения. Учились на курсах, приходите и расскажите что это вам дало, считаете, что без PHD в анализе данных нельзя, приходите и расскажите почему, считаете, что датасентист должен уметь писать в прод, приходите – обсудим.

→ Регистрация на меропритие

Под катом мнения экспертов и расписание.
Читать полностью »

Привет, читатель.

Представляю пост который идёт строго (!) в закладки и передаётся коллегам. Он с подборкой примечательных файлов формата Jupyter Notebook по Machine Learning, Data Science и другим сферам, связанным с анализом данных. Эти блокноты Jupyter, будут наиболее полезны специалистам по анализу данных — как обучающимся новичкам, так и практикующим профи.

image

Итак, приступим.

Вводные курсы в Jupyter Notebook

Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js