Рубрика «big data» - 33

Привет, читатель. Думаю, что ненужно рассказывать в который раз о том, что такое искусственный интеллект, какую пользу он несёт и для чего нужен. Перейду сразу к делу. Ниже собрал подборку сервисов на основе ИИ, которые могут упростить вам жизнь уже сегодня.

Свою статью я разделю на 3 части:

  • ИИ инструменты для личного использования;
  • Инструменты ИИ для бизнеса;
  • Инструменты ИИ для отраслевых бизнесов.

Меньше слов, больше данных.

image

Подборка сервисов на основе ИИ для личного использования:

Дом

  • Bridge Kitchen — помощник на кухне для пошагового приготовления еды;
  • UnifyID — автоматическая аутентификация пользователя в цифровой и физической среде.

Читать полностью »

Большие данные (big data) создали новые возможности для посткапиталистического будущего. Но, чтобы ими воспользоваться, нашей демократии нужно подрасти.

image

Когда СССР распался, вопрос экономического планирования, казалось, был решён раз и навсегда. В борьбе рынка и плана, рынок одержал решительную победу. Спустя тридцать лет после падения берлинской стены, вердикт больше не так однозначен. По всему миру нарастают академические и политические диспуты об экономическом планировании

От переводчика: технологии меняют жизнь, даже некоторые, незыблемые ранее, положения экономики могут пасть. Вашему вниманию — краткая заметка о том, почему экономическое планирование снова на слуху.

Среднее время чтения: 5 минут

Читать полностью »

По данным WSJ, власти США одобрили соглашение с компанией Марка Цукерберга о выплате штрафа для урегулирования скандала с утечкой данных через компанию Cambridge Analytica [Roem.ru: термин «утечка» в данном случае политизированный шаблон, а не IT-шный факт]. Это рекордная сумма для технологических компаний в Штатах, передал РБК.

Cambridge Analytica, Читать полностью »

Всем привет.

Поработав в 12 стартапах в сфере машинного обучения, я сделал восемь полезных выводов о продуктах, данных и людях.

Все стартапы были из разных сфер (финтех, биотехнологии, здравоохранение, технологии обучения) и на разных этапах: и на этапе pre-seed, и на этапе приобретения крупной компанией. Менялась и моя роль. Я был стратегическим консультантом, главой отдела анализа данных, заваленный делами штатным сотрудником. Все эти компании старались создать хороший продукт, и многим это удалось.

За время работы я пришел к таким выводам:

Продукт важнее ИИ

Эти стартапы разрабатывают продукты, а не изучают искусственный интеллект. Меня, как убежденного математика, сначала больше интересовало машинное обучение и создание новых методов и алгоритмов.

Вскоре я понял, что даже точные модели машинного обучения не ценны сами по себе. Ценность ИИ и машинного обучения напрямую зависит от ценности продукта, в котором они используются. Цель стартапа – научиться создавать продукты, основанные на машинном обучении.

При таком подходе иногда выясняется, что машинное обучение – не самый эффективный инструмент. Иногда дело не в поставленной задаче, а в процессе решения. Даже в таких ситуациях полезно обратиться к ученым: они используют научный, основанный на данных подход. Тем не менее, не тратьте время на ИИ там, где нужно исправить процесс. Читать полностью »

Сегодня возникла потребность в мониторинге изменений определенных файлов на сервере, существует много разных способов например osquery от facebook, но так как недавно я начал пользоваться Open Distro for Elasticsearch решил мониторить файлы эластиком, одним из его beat'ов.

Читать полностью »

Всем привет. Открыт набор на новый курс от Otus — "Прикладная аналитика на R", который стартует уже в конце этого месяца. В связи с этим хочу поделиться переводом публикации о разнице между аналитиком по данным и статистиком, который в свою очередь использует R на практике.

Введение

За последние десять лет объемы данных и скорость их появления росли по экспоненте. Если верить отчетам, каждый день появляется более 3 квинтиллионов байтов данных! Неудивительно, что для работы с ними появилась новая профессия исследователя данных (data scientist) — разностороннего специалиста по анализу и обработке данных. Однако люди занимались статистикой и до появления цифровых средств обработки данных. В чем же различия этих двух профессий: исследователь данных и статистик?

Давайте разберемся.

Читать полностью »

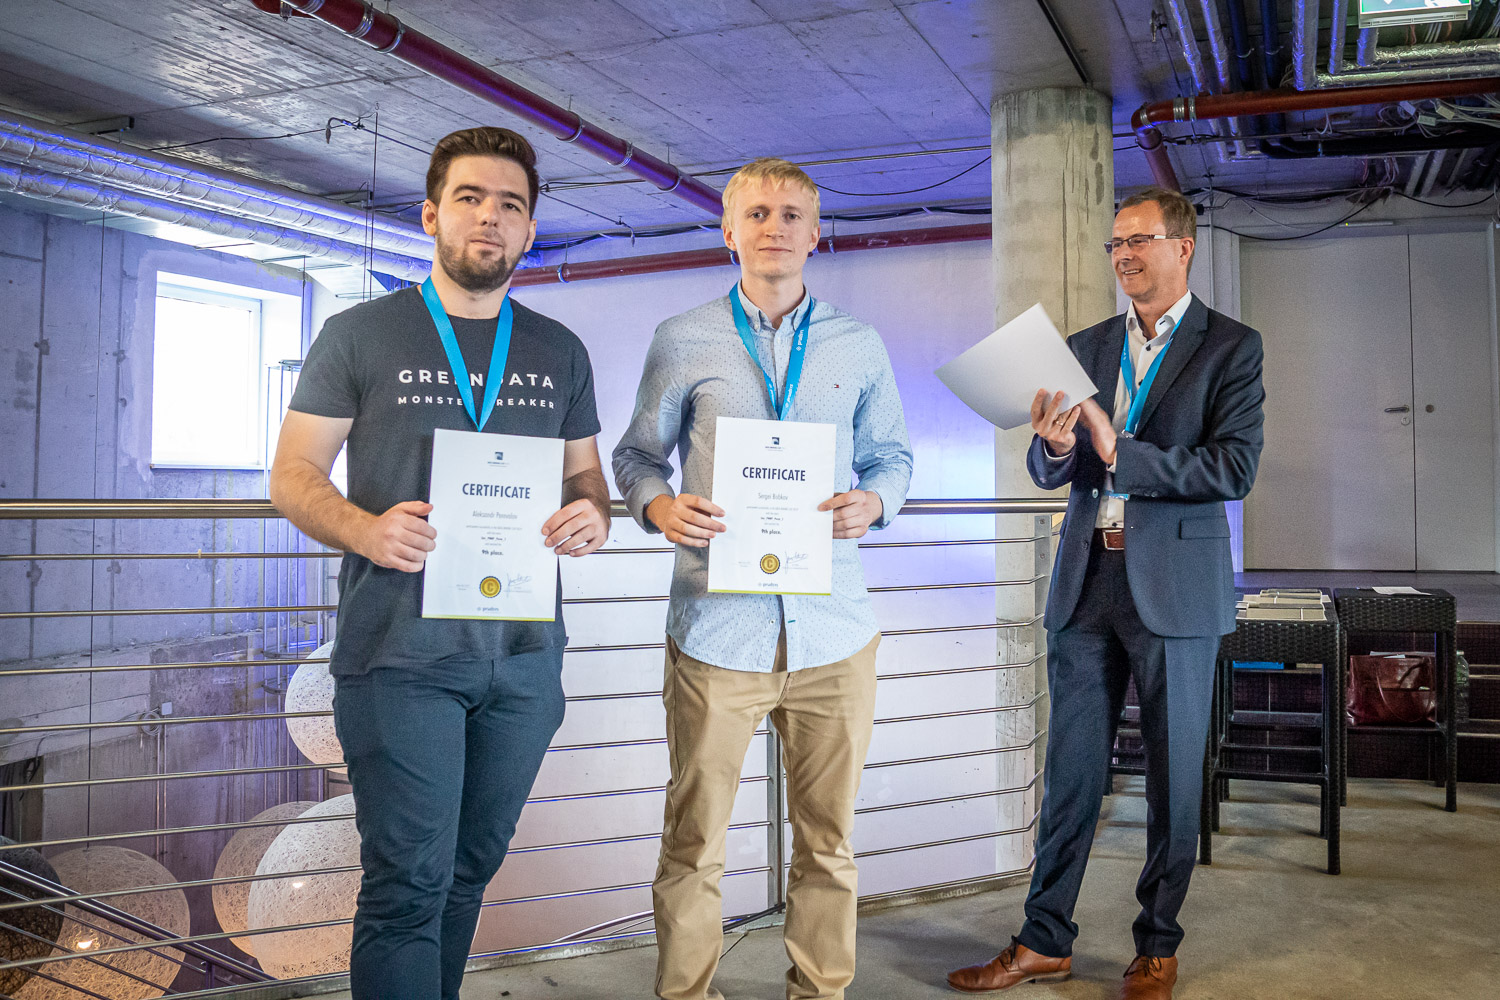
Всем привет. В этой статье я расскажу о нашем опыте участия в соревновании по анализу данных Data Mining Cup 2019 (DMC) и о том, как нам удалось войти в ТОП-10 команд и принять участие в очном финале чемпионата в Берлине.

image
Читать полностью »

Что делать, если ваш запрос к базе выполняется недостаточно быстро? Как узнать, оптимально ли запрос использует вычислительные ресурсы или его можно ускорить? На последней конференции HighLoad++ в Москве я рассказал об интроспекции производительности запросов — и о том, что даёт СУБД ClickHouse, и о возможностях ОС, которые должны быть известны каждому.

Анализ производительности запросов в ClickHouse. Доклад Яндекса - 1

Каждый раз, когда я делаю запрос, меня волнует не только результат, но и то, что этот запрос делает. Например, он работает одну секунду. Много это или мало? Я всегда думаю: а почему не полсекунды? Потом что-нибудь оптимизирую, ускоряю, и он работает 10 мс. Обычно я доволен. Но все-таки я стараюсь в этом случае сделать недовольное выражение лица и спросить: «Почему не 5 мс?» Как можно выяснить, на что тратится время при обработке запроса? Можно ли его в принципе ускорить?

Читать полностью »

Машинное обучение vs. аналитический подход - 1

Какое-то время назад мы нашли свои старые материалы, по которым обучали первые потоки на наших курсах машинного обучения в Школе Данных и сравнили их с теперешними. Мы удивились, сколько всего мы добавили и поменяли за 5 лет обучения. Осознав, почему мы это сделали и как, на самом деле, поменялся подход к решению задач Data Science, мы решили написать вот эту публикацию.Читать полностью »

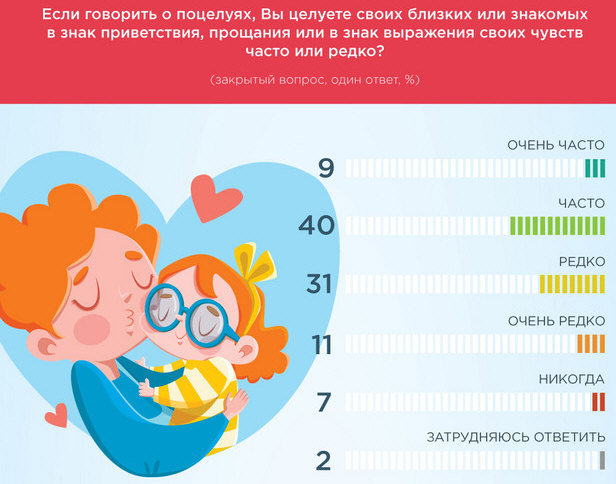
Все мы участвовали в опросах, онлайн или в реальной жизни. А когда начинаем новый проект, то без опросов не обойтись. Но иногда есть результаты опросов, с которыми непонятно что делать, кроме как улыбнуться, ниже, на картинке, результат опроса Всероссийского центра изучения общественного мнения (ВЦИОМ).
Как сравнить: «изумительный авто» и «уродливый барак», в маркетинговом опросе и в больших данных - 1
Полюбопытствовал как сейчас используют вопросы с качественными оценками и обнаружил, что ВЦИОМ, ФОМ, Левада-Центр используют, в основном, трехдиапазонную шкалу (плохо/норма/хорошо). В случаях более детальных вопросов, шкала увеличивается до 5-6 единиц, но редко.
Как сравнить: «изумительный авто» и «уродливый барак», в маркетинговом опросе и в больших данных - 2
Тогда, на сегодняшний день, складывается ситуация, в которой социологи уходят от многоуровневой шкалы качественных оценок и стараются использовать трехуровневую. И если социология умеет из этого выворачиваться, то при анализе приличных объемов данных, необходимость использования качественных оценок становится усложняющим фактором и снижает надежность результатов. Так как разграничить, например, понятия: «прекрасная квартира» и «отличное жилье» практически невозможно, а с учетом ответа, одного из персонажей «Двенадцати стульев»: «Кому и кобыла невеста», многопересекаемость качеств выходит за разумные пределы.
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js