Рубрика «big data» - 35

Привет! Представляю вашему вниманию перевод статьи «Image Similarity using Deep Ranking» автора Akarsh Zingade.

Алгоритм Deep Ranking

Понятия "сходства двух изображений" — введено не было, поэтому давайте введем данное понятие хотя бы в рамках статьи.

Сходство двух изображений — это результат сравнения двух изображений по определенным критериям. Его количественная мера определяет степень сходства между диаграммами интенсивности двух изображений. С помощью меры сходства сравниваются какие-то признаки, описывающие изображения. В качестве меры сходства обычно применяется: расстояние Хемминга, евклидово расстояние, расстояние Манхэттена и т. д.
Читать полностью »

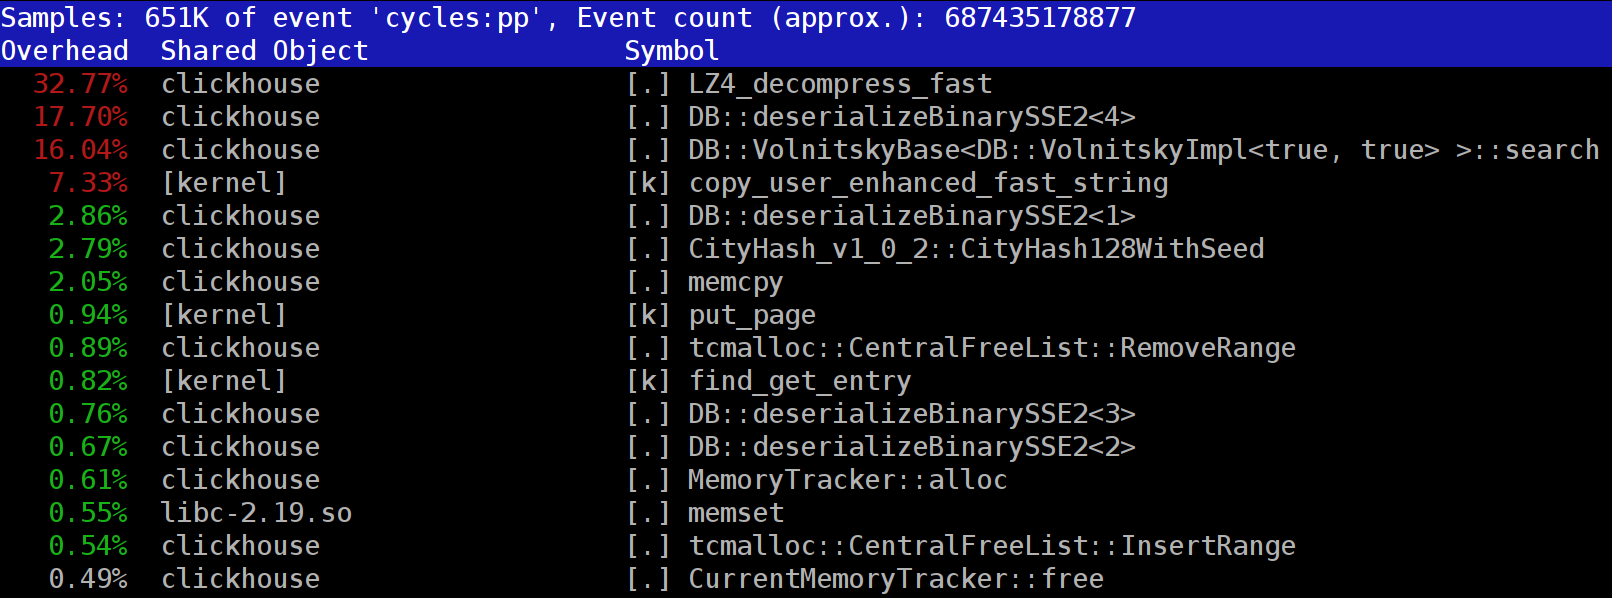
When you run queries in ClickHouse, you might notice that the profiler often shows the LZ_decompress_fast function near the top. What is going on? This question had us wondering how to choose the best compression algorithm.

ClickHouse stores data in compressed form. When running queries, ClickHouse tries to do as little as possible, in order to conserve CPU resources. In many cases, all the potentially time-consuming computations are already well optimized, plus the user wrote a well thought-out query. Then all that's left to do is to perform decompression.

How to speed up LZ4 decompression in ClickHouse? - 1

So why does LZ4 decompression becomes a bottleneck? LZ4 seems like an extremely light algorithm: the data decompression rate is usually from 1 to 3 GB/s per processor core, depending on the data. This is much faster than the typical disk subsystem. Moreover, we use all available CPU cores, and decompression scales linearly across all physical cores.
Читать полностью »

Многие, кто работал с Spark ML, знают, что некоторые вещи там сделаны "не совсем удачно"
или не сделаны вообще. Позиция разработчиков Spark в том, что SparkML — это базовая платформа, а все расширения должны быть отдельными пакетами. Но это не всегда удобно, ведь Data Scientist и аналитики хотят работать с привычными инструментами (Jupter, Zeppelin), где есть большая часть того, что нужно. Они не хотят собирать при помощи maven-assembly JAR-файлы на 500 мегабайт (для чего необходимо еще и минимальное знание JVM-программирования). Просить же DevOps-ов и администраторов кластера ставить кучу пакетов на вычислительные ноды — явно плохая идея. Тот, кто писал расширения для SparkML самостоятельно, знает, сколько там скрытых трудностей с важными классами и методами (которые почему-то private[ml]), ограничениями на типы сохраняемых параметров и т.д.

И кажется, что теперь, с библиотекой MMLSpark, жизнь станет немного проще, а порог вхождения в масштабируемое машинное обучение со SparkML и Scala чуть ниже.

Читать полностью »

Пользователи ClickHouse знают, что его главное преимущество — высокая скорость обработки аналитических запросов. Но как мы можем выдвигать такие утверждения? Это должно подтверждаться тестами производительности, которым можно доверять. О них мы сегодня и поговорим.
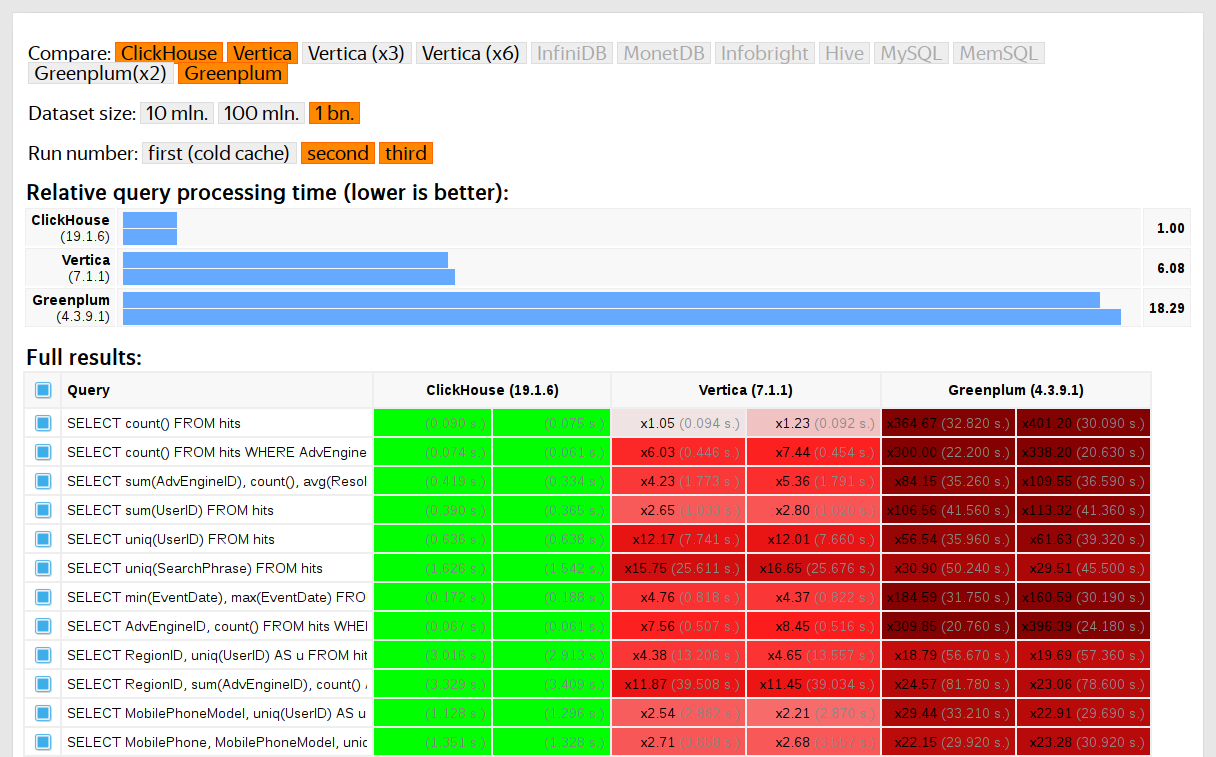
Обфускация данных для тестов производительности - 1

Такие тесты мы начали проводить в 2013 году, задолго до того, как продукт стал доступным в опенсорсе. Как и сейчас, тогда нас больше всего интересовала скорость работы данных сервиса Яндекс.Метрика. Мы уже хранили данные в ClickHouse с января 2009 года. Часть данных записывалась в базу с 2012 года, а часть — была переконвертирована из OLAPServer и Metrage — структур данных, которые использовались в Яндекс.Метрике раньше. Поэтому для тестов мы взяли первое попавшееся подмножество из 1 миллиарда данных о просмотрах страниц. Запросов в Метрике ещё не было, и мы придумали запросы, больше всего интересные нам самим (всевозможные виды фильтрации, агрегации и сортировки).

ClickHouse тестировался в сравнении с похожими системами, например, Vertica и MonetDB. Для честности тестирования его проводил сотрудник, который до этого не был разработчиком ClickHouse, а частные случаи в коде не оптимизировались до получения результатов. Похожим образом мы получили набор данных и для функциональных тестов.

После того, как ClickHouse вышел в опенсорс в 2016 году, к тестам стало больше вопросов.

Читать полностью »

Привет!

Не секрет, что для оценки платежеспособности клиентов банки используют данные из различных источников (кредитное бюро, мобильные операторы и т.д.). Количество внешних партнёров может достигать нескольких десятков, а аналитиков в нашей команде наберётся лишь несколько человек. Возникает задача оптимизации работы небольшой команды и передачи рутинных задач вычислительным системам.

Как данные попадают в банк, и как команда аналитиков следит за этим процессом, разберём в данной статье.
Читать полностью »

Привет! Лето — жаркое. Организаторы «айтишных» чемпионатов много сидели на солнце, сгорели и схватили удар, но главное — собрали новую задачу для очередного (уже девятого) контеста на платформе ML Boot Camp. Чемпионат пройдёт онлайн в течение месяца.

Краудсорсинг в ML Boot Camp. Считаем mIOU без картинок для новой задачи от Одноклассников - 1

Сейчас на платформе зарегистрировано более 10 тысяч специалистов. Часто бывает, что задачи, которые на ней появляются, не всем по зубам (богам Kaggle в том числе). Для чего мы это делаем? Нужно развиваться и пробовать, причем на реальных данных, а не синтетическом булшите. Победы придут со временем.

Задача, которую хотим предложить вам решить в этом соревновании, отличается от всех предыдущих. Тема задачи — это детектирование объектов на изображениях. Формулировка задачи подразумевает, что в наборе данных будут картинки, но, что забавно, их нет. И это не петабайты данных. И даже не гигабайты.
Читать полностью »

image

Термин Big Data подпорчен современным фантастическим преувеличением новых вещей. Как ИИ поработит людей, а блокчейн построит идеальную экономику — так и большие данные позволят знать абсолютно все про всех и видеть бучдущее.

Но реальность, как всегда, скучнее и прагматичнее. В больших данных нет никакой магии — как нет ее нигде — просто информации и связей между разными данными становится так много, что обрабатывать и анализировать все старыми способами становится слишком долго.

Появляются новые методы. Вместе с ними — новые профессии. Декан факультета аналитики Big Data в GeekBrains Сергей Ширкин рассказал, что это за профессии, где они нужны, чем там надо заниматься и что надо уметь. Какие используются инструменты и сколько обычно платят специалистам.
Читать полностью »

PyDaCon meetup в Mail.ru Group: 22 июня - 1

22 июня Mail.ru Group проводит совместный митап с организаторами конференции PyCon Russia и PyData Moscow meetup. Вас ждут 2 секции: доклады по Python, состав которого был сформирован на основе общего списка докладов к PyCon Russia и PyData-трек от PyData Moscow meetup. В программе мероприятия: keynote, технические доклады, викторина и много полезного общения.
Читать полностью »

Парсим 25Tb с помощью AWK и R - 1

Как читать эту статью: прошу прощения за то, что текст получился таким длинным и хаотичным. Чтобы сэкономить ваше время, я каждую главу начинаю со вступления «Чему я научился», в котором одним-двумя предложениями излагаю суть главы.

«Просто покажи решение!» Если вы хотите всего лишь увидеть, к чему я пришёл, то переходите к главе «Становлюсь изобретательнее», но я считаю, что интереснее и полезнее почитать про неудачи.

Недавно мне поручили настроить процесс обработки большого объёма исходных последовательностей ДНК (технически это SNP-чип). Нужно было быстро получать данные о заданном генетическом местоположении (которое называется SNP) для последующего моделирования и прочих задач. С помощью R и AWK мне удалось очистить и организовать данные естественным образом, сильно ускорив обработку запросов. Далось мне это нелегко и потребовало многочисленных итераций. Эта статья поможет вам избежать некоторых моих ошибок и продемонстрирует, что же у меня в конце концов получилось.
Читать полностью »

Хабр, привет.

Сегодня у нас пост с интересным заданием — будем обучать логистическую регрессию с L1 и L2 регуляризациями с помощью метода Stochastic Gradient Descent (SGD).

image

Перед тем как приступить к статье и коду, беглым шагом пробежимся по основным понятиям L1 и L2 регуляризации, логистической регрессии и стахостического градиентного спуска (Stochastic Gradient Descent — SGD).Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js