Рубрика «big data» - 97

image

27 мая в офисе Mail.Ru Group прошёл очередной Moscow Data Science Meetup. На встрече собирались представители крупных российских компаний и научных организаций, а также энтузиасты в области машинного обучения, рекомендательных систем анализа социальных графов и смежных дисциплин. Гости делились друг с другом своим опытом решения практических задач анализа данных. Предлагаем вашему вниманию видеозаписи и презентации трёх докладов, представленных на встрече.
Читать полностью »
Наверно, в мире данных нет подобного феномена настолько неоднозначного понимания того, что же такое Hadoop. Ни один подобный продукт не окутан таким большим количеством мифов, легенд, а главное непонимания со стороны пользователей. Не менее загадочным и противоречивым является термин "Big Data", который иногда хочется писать желтым шрифтом(спасибо маркетологам), а произносить с особым пафосом. Об этих двух понятиях — Hadoop и Big Data я бы хотел поделиться с сообществом, а возможно и развести небольшой холивар.
Возможно статья кого-то обидит, кого-то улыбнет, но я надеюсь, что не оставит никого равнодушным.

image
Демонстрация Hadoop пользователям

Читать полностью »

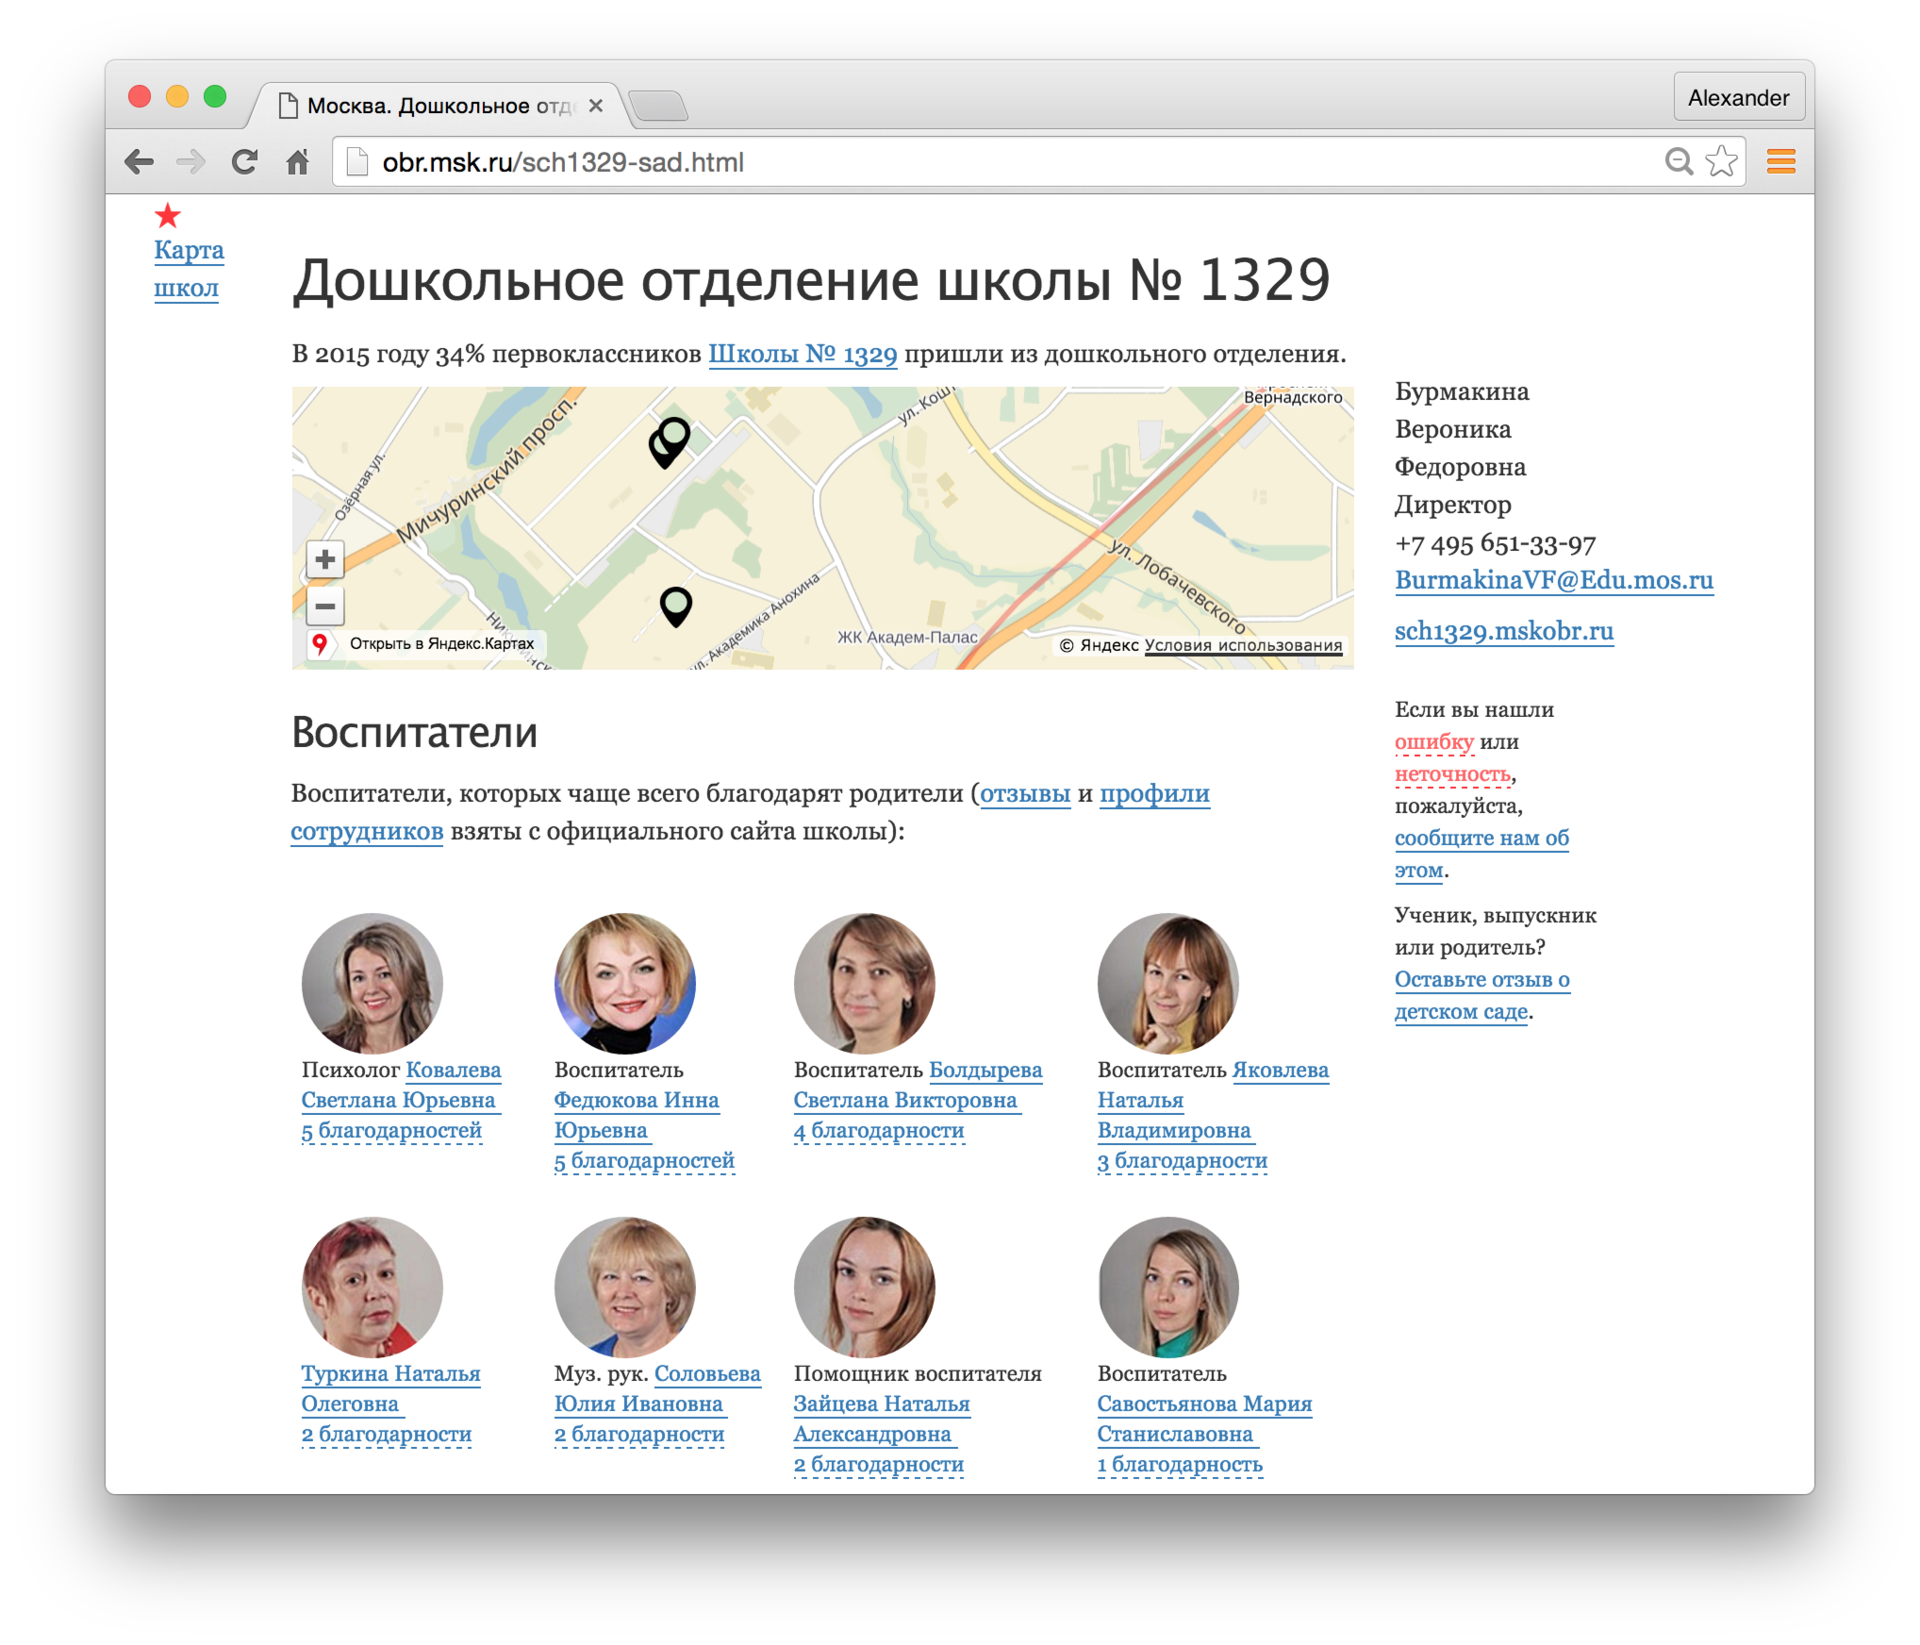
В Москве больше 2000 детских садов. В очередь на зачисление можно встать в несколько. Какие садики выбрать и какой указать приоритетным? На днях я сделал попытку дать ответ на этот вопрос.
Выбор детского сада в Москве - 1
Хотел бы рассказать про некоторых технические детали решения. В ходе работы со школьными данными я заметил, что на сайтах школ публикуется много отзывов. У этих данных есть 4 особенности:

  1. Отзывов много. Около 40 000 штук на 700 школ за 2015, 2016 годы. Это больше, чем на специальных сайтах про школьные отзывы типа www.schoolotzyv.ru и schools.mel.fm.
  2. 90% отзывов — про детские сады. Почему-то про садики пишут чаще и больше. Даже на obr.msk.ru оставляют отзывы про сады, хотя явно указано, что нужны впечатления о школах.
  3. 99.9% отзывов положительные. Это печально, потому что читать только положительные отзывы неинтересно.
  4. В 95% отзывов родители персонально благодарят воспитателей. Например, «Инна Юрьевна находит подход к каждому, может унять любой утренний каприз ребенка и помочь родителям».

Поэтому появилась идея сделать вот что:
Читать полностью »

Привет! Три месяца назад мы объявили о старте соревнования по машинному обучению BlackBox Challenge, а недавно оно закончилось. В этом посте организаторы соревнования расскажут о том, как всё прошло.

Итоги Black Box Challenge - 1


Вдохновившись результатами Google DeepMind по reinforcement learning, мы поняли, как здорово, когда система не использует человеческую экспертизу, а сама учится понимать окружающую среду. Мы решили сделать соревнование, в котором участникам нужно создать как раз такую систему.
Читать полностью »

Сегодня внутренняя разработка компании Яндекс — аналитическая СУБД ClickHouse, стала доступна каждому. Исходники опубликованы на GitHub под лицензией Apache 2.0.

Яндекс открывает ClickHouse - 1

ClickHouse позволяет выполнять аналитические запросы в интерактивном режиме по данным, обновляемым в реальном времени. Система способна масштабироваться до десятков триллионов записей и петабайт хранимых данных. Использование ClickHouse открывает возможности, которые раньше было даже трудно представить: вы можете сохранять весь поток данных без предварительной агрегации и быстро получать отчёты в любых разрезах. ClickHouse разработан в Яндексе для задач Яндекс.Метрики — второй по величине системы веб-аналитики в мире.

В этой статье мы расскажем, как и для чего ClickHouse появился в Яндексе и что он умеет; сравним его с другими системами и покажем, как его поднять у себя с минимальными усилиями.

Читать полностью »

Однажды, мне стало интересно: насколько статьи на Хабре связаны между собой? Поэтому сегодня мы займемся исследованием связности статей, и конечно не только посчитаем численные метрики, но и увидим картину целиком.

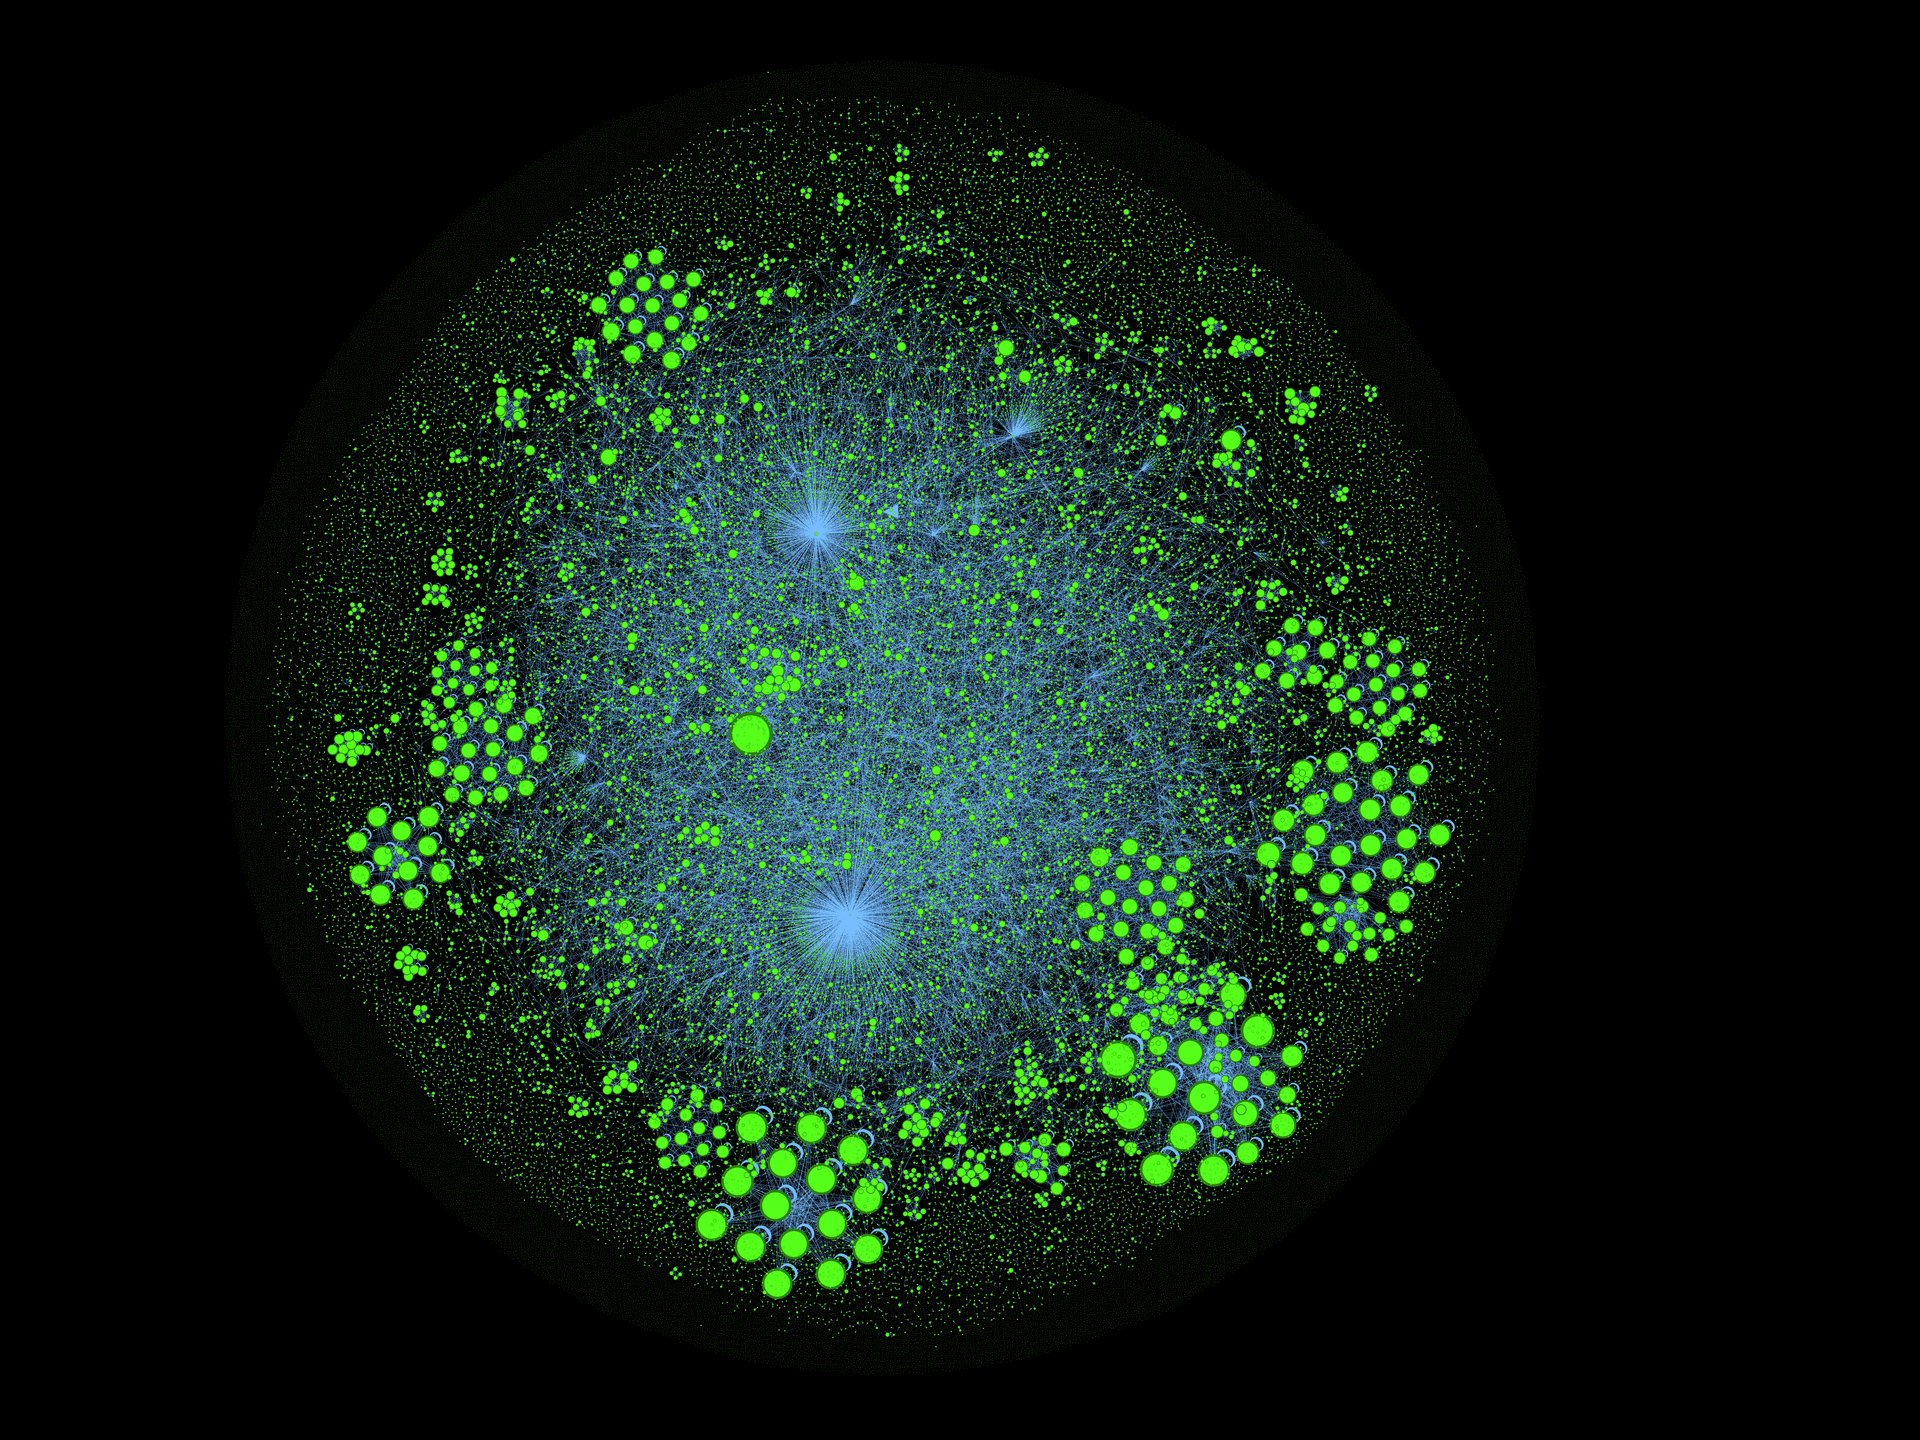
Граф цитирования статей Хабрахабра - 1
(это не просто картинка для привлечения внимания, а граф цитирования статей внутри Хабрахабра, где размер вершин определяется числом входящих рёбер, i.e., "количеством цитат внутри Хабра")

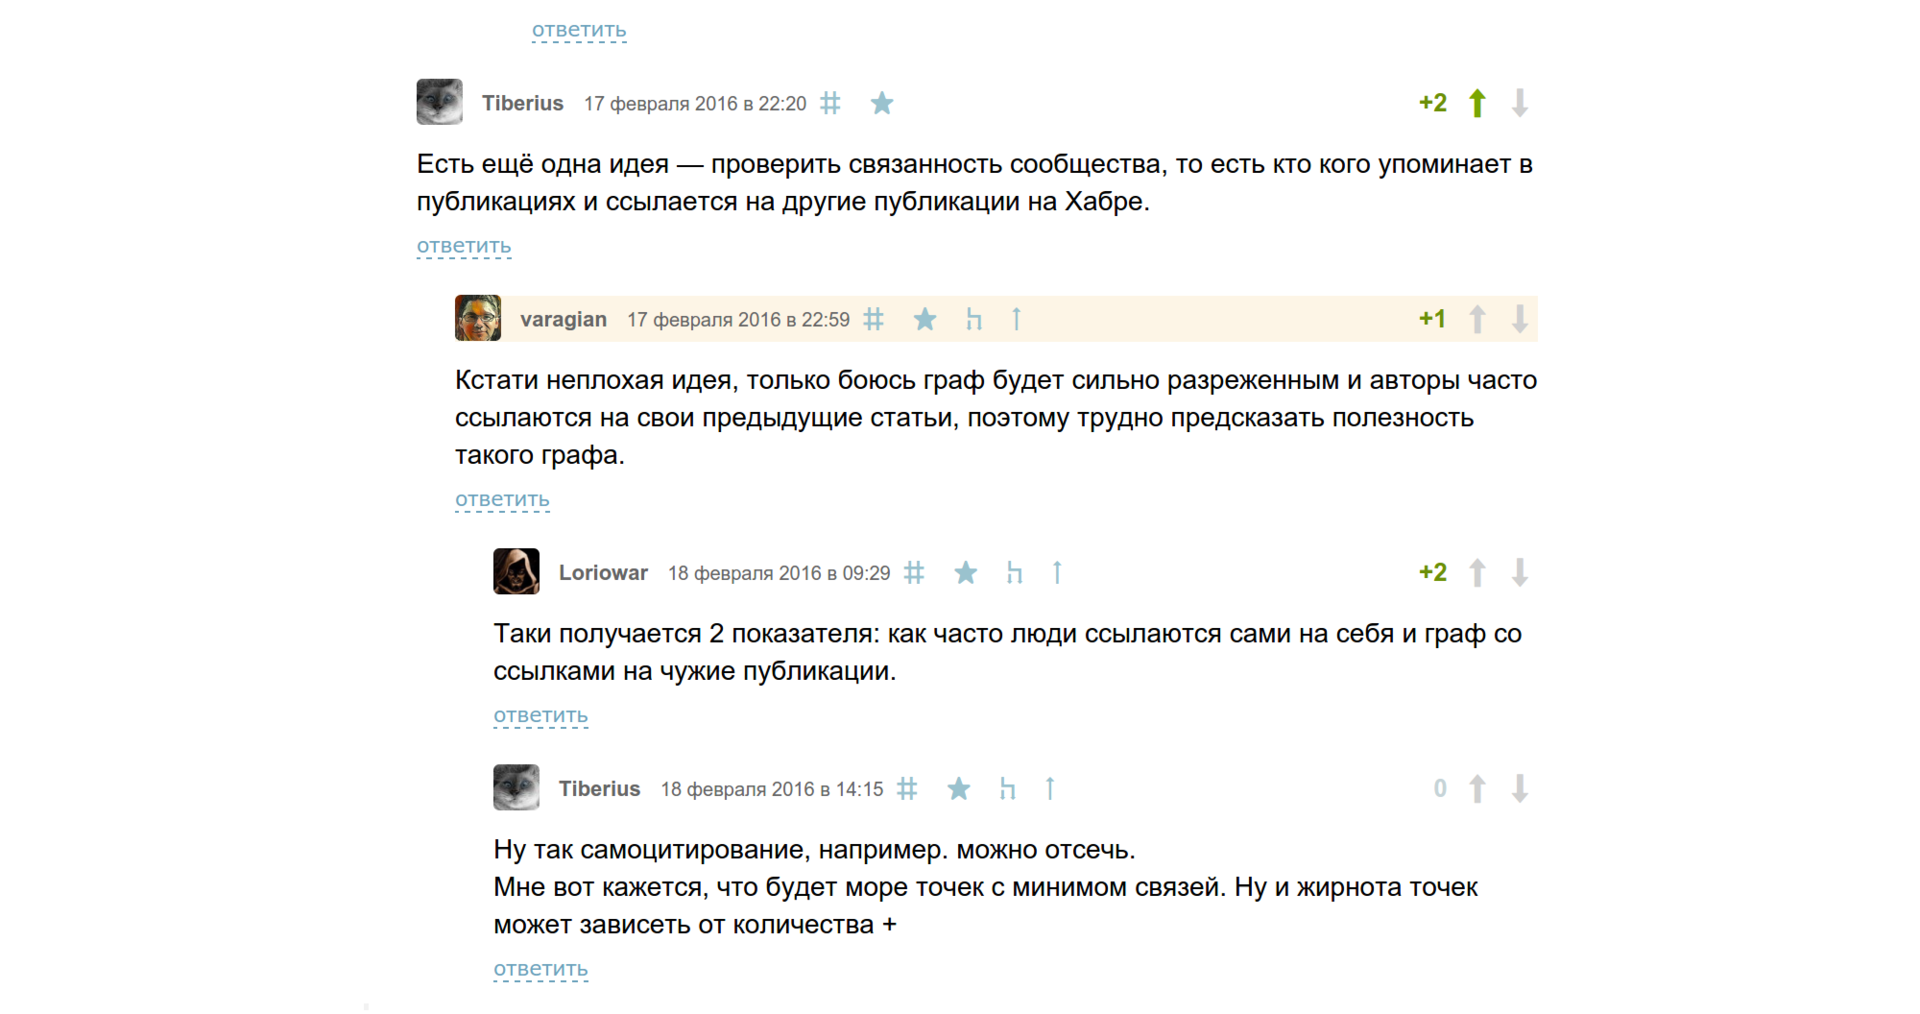
Началось всё с того, что в комментариях к статье про Хабра-граф и карму Tiberius и Loriowar озвучили идею, фактически витающую в воздухе: а почему бы не взглянуть на граф цитирования статьёй внутри самого Хабра?

Граф цитирования статей Хабрахабра - 2

Вы спрашивали? Мы отвечаем. Для того чтобы рассказ не был размахиванием рук, конкретизируем разбираемые вопросы:

  • Q1: Как выглядит граф цитирования Хабрахабра и какие в нём хабы (hubs and authorities)?

  • Q2: Насколько связным является сообщество (граф цитирования) и какие в нём кластеры?

  • Q3: Как изменится граф, если из него убрать самоцитирование?

Под катом трафик. Все картинки кликабельны.

Читать полностью »

Команда Retail Rocket использует узкоспециализированный стек технологий Hadoop + Spark для вычислительного кластера, о котором мы уже писали обзорный материал в самом первом посте нашего инженерного блога на Хабре.

Готовых специалистов для таких технологий найти довольно сложно, особенно, если учесть, что программируем мы исключительно на Scala. Поэтому я стараюсь найти не готовых специалистов, а людей, имеющих минимальный опыт работы, но обладающих большим потенциалом. Мы берем даже людей с частичной занятостью, чтобы было удобно совмещать учебу и работу, если кандидат — студент последних курсов.

Курс молодого бойца для Spark-Scala - 1

Читать полностью »

Давным-давно, один специалист по базам данных (из тех, бородатых и уже седых) сказал мне, что метки времени (timestamp) — это самая сложная тема в базах данных. Я ему, правда, не поверил, но приколы со временем реально встречаются.

Есть стандартная проблема, которую часто вижу в чужих данных. Положим собрались вы отслеживать события/действия пользователя. Обычно у вас будет это делать некий код (JS в вебе или SDK для аппов), который будет слать данные серверу.

Каждому событию нужна метка времени. И есть выбор из двух: локальное время на клиенте или время получения события сервером. Один хороший совет что делать и загадка без ответа под катом Читать полностью »

Немецкая компания SAP совместно с Yandex data factory (Big Data подразделение с офисами в Москве и Нидерландах) начнут разрабатывать сервис предсказательной аналитики, который будет анализировать поведение клиентов. Это позволит компаниям на 10% снизить затраты на привлечение и удержание последних. По мнению обеих компаний, сервис будут использовать в ритейле, e-commerce, Читать полностью »

Работа с данными: Как это делают крупные компании - 1

/ фото Jason Tester Guerrilla Futures CC

Компания IDC сообщает, что в 2011 году человечеством было сгенерировано 1,8 зеттабайт информации. В 2012 году эта цифра составила уже 2,8 зеттабайт, а к 2020 она увеличится до 40 зеттабайт.

Существенную часть этих данных генерируют крупные мировые компании, такие как Google, Facebook, Apple. Им нужно не просто хранить данные, но и выполнять резервное копирование, следить за их актуальностью, обрабатывать, причем делать это с минимальными затратами. Поэтому ИТ-отделы крупных организаций разрабатывают собственные системы для решения этих задач.Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js