Рубрика «big data» - 98

Всероссийская инженерная олимпиада для старшеклассников: BigData и Интеллектуальные энергетические системы - 1

— Вовочка, бросай свои эксперименты с холодным ядерным синтезом, иди к ЕГЭ готовься.
— Ща, мам.

Олимпиады — это круто. Они позволили такому раздолбаю свободолюбивому и умном, как я, поступить в университет без экзаменов.

Помню пришли мы в приемную комиссию с приятелем, в шортах и с рюкзаками, в которых были полотенца и волейбольный мяч, заполнили анкеты, выложили по пачке дипломов с олимпиад и поехали на море.

— Что вы сегодня на час опоздали?
— Да так, в универ поступали.

Я очень рад, что нашлись инициативные ребята, которым не все равно, что талантливый школьник-инженер тратит свои последние беззаботные годы, судорожно готовясь к сдачи ЕГЭ, вместо того, чтобы строить реактивные ранцы или программировать зародыш искусственного интеллекта.

Чтобы создать лазейку для молодых талантливых инженеров, они придумали следующую штуковину — давайте замутим инженерную олимпиаду, которая дает возможность поступить в вуз.

Недавно в ВДЦ «Орленок» прошел «тест-драйв» Всероссийской инженерной олимпиады. Участвовали 5000 детей со всей России, до финала дошли около 100 человек. Призов много, но самое полезное — по +10 очков к ЕГЭ.

Я за всем присматривал и готов поделиться своими впечатлениями.

Олимпиада шла по четырем профилям.

Про первые два профиля расскажу здесь (чуток задач и фоток), про вторые два — немного попозже на GT.
Читать полностью »
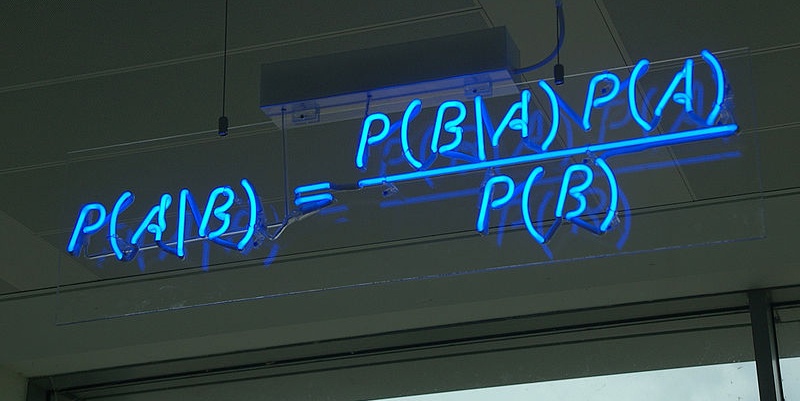
bayesian

Почему?

Сейчас Relap.io генерирует 40 миллиардов рекомендаций в месяц на 2000 медиаплощадках Рунета. Почти любая рекомендательная система, рано или поздно, приходит к необходимости брать в расчет содержимое рекомендуемого контента, и довольно быстро упирается в необходимость как-то его классифицировать: найти какие-то кластеры или хотя бы понизить размерность для описания интересов пользователей, привлечения рекламодателей или еще для каких-то темных или не очень целей.

Задача звучит довольно очевидно и существует немало хорошо зарекомендовавших себя алгоритмов и их реализаций: Латентное размещение Дирихле (LDA), Вероятностный латентно-семантический анализ (pLSA), явный семантический анализ (ESA), список можно продолжить. Однако, мы решили попробовать придумать что-нибудь более простое, но вместе с тем, жизнеспособное.
Читать полностью »

По просьбе хабрачан продолжим публикации об исследовании обсценной лексики. (Если кто не читал первую часть, то можете ознакомиться).
Начнем сразу с картинок.
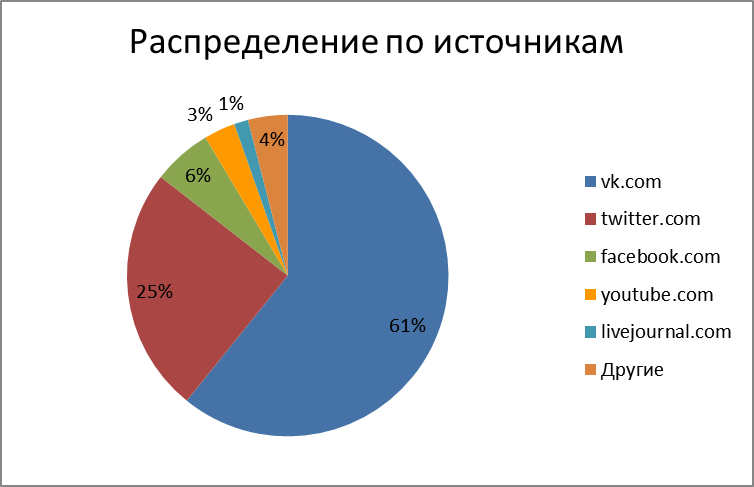
Итак, картинка первая.
Четыре слова, которые нельзя (часть 2) - 1
Рис.1. Распределение обсценной лексики по источникам.
Читать полностью »

Стандартный план любого хакатона ↓
Microsoft Azure Machine Learning Hackathon
R, один из популярнейших языков программирования среди data scientist'ов, получает все большую и большую поддержку как среди opensource-сообщества, так и среди частных компаний, которые традиционно являлись разработчиками проприетарных продуктов. Среди таких компаний – Microsoft, чья интенсивно увеличивающая поддержка языка R в своих продуктах/сервисах, привлекла к себе и мое внимание.

Одним из «локомотивов» интеграции R с продуктами Майкрософт является облачная платформа Microsoft Azure. Кроме того, появился отличный повод повнимательнее взглянуть на связку R + Azure – это проходящий в эти выходные (21-22 мая) хакатон по машинному обучению, организованный Microsoft.

Хакатон – мероприятие, где кофе время чрезвычайно ценный ресурс. В контексте этого я ранее писал о best practices обучения моделей в Azure Machine Learning. Но Azure ML – это не инструмент для прототипирования; это скорее сервис для создания продукта с SLA со всеми вытекающими отсюда затратами как на время разработки, так и на стоимость владения.

R же прекрасно подходит для создания прототипов, для копания (mining) в данных, для быстрой проверки своих гипотез – то есть
всего того, что нам нужно на такого типа соревнованиях! Ниже я расскажу, как использовать всю мощь R в Azure – от создания прототипа до публикации готовой модели в Azure Machine Learning.
Читать полностью »

Мы рады пригласить Вас на ключевое событие года в мире данных – Виртуальный Форум Microsoft «Данные. Технологии. SQL Server 2016», который состоится 8 июня 2016 года. Форум приурочен к выходу новой версии платформы управления данными Microsoft на базе SQL Server 2016, лидеру квадранта Gartner по системам управления базами данных*.

Анонс: 8 июня пройдет виртуальный форум Microsoft «Данные. Технологии. SQL Server 2016» - 1


Успех цифровой трансформации бизнеса сегодня напрямую зависит от способности организации использовать передовые технологии и инструменты по работе с данными, которые становятся важнейшим ресурсом развития бизнеса – сравнимым, пожалуй, с ролью электричества в эпоху трансформации XIX века. В рамках форума мы обсудим, какие требования сегодня предъявляются к современным платформам по работе с данными, какие ключевые технологии must have в арсенале любой компании.

Основная программа форума состоит из трех паралельных технологических сесссий:

  • SQL Server 2016: новые стандарты в мире транзакции;
  • Бизнес-aналитика: SQL, Power BI, R, Mobile;
  • Azure: новое поколение решений для аналитики, Big Data& IoT.

Подробная программа доступна на сайте мероприятия.
Читать полностью »

Иван Бегтин, директор АНО «Информационная культура», объяснил в РБК почему Big Data — это не только полезный инструмент для преследования чиновников за злоупотребления, но и способ при помощи которого люди, владеющие технологиями, смогут узнавать о нас гораздо больше, Читать полностью »

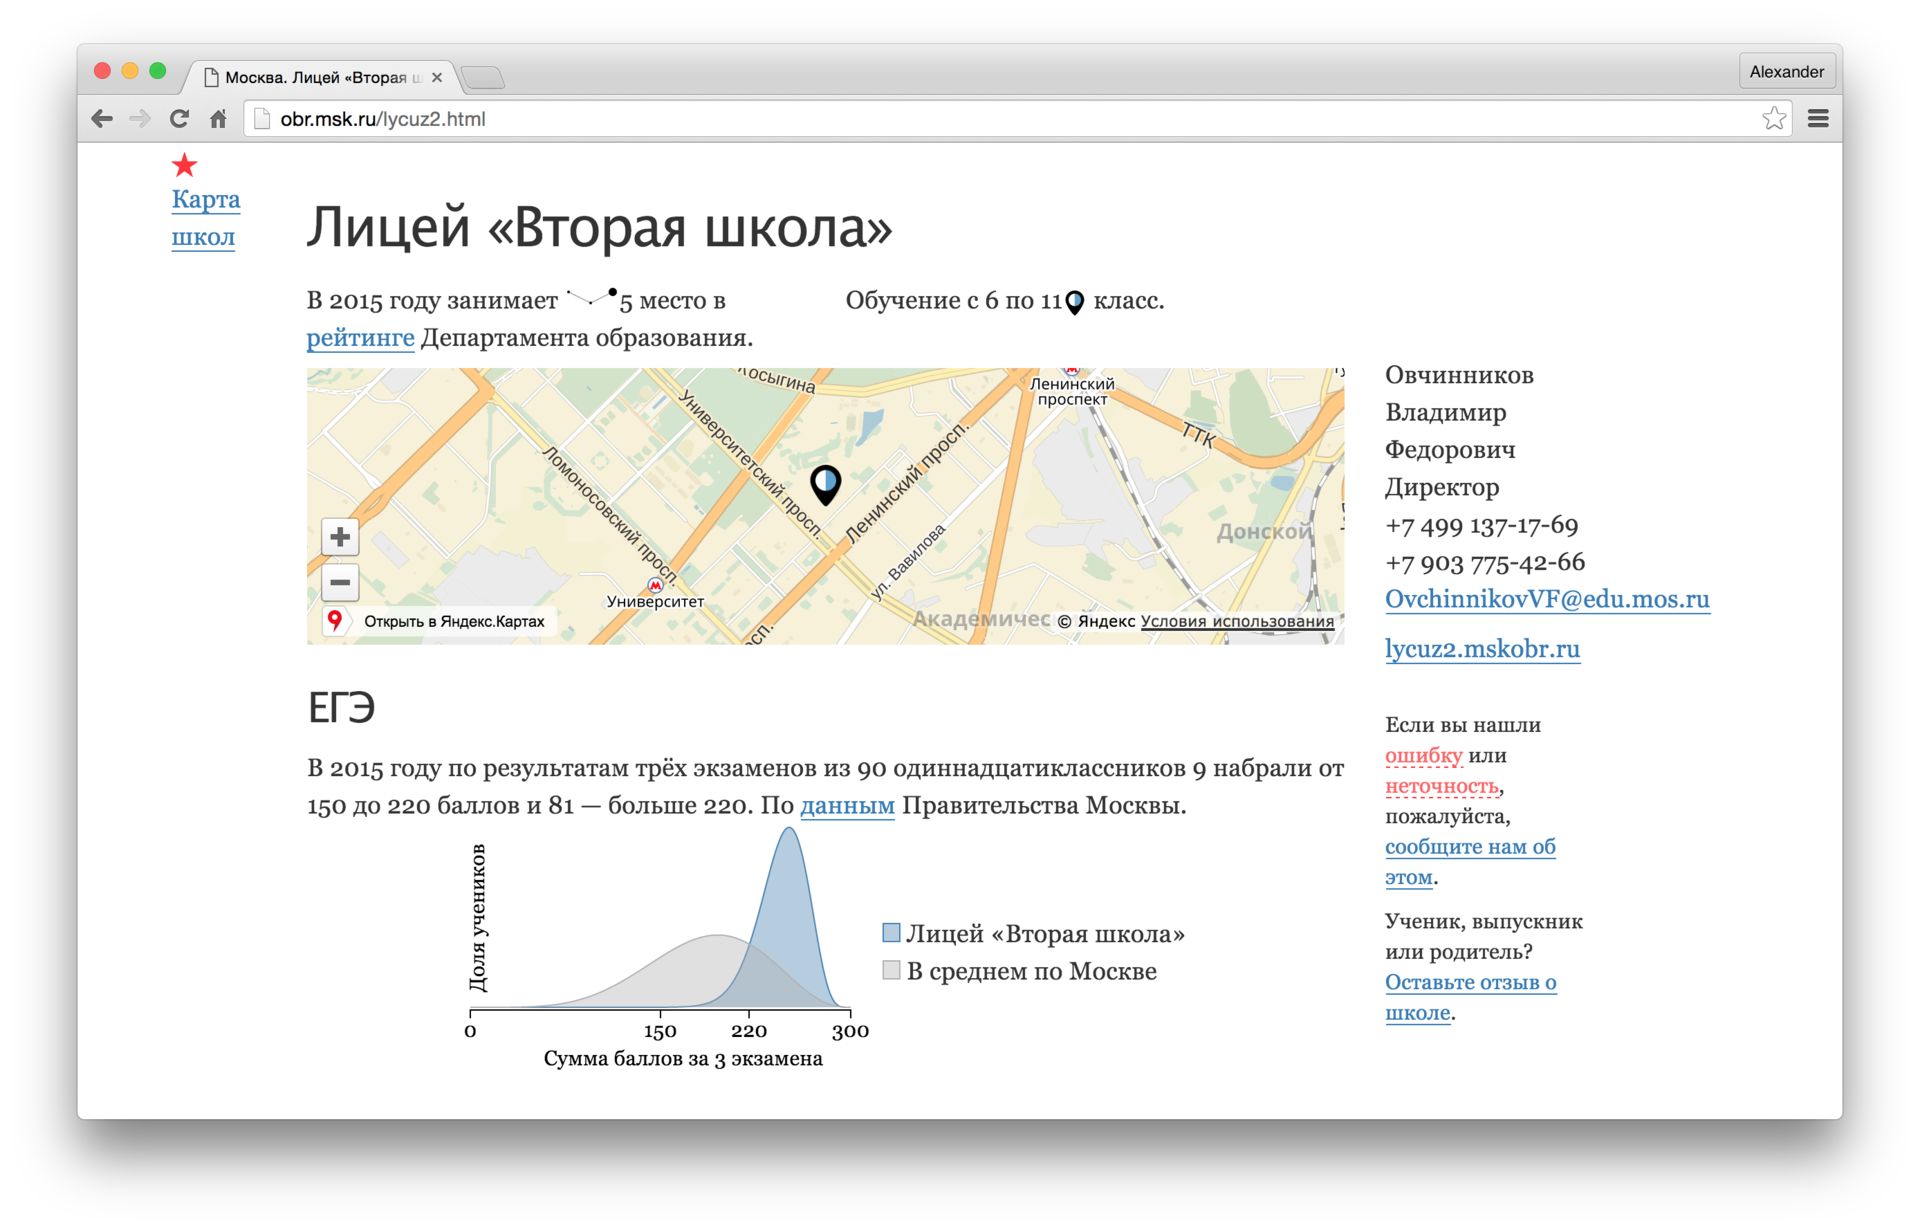
Полгода назад я писал про то, как мы участвовали в конкурсе по открытым данным с проектом "Московские школы". Потом было исследование московских результатов ЕГЭ, московских кружков и секций. Недавно удалось собрать все результаты в одном месте и аккуратно оформить:
Выбор школы в Москве the hard way - 1

Я хотел бы подробно рассказать про процесс сбора и обработки школьных данных. Оказывается, что для каждой школы в Москве публикуется достаточно много информации: результаты ЕГЭ, ГИА и олимпиад, профили учителей, бухгалтерская отчётность и списки кружков.
Читать полностью »

Джил Лепор, профессор истории Гараварда, рассуждает о том, какими могут быть критерии определения правды и лжи в эпоху интернета, мобильных технологий, "больших данных" и "диктатуры масс-медиа". Оригинальная статья в журнале The New Yorker. Редакция Roem.ru благодарит Полину Пилюгину и Кирилла Чернякова из сообщества Newочём за помощь в подготовке материала.

Читать полностью »

Ожидания направлений развития в сфере хранения и обработки данных до 2020 года. Основные тренды - 1

Развитие ИТ-инфраструктуры — это неуклонный процесс, который был, есть и непременно будет, набирая все только большие обороты. Взяв очередную высоту стандартов осуществления своей деятельности, перед сетевыми инженерами открываются новые горизонты, достижение которых становится для них очередным вызовом и основой их повседневных трудов. Для успешного функционирования ИТ-компаний всегда было очень важным точно определить цели, направления развития, самые актуальные тренды ведь как можно наблюдать именно ИТ-сфера находится на самом острие технологического прогресса и особо подвержена внедрению нововведений. В древности, за возможностью заглянуть в день грядущий, люди обращались к оракулам и вещунам, сейчас же эту столь вакантную деятельность «окучивают» профессиональные ассоциации, проводя всевозможные опросы и создавая на их основе самые разносторонне направленные отчеты.

Именно таким отчетом, совсем недавно, порадовала ИТ-сообщество AFCOM(Association for Computer Operation Management). Предметом полномасштабного исследования стало функционирование дата-центров. Со слов представителей AFCOM представленный отчет является настоящим событием, поскольку охватил самые широкие слои специалистов задействованных в работе ЦОД(Центр Оброботки Данных). Сетевые инженеры, менеджеры, программисты и владельцы компаний-провайдеров в представленном докладе дадут нам более четкое виденье той ситуации, в которой отрасль находится сейчас и где она окажется в ближайшие 3-4 года. Далее в статье будут представлены основные акценты на которых базируется вышеупомянутый отчет, что претендует быть наиболее репрезентативным и наиболее актуальным среди всех аналогичных проведеных в 2015 году.

Читать полностью »

Привет! Мы продолжаем наш цикл статьей, посвященный инструментам и методам анализа данных. Следующие 2 статьи нашего цикла будут посвящены Hive — инструменту для любителей SQL. В предыдущих статьях мы рассматривали парадигму MapReduce, и приемы и стратегии работы с ней. Возможно многим читателям некоторые решения задач при помощи MapReduce показались несколько громоздкими. Действительно, спустя почти 50 лет после изобретения SQL,  кажется довольно странным писать больше одной строчки кода для решения задач вроде «посчитай мне сумму транзакций в разбивке по регионам».

С другой стороны, классические СУБД, такие как Postgres, MySQL или Oracle не имеют такой гибкости в масштабировании при обработке больших массивов данных и при достижении объема большего дальнейшая поддержка становится большой головоной болью.

Big Data от A до Я. Часть 5.1: Hive — SQL-движок над MapReduce - 1

Собственно, Apache Hive был придуман для того чтобы объеденить два этих достоинства:

  • Масштабируемость MapReduce
  • Удобство использования SQL для выборок из данных.

Под катом мы расскажем каким образом это достигается, каким образом начать работать с Hive, и какие есть ограничения на его применения.
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js