
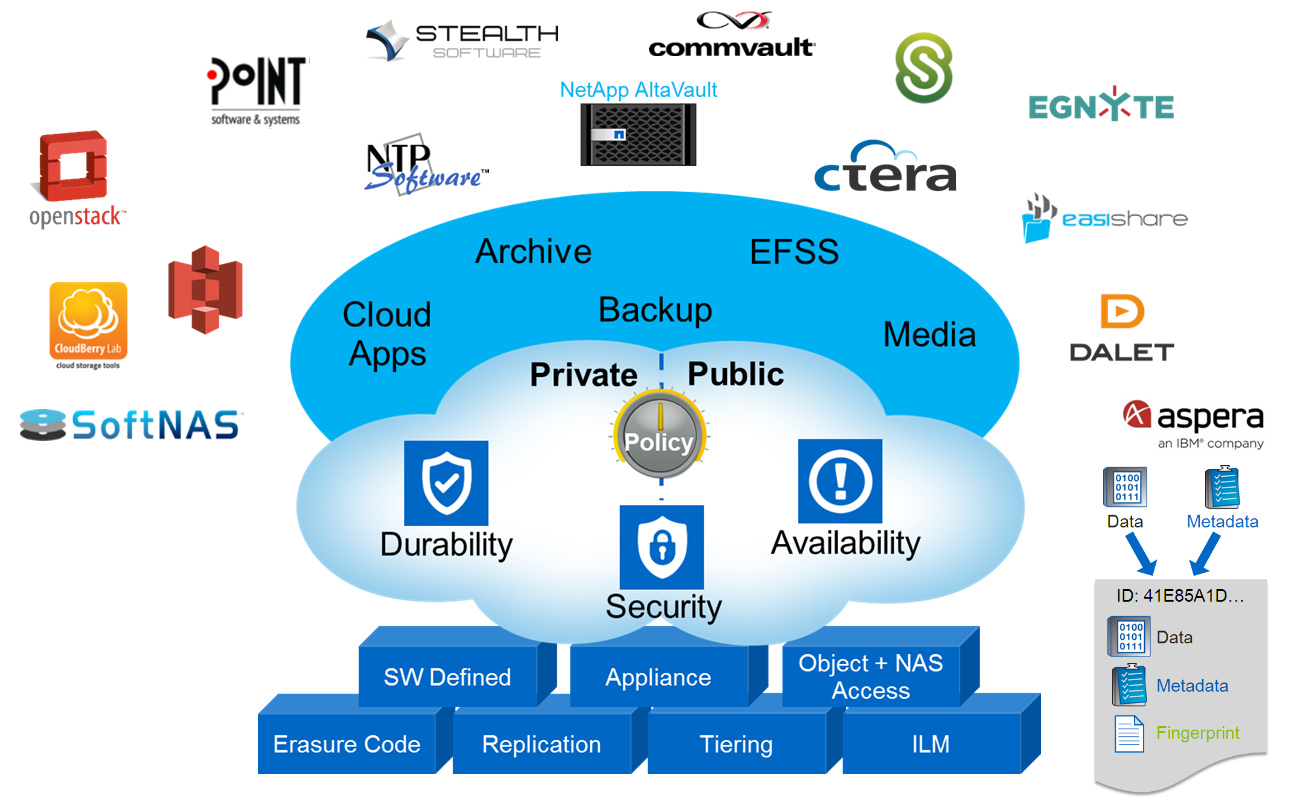
В этой статье я отклонюсь от традиционной для меня темы систем хранения FAS и подниму тему объектного хранения данных в системах NetApp StorageGrid WebScale. Если кратко, то объектное хранение — это третий тип хранения наряду с NAS и SAN. Представьте себе, что каждый файл состоит из данных и метаинформации (владелец, права, время модификации и т.д.), так вот объектное хранение позволяет разъединить эти части и хранить их в виде «ключ/значение». Такой подход хранения информации открывает возможности децентрализованного, распределённого хранения данных огромных масштабов с прозрачной миграцией данных, репликацией и прозрачным переключением конечных потребителей между нодами объектного кластера. В широком смысле объектное хранилище может быть реализовано как на уровне устройства (жесткого диска), при помощи специализированных SCSI команд (Object-based Storage Device Commands), так и на уровне протокола доступа к системе хранения, которая состоит из нескольких дисков (которые, в свою очередь, вовсе не обязаны быть объектными). В обоих случаях используется Ethernet для подключения и IP протокол для передачи данных. Примером реализации объектного хранилища на уровне устройства являются жесткие диски линейки Seagate Kinetic Open Storage platform. Примером систем хранения данных в облаке может быть Microsoft Azure BLOB, Amazon S3. В этой статье я остановлюсь на объектных СХД, которые можно развернуть у себя на сайте и при необходимости подключить к облаку.
Читать полностью »
Рубрика «big data» - 99
Объектное хранилище NetApp StorageGrid
2016-05-10 в 13:18, admin, рубрики: AltaVault, amazon, Amazon CloudFront, amazon s3, archive, backup, big data, blob, CDMI, ceph, CIFS, cinder, Citrix Sharefile, cloudfront, Commvault, Ctera, DDP, docker, Dynamic Disk Pools, E-Series, Egnyte, Erasure Coding, File share, File sync, Geo-EC, glance, Inktank, Inktank Ceph, kilo, kvm, NAS, NetApp, NetApp AltaVault, NetApp E-Series, NetApp StorageGrid, nfs, NTP software, object storage, OpenStack Heat, OpenStack Kilo, raid, RESTful HTTP, s3, SCSI, SGAPI, smb, SoftNAS, stealth, StorageGrid, swift, Swift API, Symantec Enterprise Vault, Анализ и проектирование систем, ит-инфраструктура, системное администрирование, хранение данныхУкрощаем слона или что такое HUE
2016-05-10 в 12:46, admin, рубрики: Apache, apache hadoop, big data, cloudera, javaПост будет о том, как сделать работу на Хадупе немного комфортнее.
В данной статье я хочу рассмотреть один из компонентов экосистемы Hadoop – HUE. Произносим правильно «Хьюи» или «Эйч Ю И», но не другими, созвучными с широко известным русским словом, вариантами.
Читать полностью »
Интернет пчел, или Зеленое будущее M2M приложений
2016-05-04 в 7:00, admin, рубрики: big data, IoT, безопасность, безопасность в сети, Беспроводные технологии, Блог компании Gemalto Russia, Геоинформационные сервисы, Интернет вещей, информационная безопасность, экологияВсе обсуждение вокруг феномена Интернета вещей обычно сводится к тем потенциальным преимуществам для бизнеса и к тем удобствам для пользователей, которые предлагают наши интеллектуальные устройства и объекты, окружающие нас в повседневной жизни. При этом многие аналитики не исключают вероятности того, что мы находимся на пороге второй цифровой революции.
Однако недавно прошедший День Земли натолкнул нас на идею рассмотреть вопрос шире – это был отличный повод изучить, каким образом Интернет вещей, и даже скорее индустриальный Интернет вещей (M2M – machine-to-machine), то есть беспроводная передача данных и информации между устройствами и объектами, сможет оказать благотворное влияние на нашу жизнь и будет способствовать устойчивому развитию и защите окружающей среды на нашей взаимосвязанной планете.
BlackBox Challenge: Что внутри черного ящика?
2016-04-30 в 10:39, admin, рубрики: artificial intelligence, big data, blackbox challenge, cython, deep learning, machine learning, reinforcement learning, искусственный интеллект, машинное обучение, нейронные сети, обучение с подкреплением, Спортивное программирование, метки: blackbox challengeВсем привет!
Сегодня речь пойдет о состязании, в области машинного обучения, BlackBox Challenge, а также о самом черном ящике, механизмах его работы, изменения состояний, начисления вознаграждений и конечно о том, что же там внутри.
Чуть ниже я опубликую решение, входящее, на момент публикации, в 5-ку лучших.
Уверен оно поможет другим участникам улучшить свои результаты, а возможно и отыскать новый подход.
Во что превратятся большие данные
2016-04-28 в 14:42, admin, рубрики: big data, Большие данные, добыча данных, интеллект бизнеса, Исследования и прогнозы в IT, управление информацией, управление проектами Big data – это большой потенциал для бизнеса.
Их сбор, хранение, обработка, аналитика требуют внушительных усилий и расхода ресурсов. И это нужно для того, чтобы делать меньше ошибок, и чтобы минимизировать последствия сделанных ошибок.
Иными словами, управление большими данными имеет главной целью принятие качественных решений.
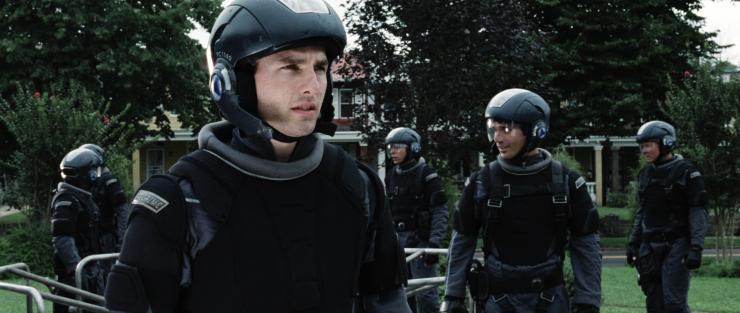
Кадр из к/ф «Особое мнение» (Minority Report) Стивена Спилберга по повести Филипа Дика (2002 — 20th Century Fox, DreamWorks SKG).
Читать полностью »
«Спасательный круг» Intel: глава компании официально объявил о смене бизнес-модели
2016-04-28 в 6:09, admin, рубрики: big data, intel, аналитика, бизнес-модели, Монетизация IT-систем, облачные технологии, реструктуризация бизнеса, смена стратегии 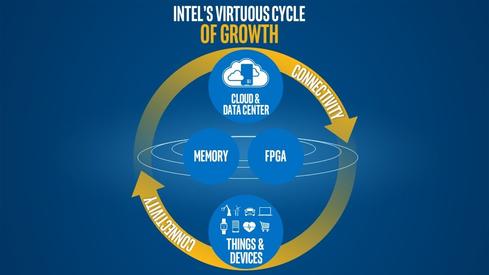
Источник: informationweek.com
Генеральный директор Intel Брайан Крзанич изложил новую стратегию развития компании в своем послании. Специалисты компании решили, что необходимо отказаться от парадигмы, в рамках которой главным драйвером развития бизнеса были продажи ПК. По оценке IDC, в 2014 году глобальные продажи компьютеров упали на 2,1%, в 2015 году сокращение оценивается в 6,2%. Вместо этого CEO предлагает сосредоточиться на поставках решений для дата-центров и инфраструктуры интернета вещей.
В последнее время все сильнее распространяются облачные технологии. Поэтому одной из стратегических задач компании станет адаптация архитектуры под виртуализированные среды и программно-определяемые технологии.
Отдельное внимание Брайан Крзанич планирует уделить аналитическим системам и большим данным: «Мы повысим мощность и ценность аналитики за счет продолжающихся инноваций в области производительности, больших данных и способностей машин к обучению».Читать полностью »
Big Data: «Серебряная пуля» или еще один инструмент
2016-04-27 в 7:50, admin, рубрики: 1cloud, big data, Блог компании 1cloud.ru, Большие данные, виртуальная инфраструктура, Разработка под e-commerce 
Термин «Большие данные» появился не так давно — впервые его использовали в журнале Nature в 2008 году. В том номере (от 3 сентября) большими данными читателям было предложено называть набор специальных методов и инструментов для обработки огромных объемов информации и представления её в виде, понятном пользователю.
Очень скоро исследователи новоявленной области пришли к выводу, что большие данные не просто годятся для анализа, а могут оказаться полезными в целом ряде областей: от предсказания вспышек гриппа по результатам анализа запросов в Google до определения выгодной стоимости билетов на самолет на основе огромного массива авиационных данных.
Апологеты этого направления утверждают даже, что тандем мощных современных технологий и «мощных» объемов информации, доступных в цифровую эпоху, обещает стать грозным инструментом для решения практически любой проблемы: расследования преступлений, охраны здоровья, образования, автомобильной промышленности и так далее. «Нужно лишь собрать и проанализировать данные».Читать полностью »
Приглашаем на конференцию по искусственному интеллекту и большим данным AI&BigData Lab 4 июня
2016-04-27 в 6:38, admin, рубрики: artificial intelligence, big data, data mining, FlyElephant, Алгоритмы, Блог компании FlyElephant, Большие данные, искусственный интеллект, конференция, машинное обучение 
4 июня в Одессе, наша команда FlyElephant совместно с GeeksLab будет проводить третью ежегодную техническую конференцию по искусственному интеллекту и большим данным — AI&BigData Lab.
На конференции разработчики обсудят вопросы реализации и применения различных алгоритмов, инструментов и новых технологий для работы с большими данными и искусственным интеллектом. Будут представлены воплощенные в жизнь проекты, рассказано о функционале и принципах их работы.
Программа конференции AI&BigData Lab уже частично сформирована. Среди принятых докладов можно отметить:
Читать полностью »
Производительность Apache Parquet
2016-04-26 в 23:47, admin, рубрики: apache hadoop, Apache Spark, avro, big data, csv, data mining, file format, parquet, performance tests, scala, кто читает теги?, сжатие данных, хранение данныхПлохой пример хорошего теста
Примечание переводчика:
Изначально статья задумывалась как вольный перевод текста Дона Дрейка (@dondrake) для Cloudera Engineering Blog об опыте сравнения Apache Avro и Apache Parquet при использовании Apache Spark. Однако в процессе перевода я углубился в детали и нашел в тестах массу спорных моментов. Я добавил к статье подзаголовок, а текст снабдил комментариями со злорадным указанием неточностей.
В последнее время в курилках часто возникали дискуссии на тему сравнения производительности различных форматов хранения данных в Apache Hadoop — включая CSV, JSON, Apache Avro и Apache Parquet. Большинство участников сразу отметают текстовые форматы как очевидных аутсайдеров, оставляя главную интригу состязанию между Avro и Parquet.
Господствующие мнения представляли собой неподтвержденные слухи о том, что один формат выглядит "лучше" при работе со всем датасетом, а второй "лучше" справляется с запросами к подмножеству столбцов.
Как любой уважающий себя инженер, я подумал, что было бы неплохо провести полноценные performance-тесты, чтобы наконец проверить, на чьей стороне правда. Результат сравнения — под катом.
Какие факторы влияют на производительность систем хранения и как?
2016-04-26 в 9:40, admin, рубрики: big data, IOPS, IT-стандарты, raid, Блог компании ua-hosting.company, ит-инфраструктура, производительность, пропускная способность, размер блока, размер кластера, системы хранения, хостингСистемы хранения данных для подавляющего большинства веб-проектов (и не только) играют ключевую роль. Ведь зачастую задача сводится не только к хранению определенного типа контента, но и к обеспечению его отдачи посетителям, а также обработки, что накладывает определенные требования к производительности.
В то время, как при производстве накопителей используется множество других метрик, чтоб описать и гарантировать должную производительность, на рынке систем хранения и дисковых накопителей, принято использовать IOPS, как сравнительную метрику, с целью «удобства» сравнения. Однако производительность систем хранения, измеряемая в IOPS (Input Output Operations per Second), операциях ввода / вывода (записи / чтения), подвержена влиянию большого множества факторов.
В этой статье я хотел бы рассмотреть эти факторы, чтобы сделать меру производительности, выраженную в IOPS, более понятной.
Начнем с того, что IOPS вовсе не IOPS и даже совсем не IOPS, так как существует множество переменных, которые определяют сколько IOPS мы получим в одних и других случаях. Также следует принять во внимание, что системы хранения используют функции чтения и записи и обеспечивают различное количество IOPS для этих функций в зависимости от архитектуры и типа приложения, в особенности в случаях, когда операции ввода / вывода происходят в одно и тоже время. Различные рабочие нагрузки предъявляют различные требования к операциям ввода / вывода (I/O). Таким образом, системы хранения, которые на первый взгляд должны были бы обеспечивать должную производительность, в действительности могут не справится с поставленной задачей. Читать полностью »