В этой статье я бы хотел рассказать о том, как именно работает метод анализа главных компонент (PCA – principal component analysis) с точки зрения интуиции, стоящей за ее математическим аппаратом. Максимально просто, но подробно.
Читать полностью »
В этой статье я бы хотел рассказать о том, как именно работает метод анализа главных компонент (PCA – principal component analysis) с точки зрения интуиции, стоящей за ее математическим аппаратом. Максимально просто, но подробно.
Читать полностью »
Приветствую, %username%. Сегодня я расскажу о такой вещи, как коллаборативная фильтрация для сравнения двух наборов данных. После разработаем скрипт составления рейтинга схожести интересов между людьми.
Заинтересовались? Прошу под кат
Приветствую, %username%. Сегодня разработаем скрипт составления рейтинга схожести интересов между людьми.
Заинтересовались? Прошу под кат
Недавно я опубликовал пост, рассказывающий, как можно просто начать использовать наше API. Мне самому захотелось поиграться с данными, которые можно из него получить, и я решил написать приложение, рекомендующее актуальные вакансии на основе информации из резюме. В конце статьи будет ссылка на результат, где каждый сможет получить список рекомендаций по своему резюме.
Читать полностью »
 Это третья статья в цикле про создание и использование скриптов для веб-скрейпинга при помощи Node.js.
В первой статье разбирались базовые аспекты веб-скрейпинга, такие как получение и парсинг страниц, рекурсивный проход по ссылкам и организация очереди запросов. Во второй статье разбирались анализ сайта, работающего через Ajax, тонкая настройка очереди запросов и обработка некоторых серверных ошибок.
Также во второй статье затрагивалась тема инициализации сессий, но, там речь шла о предельно простом случае, когда достаточно выполнить один дополнительный запрос и сохранить куки.
В этой статье разбирается более сложный случай – инициализация сессий с авторизацией по логину и паролю и с преодолением довольно изощрённой защиты от ботов. Как обычно, на примере реальной (и весьма популярной среди скрейперов) задачи.
В большинстве случаев защита от ботов на сайте направлена не против скрейперов, а против таких вещей, как мошенничество, накрутки или спам в комментариях. Однако это всегда лишний повод задуматься о легальности и этичности скрейпинга именно этого сайта. В этой статье для примера выбран сайт, про который хорошо известно, что его владельцы нормально относятся к скрейпингу (хотя и предпочитают, чтобы он выполнялся через специальный API). Простые правила: если у сайта есть открытый API, значит его владельцы рады скрейперам, а если сайт большой и ультрапосещаемый, нагрузка от скрейпинга в обход API его особо не побеспокоит.
В прошлых статьях целью было показать весь процесс создания и использования скрипта от постановки задачи и до получения конечного результата. В этой статье большая часть аспектов веб-скрейпинга обходится стороной, а вместо этого показывается многообразие подходов к решению одной, довольно узкой задачи. Различные методы и инструменты, их плюсы и минусы, субъективные оценки, примеры кода, вот это вот всё.
В Москве больше 2000 детских садов. В очередь на зачисление можно встать в несколько. Какие садики выбрать и какой указать приоритетным? На днях я сделал попытку дать ответ на этот вопрос.
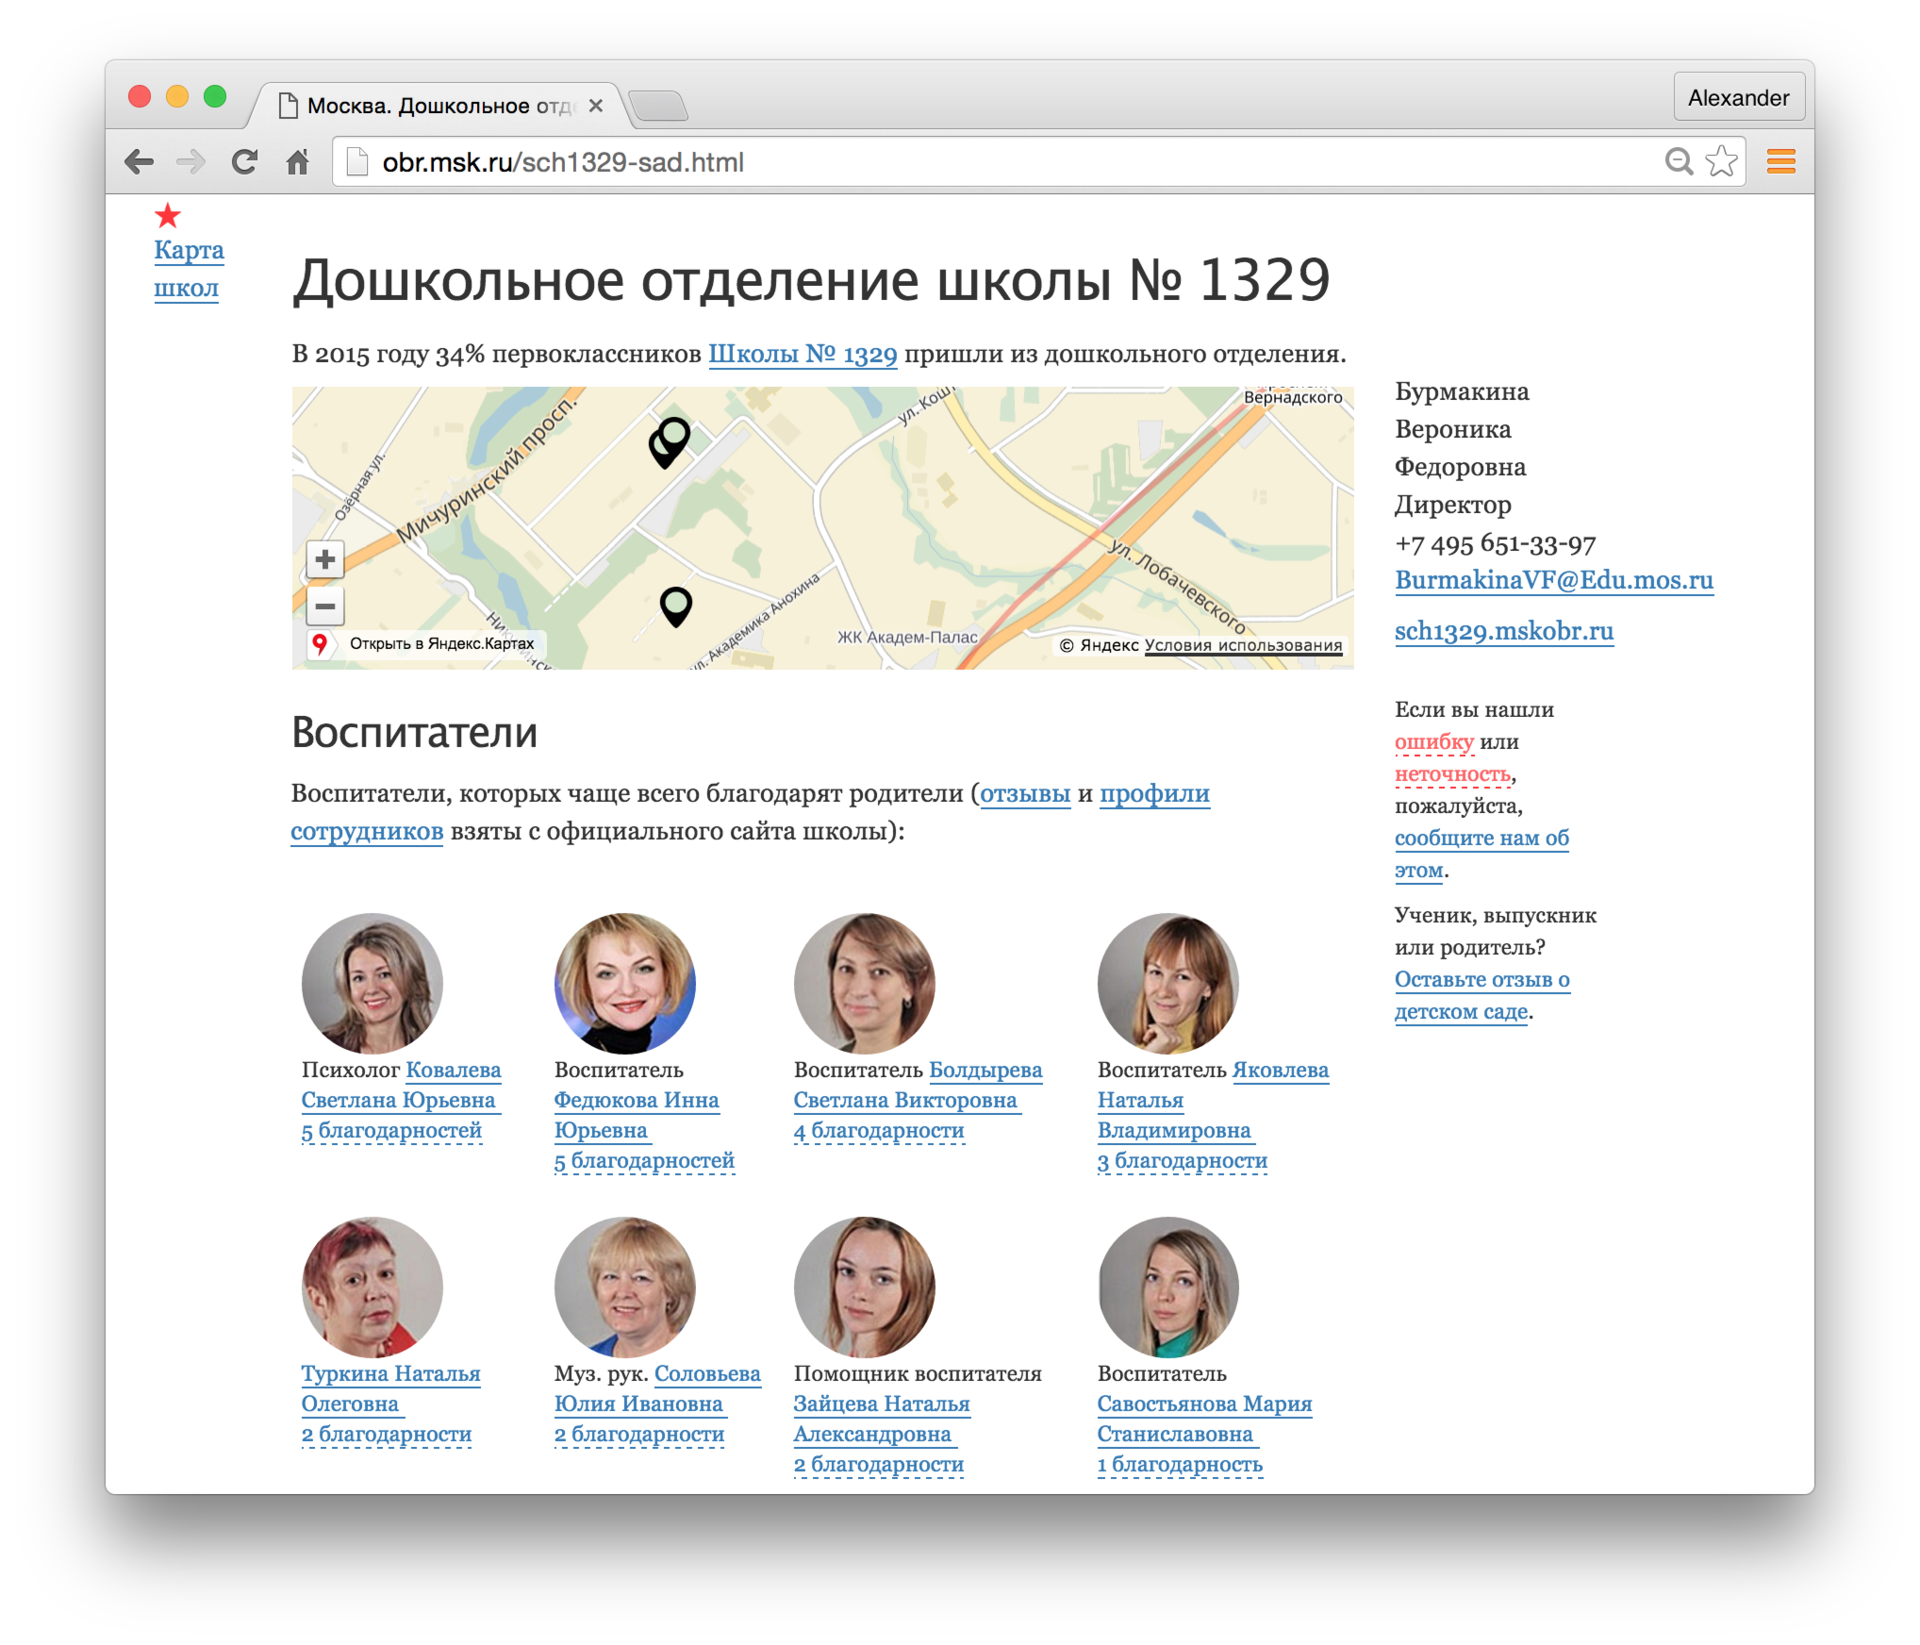
Хотел бы рассказать про некоторых технические детали решения. В ходе работы со школьными данными я заметил, что на сайтах школ публикуется много отзывов. У этих данных есть 4 особенности:
Поэтому появилась идея сделать вот что:
Читать полностью »
Как чуден и глубок русский курлык
— Генератор постов
Обработка естественного языка (natural language processing, NLP) — тема, на мой взгляд, очень интересная. Во-первых, задачи тут чисто алгоритмические: на вход принимаем совершенно примитивный объект, строчку, а извлечь пытаемся вложенный в него смысл (ну или хотя бы частичку смысла). Во-вторых, необязательно быть профессиональным лингвистом, чтобы решать эти задачи: достаточно знать родной язык на более-менее приличном уровне и любить его.
А ещё с небольшими затратами можно сделать какого-нибудь бестолкового чат-бота — или, как вот я, генератор постов на основе того, что вы писали на своей страничке в соцсети. Возможно, кто-то из вас уже видел это приложение — оно довольно глупое, чаще всего выдает бессмысленный и бессвязный текст, но изредка всё же дает повод улыбнуться.
Бессвязность текстов в нынешней версии «Генератора» вызвана тем, что на самом деле никакого анализа он производить не умеет. Просто в одних случаях «предсказывает» продолжение предложения по собранным биграммам, а в других — заменяет в готовом предложении некоторые слова на другие, которые заканчиваются похоже. Вот и вся начинка.
Конечно, хочется сделать что-нибудь поинтереснее. Беда в том, что модные сейчас нейросети не очень-то применимы здесь: им нужно много ресурсов, большую обучающую выборку, а в браузере у пользователя соцсети всего этого нет. Поэтому я решил изучить вопрос работы с текстами с помощью алгоритмов. К сожалению, готовых инструментов для работы с русским языком на JavaScript найти не удалось, и я решил сделать свой маленький велосипед.
Читать полностью »
Однажды, мне стало интересно: насколько статьи на Хабре связаны между собой? Поэтому сегодня мы займемся исследованием связности статей, и конечно не только посчитаем численные метрики, но и увидим картину целиком.
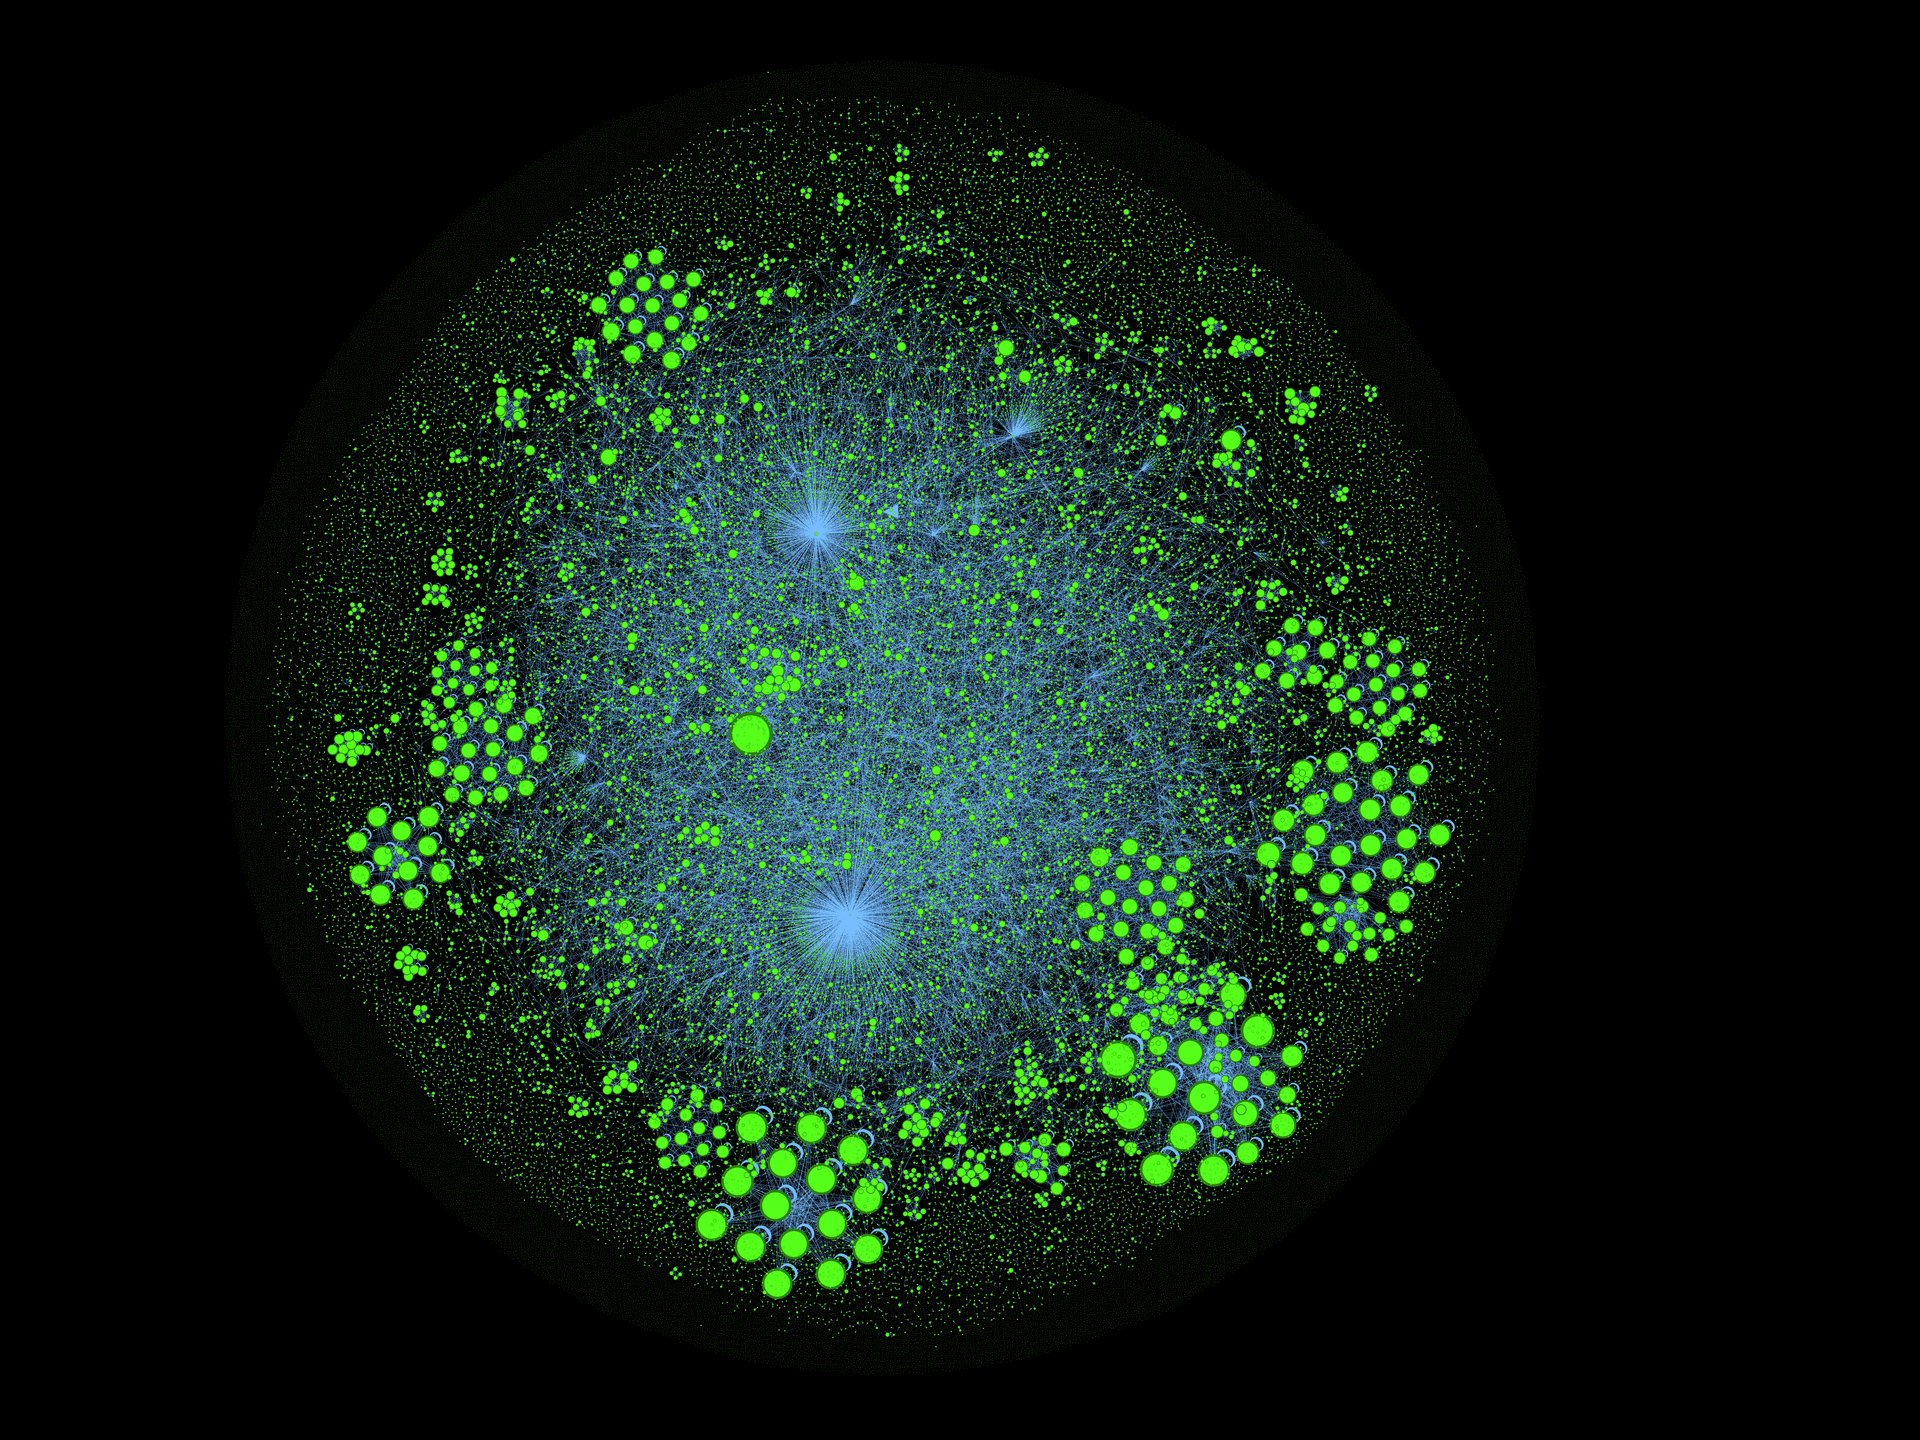
(это не просто картинка для привлечения внимания, а граф цитирования статей внутри Хабрахабра, где размер вершин определяется числом входящих рёбер, i.e., "количеством цитат внутри Хабра")
Началось всё с того, что в комментариях к статье про Хабра-граф и карму Tiberius и Loriowar озвучили идею, фактически витающую в воздухе: а почему бы не взглянуть на граф цитирования статьёй внутри самого Хабра?
Вы спрашивали? Мы отвечаем. Для того чтобы рассказ не был размахиванием рук, конкретизируем разбираемые вопросы:
Q1: Как выглядит граф цитирования Хабрахабра и какие в нём хабы (hubs and authorities)?
Q2: Насколько связным является сообщество (граф цитирования) и какие в нём кластеры?
Под катом трафик. Все картинки кликабельны.
Привет!
В 2014 году мы совместно с несколькими министерствами и ведомствами дали старт мониторингу трудоустройства российских вузов, результаты которого были опубликованы в 2015 году на портале http://graduate.edu.ru/.
Мониторинг проводился среди выпускников 2013 года (у них было достаточно времени, чтобы найти работу). Сейчас идет работа над мониторингом выпускников 2014 года и мы решили рассказать вам о целях и результатах прошлогоднего проекта. Если вам интересно узнать, как размер зарплаты и успех трудоустройства зависит от вуза, специальности и региона, добро пожаловать под кат.
Читать полностью »
Команда Retail Rocket использует узкоспециализированный стек технологий Hadoop + Spark для вычислительного кластера, о котором мы уже писали обзорный материал в самом первом посте нашего инженерного блога на Хабре.
Готовых специалистов для таких технологий найти довольно сложно, особенно, если учесть, что программируем мы исключительно на Scala. Поэтому я стараюсь найти не готовых специалистов, а людей, имеющих минимальный опыт работы, но обладающих большим потенциалом. Мы берем даже людей с частичной занятостью, чтобы было удобно совмещать учебу и работу, если кандидат — студент последних курсов.