Рубрика «python» - 126

Нередко при работе с Bitrix24 REST API возникает необходимость быстро получить содержимое определенных полей всех элементов какого-то списка (например, лидов). Традиционный способ для этого - обращение к серверу через метод *.list (например, crm.lead.list для лидов) с параметром select, перечисляющим список требуемых полей.

Однако в силу того, что информация сервером выдается постранично, существует несколько стратегий для того, чтобы получить весь список, и некоторые из них позволяют ускорять процесс на порядки по сравнению с последовательным запросом страниц.
Стратегии

Читать полностью »

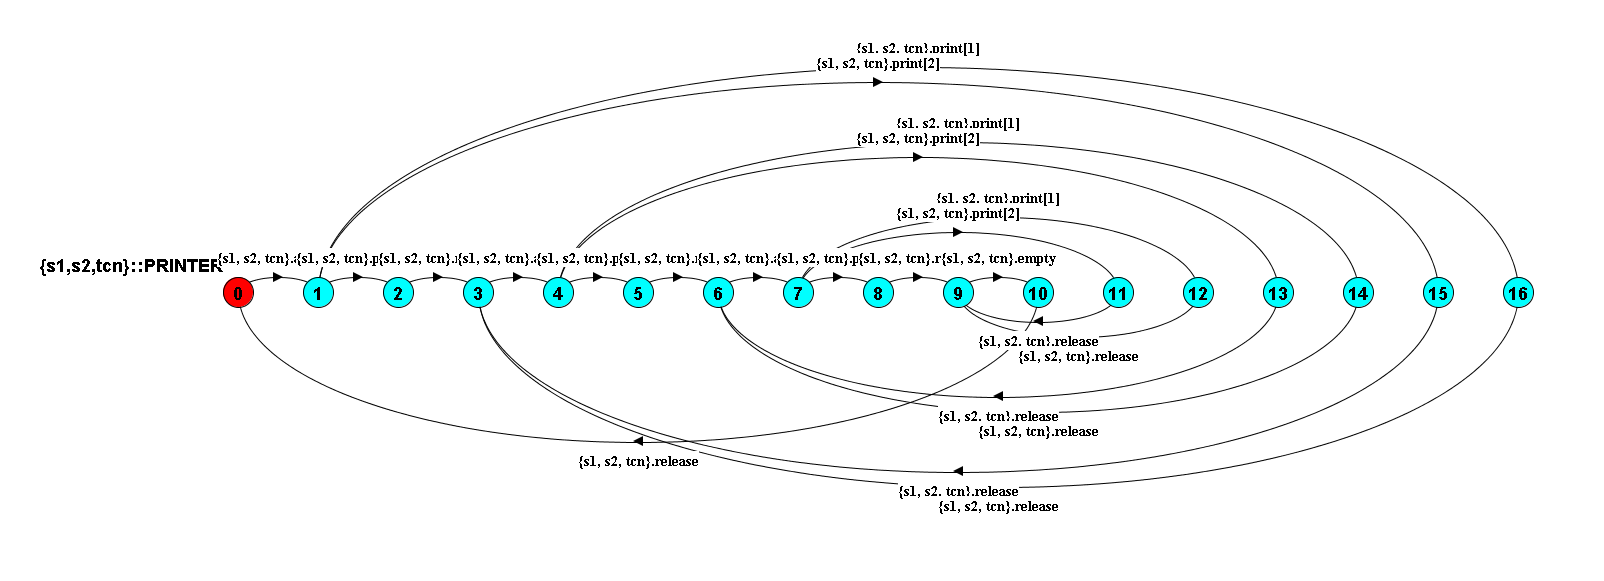
Делаем систему параллелизма надёжнее

Сегодня посмотрим как смоделировать программу с конкурентностью на FSP. Сначала давайте разберемся, зачем вообще нужна конкурентность. Вот что можно сделать с её помощью:

  • Повысить производительность многопроцессорного железа, это и называется параллелизм;
  • Увеличить пропускную способность приложения (вызову ввода-вывода нужно блокировать только один поток);
  • Сделать приложение отзывчивее за счёт выполнения основных задач параллельно фоновым (высокоприоритетный поток для запросов пользователей);
  • Структурировать программу, повысив её эффективность (взаимодействующие со средой программы управляют несколькими действиями и обрабатывают несколько событий).

Строим надёжную конкурентность с FSP и моделированием процессов - 1


Сгенерированная инструментом LTSA диаграмма состояний
Читать полностью »

image

Всем привет! Пока киберпанк еще не настолько вошел в нашу жизнь, и нейроинтерфейсы далеки от идеала, первым этапом на пути к будущему манипуляторов могут стать LiDAR. Поэтому, чтобы не скучать на праздниках, я решил немного пофантазировать на тему средств управления компьютером и, предположительно, любым устройством, вплоть до экскаватора, космического корабля, дрона или кухонной плиты.
Читать полностью »

image

image
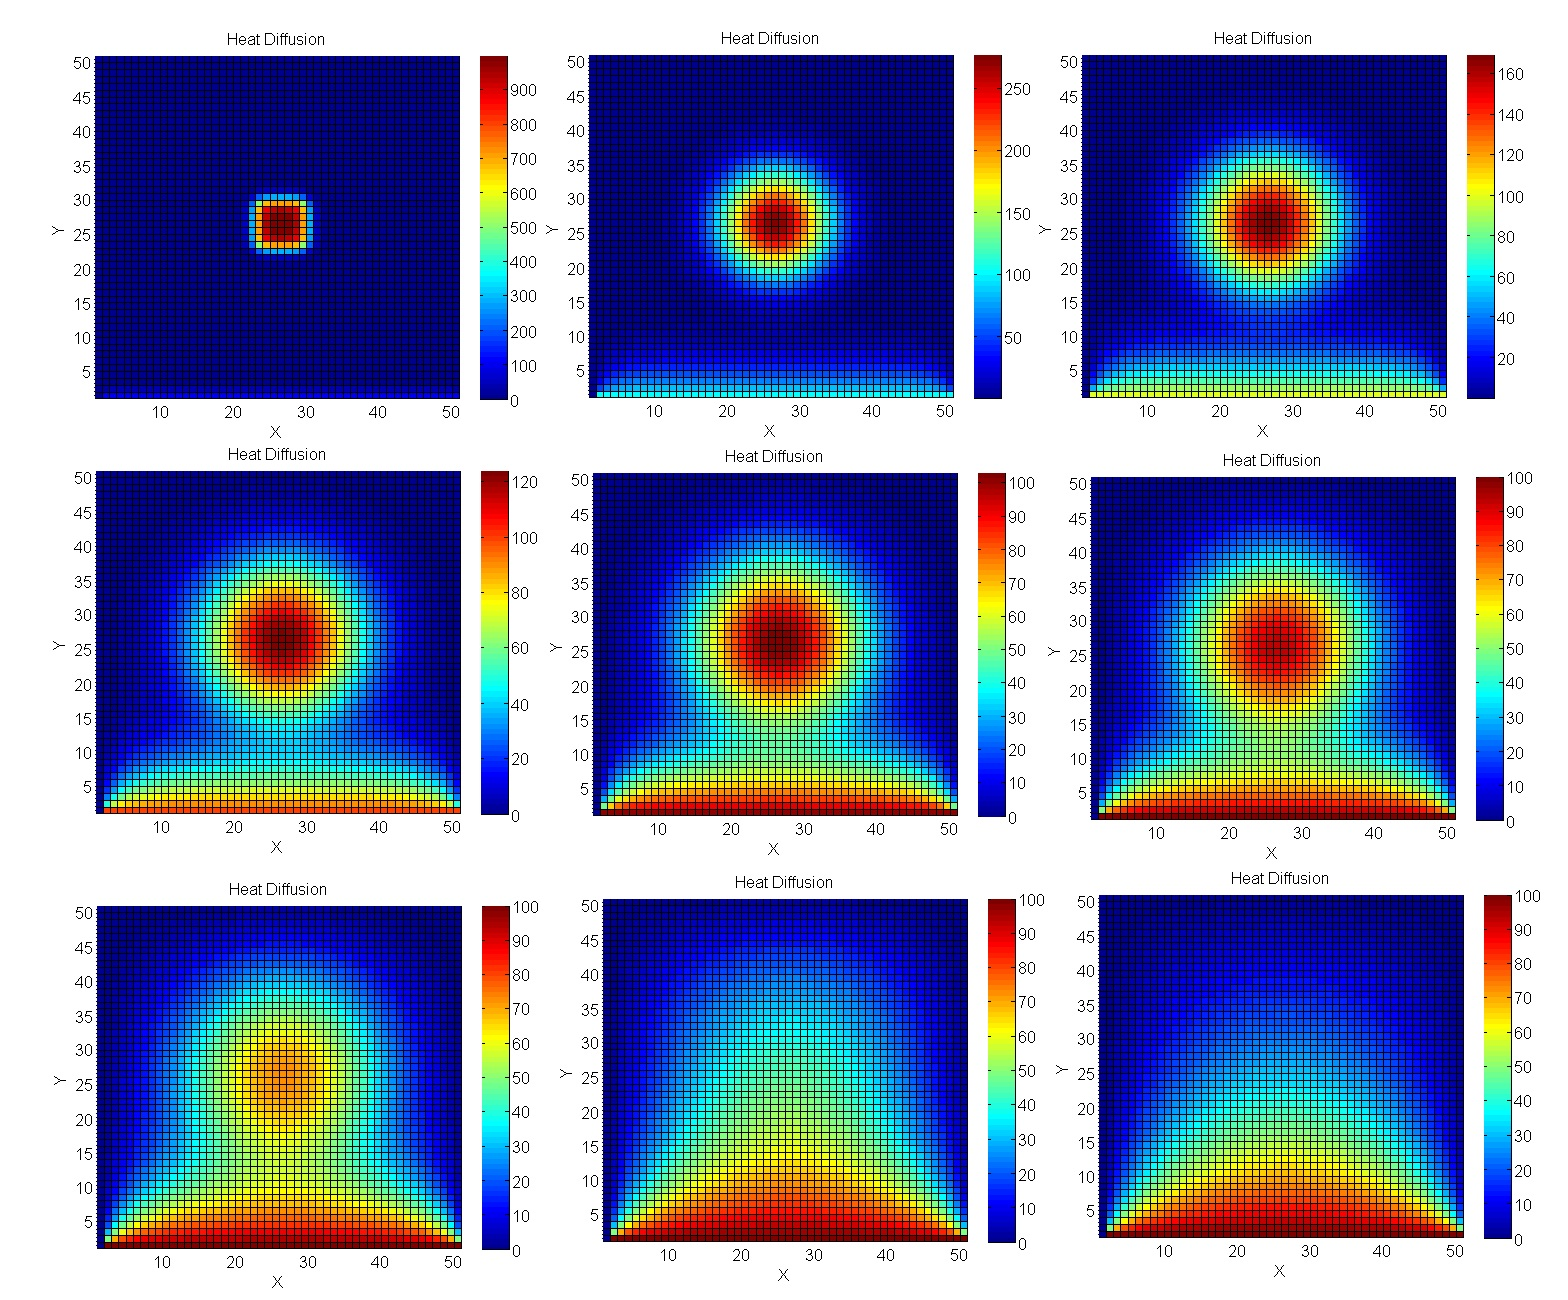
Будем греть металлические пластины на GPU

Все знают, что Python не блещет скоростью сам по себе. На мой взгляд язык прекрасен своей читабельностью, но основная ниша его применения там, где вы большую часть времени ожидаете ввода/вывода каких-то данных. Условно, вы можете написать суперпроизводительный код на Rust или С, но 99% времени он будет просто ждать.

Тем не менее, Python прекрасен еще и как высокоуровневый синтаксический клей. В этом случае, его неторопливая интерпретируемая часть вызывает быстродействующий код, написанный на компилируемых языках программирования. Обычно для этого используются такие традиционные библиотеки как NumPy.

Но мы пойдем чуть дальше попробуем распараллелить вычисления на CUDA и задействуем странный, но работающий гибрид C++, stdpar и компилятора nvc++ от Nvidia. Ну и заодно попробуем оценить быстродействие. Возьмем две задачи: сортировку чисел и метод Якоби, которым будем рассчитывать нагрев металлической пластины.
Читать полностью »

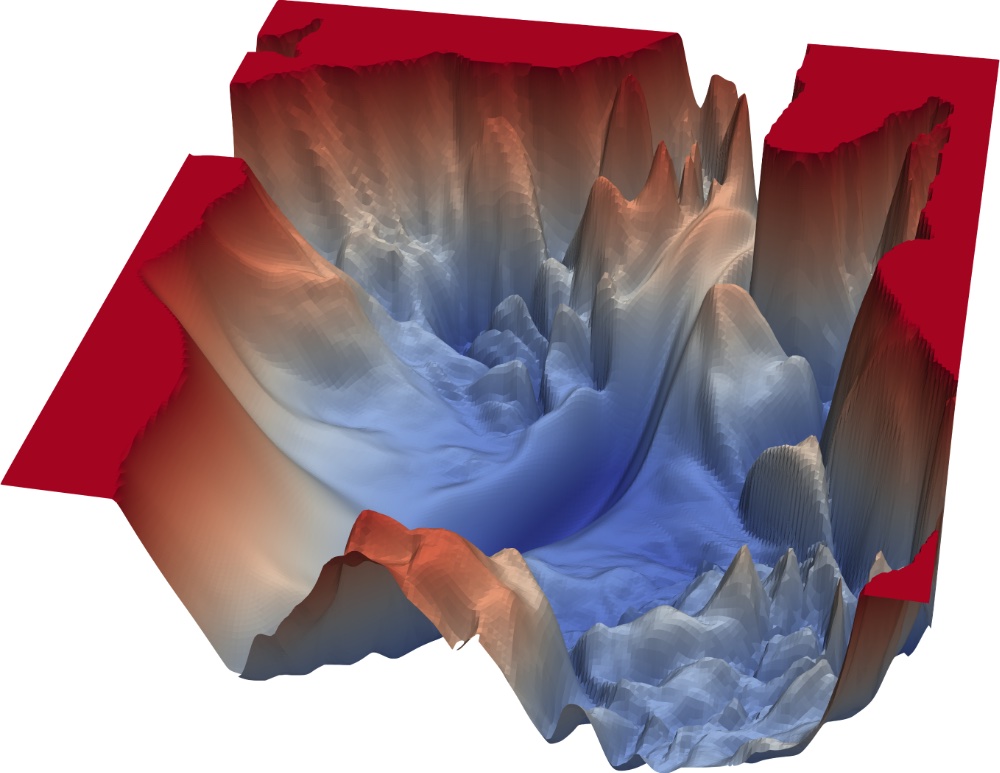
Во время изучения различных алгоритмов машинного обучения я наткнулся на ландшафт потерь нейронных сетей с их горными территориями, хребтами и долинами. Эти ландшафты потерь сильно отличались от выпуклых и гладких ландшафтов потерь, с которыми я столкнулся при использовании линейной и логистической регрессий. Здесь мы создадим ландшафты потерь нейронных сетей и анимированного градиентного спуска с помощью датасета MNIST.

Анимации градиентного спуска и ландшафта потерь нейронных сетей на Python - 1


Рисунок 1 — Ландшафт потерь свёрточной нейронной сети с 56 слоями (VGG-56, источник)
Читать полностью »

В этой статье я хочу продемонстрировать R Markdown — удобную надстройку для программирования вашего проекта как на R, так и на Python, позволяющую программировать некоторые элементы вашего проекта на двух языках и управлять объектами, созданными на одном языке, с помощью другого языка. Это может быть полезно потому, что:

  1. Позволяет писать код на привычном языке, но при этом использовать функции, существующие только в другом языке.
  2. Позволяет напрямую сотрудничать с коллегой, который программирует на другом языке.
  3. Даёт возможность работать с двумя языками и со временем научиться свободно владеть ими.

Как быть билингвом в Data Science - 1


Читать полностью »

Хочу поделиться методами освоения Data science с нуля человеком из другой ИТ специальности. Цель: дать понять, подходит ли Вам эта специальность в принципе, и рассказать про эффективные подходы к самообучению, которые мне помогли (отдельно планирую потом детальные статьи по отдельным темам).

Отличные материалы уже существуют по большинству конкретных тем, я сам по ним учился.
Читать полностью »

Алгоритмы по детекции лиц плотно вошли в нашу жизнь, хотя и не все это замечают. Началось всё в 2015 году со сферы развлечений. Стартап Looksery, занимающийся разработкой AR-фильтров, был куплен Snapchat. Приложение распознавало лицо человека на фотографии и накладывало на него весёлые рожицы. Чуть позже, в начале 2016 года, Facebook купил белорусский стартап MSQRD и запустил маски в Facebook Stories. Но это можно считать только обкаткой таких технологий.

В этой статье можно прочитать, как используются системы идентификации, узнать про слабые места компьютерных алгоритмов, а также попробовать запустить нейронную сеть по детекции и идентификации лиц на собственном компьютере.

Нейросети в большом городе. Разбираемся, как они помогают идентифицировать людей, и запускаем собственную нейросеть - 1


Читать полностью »

Модели глубокого обучения улучшаются с увеличением количества данных и параметров. Даже с последней моделью GPT-3 от Open AI, которая использует 175 миллиардов параметров, нам ещё предстоит увидеть плато роста количества параметров.

Для некоторых областей, таких как NLP, рабочей лошадкой был Transformer, который требует огромных объёмов памяти графического процессора. Реалистичные модели просто не помещаются в памяти. Последний метод под названием Sharded  [букв. ‘сегментированный’] был представлен в Zero paper Microsoft, в котором они разработали метод, приближающий человечество к 1 триллиону параметров.

Специально к старту нового потока курса по Machine Learning, делюсь с вами статьей о Sharded в которой показывается, как использовать его с PyTorch сегодня для обучения моделей со вдвое большей памятью и всего за несколько минут. Эта возможность в PyTorch теперь доступна благодаря сотрудничеству между командами FairScale Facebook AI Research и PyTorch Lightning.

Как экономить память и удваивать размеры моделей PyTorch с новым методом Sharded - 1


Читать полностью »

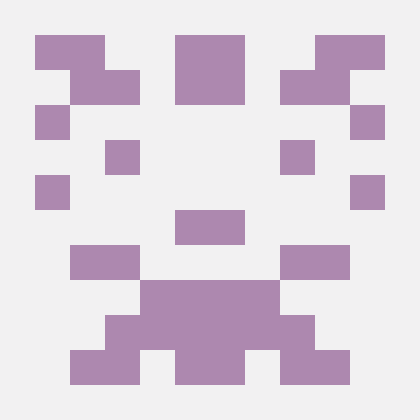
В данной статье я покажу и расскажу, как можно сгенерировать аватарки как на Github.

Результат генерации для ника "test1"

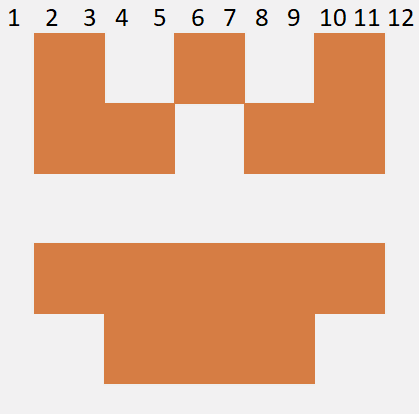
Для начала нужно понять, как устроена аватарка с Github'а. На первый взгляд, это просто случайный набор закрашенных квадратов (далее, блоков) в удачном порядке на сером фоне.

Сколько квадратов в аватарке

Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js