
Среди всего многообразия задач Computer Vision есть одна, которая стоит особняком. К ней обычно стараются лишний раз не притрагиваться. И, если не дай бог работает, — не ворошить.
У неё нет общего решения. Практически для каждого применения существующие алгоритмы надо тюнинговать, переобучать, или судорожно копаться в куче матриц и дебрях логики.

Статья о том как делать трекинг. Где он используется, какие есть разновидности. Как сделать стабильное решение.
Читать полностью »
Рубрика «python» - 137
Самая сложная задача в Computer Vision
2020-06-15 в 8:03, admin, рубрики: computer vision, CoW, DeepSORT, fish, machine learning, MOT, python, ReID, Reindentification, sort, ssd, Tracking, yolo, YOLOv4, YOLOv5, Блог компании Recognitor, искусственный интеллект, машинное обучение, обработка изображенийАдаптивное разбиение кривых Безье 2-го и 3-го порядка
2020-06-14 в 19:39, admin, рубрики: python, аппроксимация, векторная графика, кривые безье, Программирование, Работа с векторной графикой
Уже год как я сменил работу на новую. В этой статье я хочу поделиться опытом, накопленным на прошлом месте. Здесь рассмотрены методы аппроксимации кривых Безье, а также обработка исключительных случаев, при которых простые алгоритмы показывают себя не очень хорошо. Все, кому близка тема векторной графики — прошу под кат.
Пока, Python. Привет, Julia❗
2020-06-14 в 19:12, admin, рубрики: edisonsoftware, python, Блог компании Edison, высокая производительность, ПрограммированиеПо мере того, как Python замедляет свой впечатляющий темп, растёт новый сильный конкурент.
Не поймите меня превратно. Популярность Python по-прежнему обеспечивается сообществом ученых, дата-сайентистов и специалистов по искусственному интеллекту.
Но если вы когда-либо обедали с этими людьми, то также знаете, как любят они обсудить слабости Python. Начиная с медлительности и заканчивая необходимостью чрезмерного тестирования, вплоть до появления ошибок времени выполнения, несмотря на предшествующее скрупулёзное тестирование — это кого хочешь разозлит.
Поэтому всё больше программистов-питонщиков осваивают и другие языки — лучшими игроками на этом поле являются Julia, Go и Rust. Julia отлично подходит для математических и технических задач, Go — для модульных программ, а Rust — лучший выбор для системного программирования.
Поскольку эксперты по данным и ИИ занимаются множеством математических задач, чаще всего они выбирают Julia. И даже после самой суровой проверки у Julia обнаруживаются свои плюсы, которые Python не может победить.Читать полностью »
Красивая и подробная геологическая карта Марса, сделанная на Python, GDAL
2020-06-14 в 14:35, admin, рубрики: data viz, GDAL, maps, Pyhon, python, science art, астрономия, визуализация данных, графический дизайн, дизайн, карты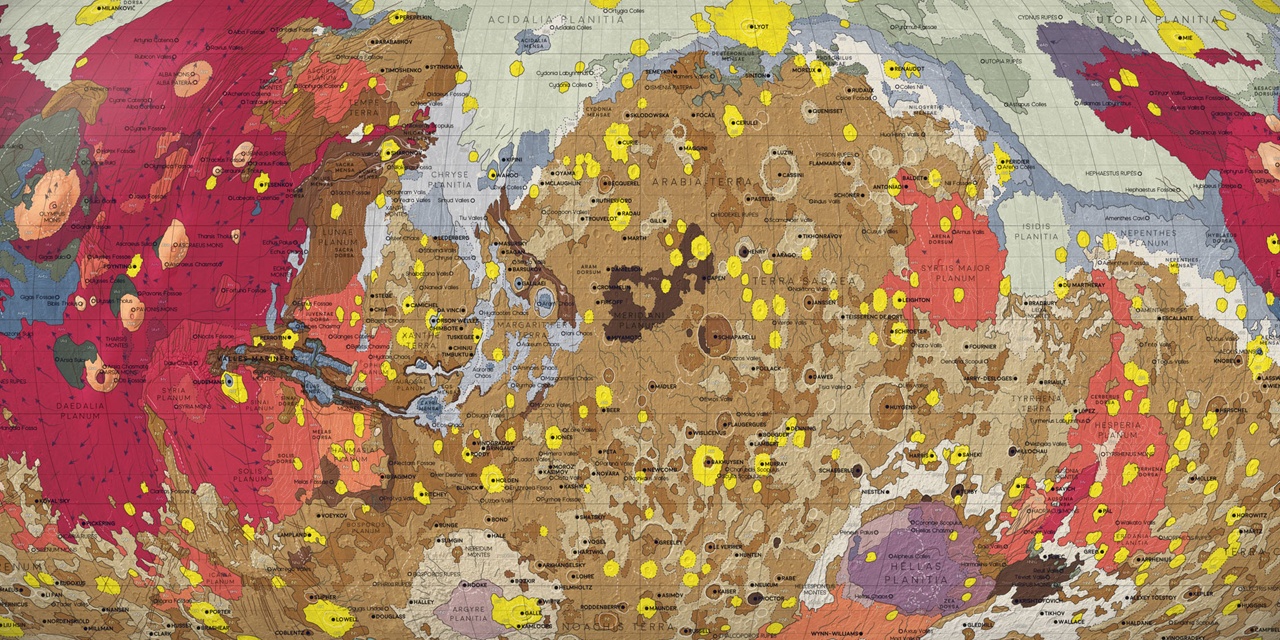
На этой неделе — творческое переосмысление геологической (или все же ареологической?) карты Марса на основе карты, сделанной USCS. Использовалась те же геологические данные, что и для оригинальной, но было добавлено больше топонимов и подписей, проведен редизайн визуального стиля, а термины из легенды карты упрощены для общего понимания.
Параллелизм и эффективность: Python vs FSM
2020-06-14 в 8:42, admin, рубрики: c++, FSM, python, qt, автоматное программирование, параллельное программирование, С++Признаюсь, но я не знаю Python. Просто потому, что не использую. Тем не менее, взявшись за его освоение, а также в попытках расшифровать загадочную аббревиатуру GIL, вышел на статью с описанием «необъяснимых магических явлений» параллельного варианта CPU-зависимой функции на Python. Возникло желание перепроверить данный тест и сравнить с эквивалентной реализацией в форме модели конечного автомата (Finite-state machine или сокращенно FSM) в среде Визуального Компонентного Программирования (автоматного) — ВКП(а).
Очевидно любая программа в определенной мере CPU-зависима. С другой стороны, если это только не ассемблер, то тестированием на том или ином языке высокого уровня мы в большей степени исследуем программную прослойку, скрываемую им. Поэтому, рассматривая Python, правильнее было бы говорить о CPU-зависимости его интерпретатора. Можно даже утверждать, что программа на Python будет иметь скорость, зависимую от версии интерпретатора, и обладать характерной для него «мистикой».
В то же время есть ситуации, когда зависимости от CPU может почти не быть (в этом мы убедимся). Речь идет о языках, вычислительная модель которых отлична от типовой архитектуры процессоров. Вычислительная модель Python, ей соответствует, а автоматная модель вычислений, о которой далее пойдет речь, имеет другую архитектуру и это будет определять специфику ее тестирования. Какая будет скорость и будет ли иметь место мистика выяснится в процессе тестирования «автоматного кода».
Читать полностью »
Спасите пароль: сказочная реализация схемы разделения секрета Шамира на Python
2020-06-13 в 6:40, admin, рубрики: python, Блог компании VDSina.ru — хостинг серверов, информационная безопасность, Научно-популярное, пароли, ПрограммированиеЭтот алгоритм, использующий язык Python и Схему разделения секрета Шамира, защищает ваш мастер-пароль от хакеров и вашей собственной забывчивости.
Для безопасного хранения множества уникальных паролей многие из нас используют менеджеры паролей. Вся их работа по сути завязана на мастер-пароле. Этот пароль защищает все остальные пароли, и, таким образом, несёт весь риск на себе. Любой, кто подберёт его или получит к нему доступ, может притвориться вами в самый неподходящий момент. Естественно, вы стараетесь сделать свой мастер-пароль максимально сложным, а затем запоминаете или где-то ещё фиксируете его.
Читать полностью »
Как починить все самому, если баг-репорты игнорируются: отлаживаю wkhtmltopdf под Windows
2020-06-10 в 11:14, admin, рубрики: c++, open source, PDF, python, wkhtmltopdf, Блог компании RUVDS.com, Разработка веб-сайтов, С++wkhtmltopdf — это один из самых мощных инструментов для генерации PDF. Он позволяет использовать в генерируемом документе все возможности HTML и CSS. «Под капотом» у него движок WebKit, так что результат почти в точности соответствует выводу «Print to PDF», встроенному в Chrome. Судя по вопросам на Stack Overflow, wkhtmltopdf используется для генерации карт, графиков, бухгалтерских отчётов, подарочных сертификатов, и практически любого другого контента, который в конечном счёте должен оказаться распечатанным на бумаге.
Мой давний заказчик с помощью wkhtmltopdf генерирует PDF-инвойсы в своём веб-магазине. При печати в «шапке» инвойса должен отображаться чёрно-белый логотип, тогда как на сайте используется цветной. Очевидное решение — подменить изображение в CSS @media print { ... } Но тут обнаружилась проблема: если изображение не используется вне @media print, то оно не загружается и при печати (этот баг можно заметить и в окне Print Preview самого Chrome).Читать полностью »
Почему список в кортеже ведет себя странно в Python?
2020-06-10 в 7:56, admin, рубрики: python, Блог компании ДомКлик, отладка, Программирование, разработкаВ языках программирования меня всегда интересовало их внутреннее устройство. Как работает тот или иной оператор? Почему лучше писать так, а не иначе? Подобные вопросы не всегда помогают решить задачу «здесь и сейчас», но в долгосрочной перспективе формируют общую картину языка программирования. Сегодня я хочу поделиться результатом одного из таких погружений и ответить на вопрос, что происходит при модификации tuple'а в list'е.
Читать полностью »
Как обработать датафрейм с миллиардами записей за считанные секунды?
2020-06-06 в 17:00, admin, рубрики: python, Vaex, Блог компании RUVDS.com, разработка, Разработка веб-сайтовАнализ больших данных в Python переживает эпоху возрождения. Она началась с библиотеки NumPy. Эта библиотека, кстати, является одной из составных частей тех инструментов, о которых пойдёт речь в этом материале. В 2006 году тема обработки больших данных постепенно набирала обороты, этот процесс ускорился с появлением Hadoop. Потом появилась библиотека pandas со своими структурами данных DataFrame, которые обычно называют просто «датафреймами». В 2014 году большие данные стали мейнстримом, в этом же году появилась платформа Apache Spark. В 2018 году вышла библиотека Dask и другие средства для анализа данных в Python.
Каждый месяц мне попадаются новые инструменты для анализа данных в Python, которые мне очень хочется освоить. Потратив час-другой на их изучение, можно, в долгосрочной перспективе, сэкономить немало времени. Кроме того, важно следить за тем новым, что происходит в интересующей тебя сфере технологий. Возможно, вы полагаете, что эта статья будет посвящена библиотеке Dask. Но это не так. Сегодня я расскажу вам об одной недавно обнаруженной мной Python-библиотеке, о которой стоит знать тем, кто занимается анализом данных.
Читать полностью »
Интервальное прогнозирование временных рядов с помощью рекуррентных нейронных сетей с долгой краткосрочной памятью…
2020-06-06 в 15:56, admin, рубрики: keras, LSTM, python, time-series forecasting, машинное обучение, прогнозирование временных рядов, рекуррентная нейронная сетьПродолжение цикла публикаций статей про прогнозирование временных рядов. На повестке – перевод статьи How to Develop Multi-Step LSTM Time Series Forecasting Models for Power Usage.
Читать полностью »